双非零基础转行AI应用开发工程师,需要哪三项硬实力?
双非背景转行AI,AI应用开发工程师是最可行赛道,核心是微调实操、框架开发与工程化部署三项硬实力。
本文整理了一位B站AI从业者分享的转行经验,指出对于普通本科/双非学历的求职者,与其竞争门槛极高的算法岗,不如瞄准更注重落地能力的AI应用开发工程师方向。该赛道有三项核心硬实力:一是大模型微调实操,需亲手跑过LoRA/SFT完整项目;二是基于LangChain等框架的工程化开发,要掌握Milvus向量数据库、知识图谱等组件,而非止步于低代码工具;三是模型推理与工程化部署能力,包括vLLM/TensorRT加速和FastAPI服务封装,能把模型变成稳定运行的业务服务。文章最后提醒,视频后段含明显课程推广内容,速成承诺应理性看待,扎实基础与完整实战项目才是真正入门的路径。
普通本科、双非学历,想踏入AI行业还有机会吗?答案是有的,而且存在一条相对明确的赛道——AI应用开发工程师。
竞争激烈的AI算法岗位,绝大多数普通背景的求职者确实很难挤进去。但AI应用开发不同,只要实战能力达标,同样可以拿到offer,甚至有机会进入大厂。当下企业真正缺的,是能把技术落地、能干活的开发人员。本文基于B站一位AI从业者分享的转行经验,梳理这条赛道对应的核心能力要求,供正在迷茫的人参考。
硬实力一:大模型基础原理与微调实操
网上有不少言论说微调(Fine-tuning)没必要,容易把模型调坏。但把这套逻辑放到实际面试场景,情况恰恰相反——没有微调实操经历,简历很可能直接被筛掉。
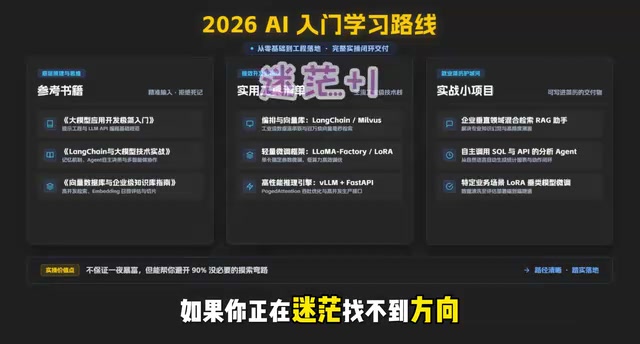
这里要区分清楚:企业并不要求你从零训练一个大模型,这既不现实也没必要。真正要掌握的是LoRA、SFT(监督微调)相关的参数调整、训练数据集的搭建与配置。关键不在于理论背得多熟,而在于是否亲手跑过一个完整的微调项目——从数据准备、参数设置到训练验证的全流程。这段经历是简历上区分「看过教程」和「真正做过」的分水岭。
LoRA(Low-Rank Adaptation) 是目前最主流的大模型微调方法之一。其核心思想是:不直接修改预训练模型的全部权重(这需要极大的算力和显存),而是在原有权重矩阵旁边插入两个低秩矩阵,只训练这两个小矩阵。这样做的好处是训练参数量可以缩减到原来的千分之一甚至更少,普通消费级GPU(如RTX 3090)也能完成微调,大幅降低了硬件门槛。SFT(Supervised Fine-Tuning,监督微调) 则是指用人工标注的「输入-输出」对话数据对模型进行有监督训练,让模型学会特定任务的回答风格或领域知识,是让通用基础模型变成垂直业务助手的标准路径。两者经常组合使用:先用SFT数据配合LoRA方法微调,再用少量算力迭代优化,是企业内部落地大模型最常见的工程方案。
硬实力二:AI应用开发不等于玩低代码工具
第二个容易踩的坑,是把AI应用开发等同于拖拉拽的低代码工具。视频中给出了一个直白的判断:低代码工具只能用来做演示原型,真正的企业业务靠的是框架开发。
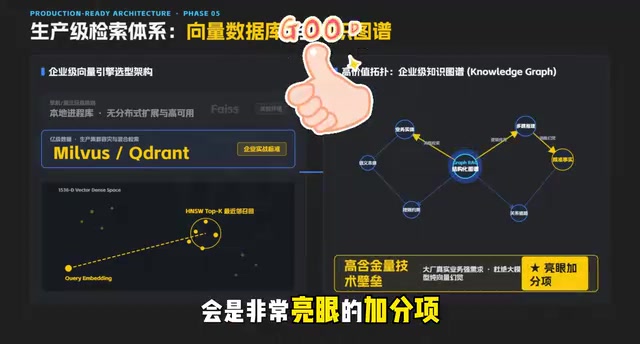
工业界目前主流以LangChain生态为主。一个成熟的AI业务系统,很少依赖单个大模型直接解决全部问题,其本质是一套工程系统。这套系统里,向量数据库是必备组件,数据库架构也需要懂。视频特别强调,不要只停留在用FAISS做实验,企业生产环境更常用Milvus这类向量数据库。
知识图谱是另一个加分维度。中小公司不一定会落地,但掌握这项能力在面试中会非常亮眼,因为大厂对此有真实业务需求。换句话说,把AI应用理解为「一套工程系统」而非「调用一个模型」,是这条赛道的思维起点。
LangChain 是目前最广泛使用的大模型应用开发框架,提供了将大模型与外部工具、数据库、记忆模块串联起来的标准化接口,开发者可以用它快速搭建检索增强生成(RAG)、Agent、多步骤推理等复杂应用。向量数据库 是RAG架构的核心组件:文本先被Embedding模型转换为高维数值向量,存入向量数据库;用户提问时,系统将问题也转为向量,在数据库中做相似度检索,找到最相关的段落后再交给大模型生成答案。FAISS是Meta开源的本地向量检索库,适合实验和小规模验证;Milvus 则是专为生产环境设计的分布式向量数据库,支持百亿级向量的高并发检索、数据持久化和集群部署,是企业实际上线时的主流选择。两者之间的差距,恰恰体现了「能做Demo」和「能上生产」之间的工程鸿沟。
硬实力三:模型推理与工程化部署能力
第三项能力,被视频作者认为是「区分调参工具人和真正AI应用开发工程师」的分界线,即模型推理与工程化部署能力。
具体包括:了解vLLM、TensorRT这类推理加速框架,懂得模型优化提速的方法,能用FastAPI把模型封装成可上线的服务。核心观点是——只有把模型转化成可运行的服务、并与真实业务系统完整对接,才算真正完成落地。
跑出一个效果好看的Demo远远不够。企业买单的是能稳定运行、能承接业务流量的服务,而不是实验室里的漂亮曲线。这一点也解释了为什么工程化能力在求职中权重越来越高:模型能力趋于同质化,落地能力才是稀缺项。
vLLM 是加州大学伯克利分校开源的大模型推理加速框架,核心技术是PagedAttention——将GPU显存像操作系统管理内存一样分页调度,大幅提升并发吞吐量,相比原生HuggingFace推理可快10倍以上,是目前开源社区部署大模型的事实标准之一。TensorRT 是英伟达官方的模型推理优化库,通过算子融合、精度量化(FP16/INT8)等技术将模型压缩并加速,适合在英伟达GPU上追求极致延迟的场景。FastAPI 是Python生态中性能最优的异步Web框架,常被用来将推理好的模型包装成HTTP接口,对外提供标准化的REST API服务。三者组合(vLLM/TensorRT负责加速推理 + FastAPI负责接口封装)构成了AI模型上线的典型工程链路,也是企业招聘时考察「是否真正做过部署」的核心知识点。
转行不是靠一腔热血,而要踩准节奏
视频作者坦言自己也踩过不少坑:买过质量参差的课程、啃过大量专业书籍、反复实操项目,才逐渐梳理出一条清晰的成长路径。转行AI不是仅凭热情就能成事,需要看清方向再行动。
从内容中可以提炼出一个相对完整的学习框架:
打好基础
先补齐必备的数学与编程基础,再进入基础算法与经典模型的学习。这一步没有捷径,也是后续所有工程能力的地基。
选定就业方向
基础之后,就业通常分为两大方向:CV(计算机视觉)与NLP(自然语言处理)。无论选哪个,都需要针对性地学习对应的算法模型,并配套做出可展示的项目。
补齐工程与部署能力
在算法与模型之外,微调实操、向量数据库、推理加速、服务封装等工程能力,是把「会调模型」升级为「能交付系统」的关键环节。
写在最后
这条经验分享的核心价值,在于把AI应用开发工程师的岗位要求拆解成了三项可执行的硬实力:微调实操、框架化工程开发、模型部署上线。相比追逐门槛极高的算法岗,这条赛道对双非、跨专业背景更友好,因为它考核的是落地能力而非纯理论深度。
需要提醒的是,视频后半段包含明显的课程与学习路线图推广内容(评论区领取路线图、团队辅导等),这类信息带有营销性质,读者应理性看待,将其视为方向参考而非「三个月年薪40W」的保证。任何跳过系统积累的速成承诺,都值得保持警惕。真正能带你入门的,仍然是扎实的基础加上完整的实战项目。
相关推荐
Automattic高管在Mullenweg短暂离任期间签署互惠离职协议
Automattic公司CFO Mark Davies与法务负责人Andy Missan在Matt Mullenweg短暂离任期间相互签署离职补偿协议,包含一年薪资与额外股权归属,引发公司治理透明度关注。
H3 Singularity优化技巧:加速40%还能提升画质
Reddit社区分享的Minimax Singularity工作流优化技巧:在H3 Latent前插入RTX上采样器,实现40%加速同时提升画质,附参数取舍与12bit输出实践经验。
X上线Cashtags股票交易功能,社交与市场界限消融
X(原Twitter)宣布向美国用户开放通过Cashtags直接交易的功能,打通市场讨论与实际交易的通道。本文解析这一功能的运作逻辑、社交交易的机遇与风险,以及平台边界扩张背后的趋势。