SO(3)等变核方法:让神经算子真正做到旋转不变

IKNO将SO(3)旋转等变性直接编码进模型结构,以1/5.6的参数量追平通用等变网络精度并彻底消除坐标依赖。
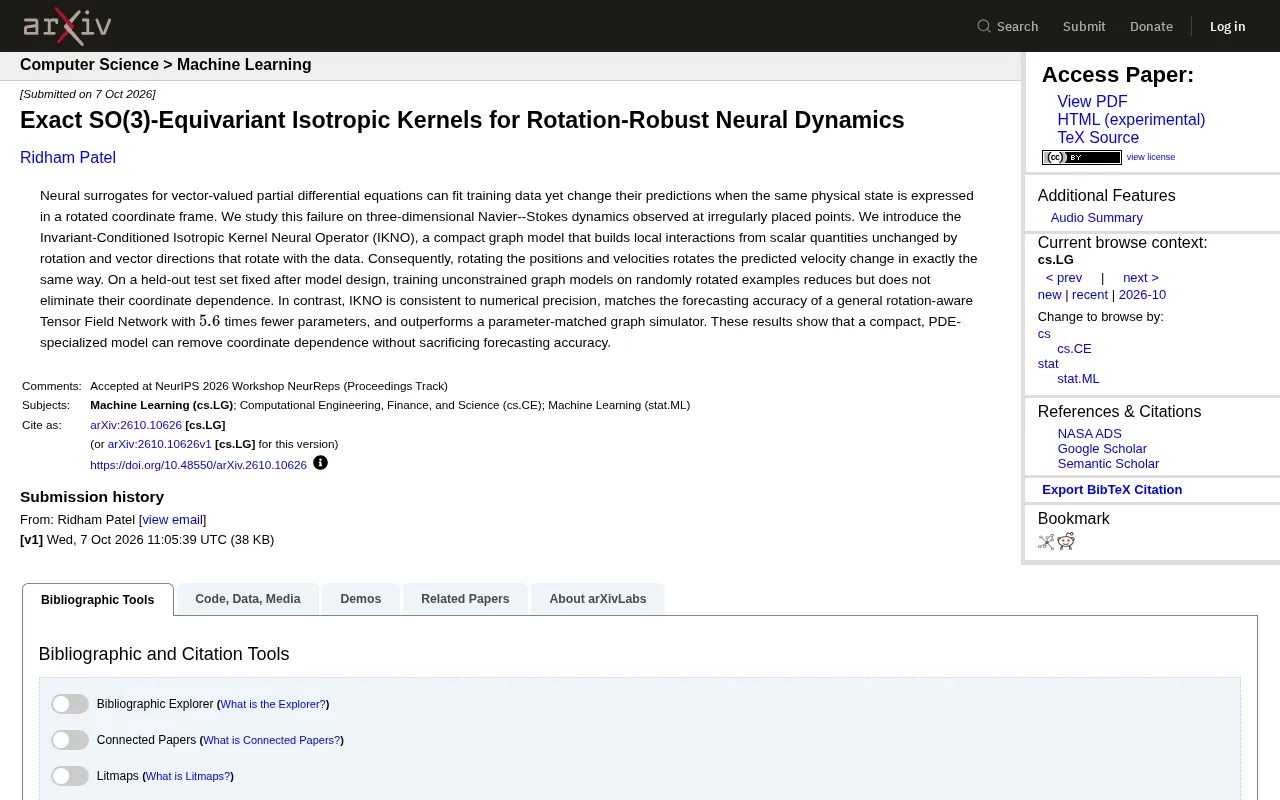
针对神经代理模型在旋转坐标系下预测结果会发生改变这一物理一致性隐患,论文提出了不变条件各向同性核神经算子(IKNO)。实验表明,常用的随机旋转数据增强只能降低而无法消除坐标依赖,真正的解决方案必须来自模型结构本身。IKNO通过旋转不变标量和随数据同步旋转的向量方向构建局部相互作用,在数值精度范围内实现严格SO(3)等变性。在三维Navier–Stokes动力学基准上,IKNO精度追平通用等变架构张量场网络(TFN),但参数量仅为其约1/5.6,同时超越参数量相当的图模拟器。这项工作重申了归纳偏置在科学机器学习中的核心价值:将已知物理对称性直接编码进网络结构,可同时获得精确的物理一致性与更高的参数效率。
一个被忽视的物理一致性难题
用神经网络近似求解偏微分方程(PDE)已经成为科学计算领域的热门方向,这类模型被称为神经代理(neural surrogate)。它们能够拟合训练数据、快速给出预测,但存在一个长期被忽视的隐患:当同一个物理状态用旋转过的坐标系来表达时,模型的预测结果会发生改变。
这显然违背了物理规律。对于真实的流体系统而言,无论你如何旋转观察坐标系,流动的本质动力学都不应该改变。一篇最新的arXiv论文(arXiv:2610.10626)正是针对这一问题展开研究,聚焦于三维Navier–Stokes(纳维-斯托克斯)方程在不规则采样点上的动力学建模。
为什么随机旋转数据增强不够用
面对坐标依赖问题,业界最常见的做法是数据增强——在训练时对样本进行随机旋转,期望模型自己学会旋转不变性。但论文给出的实验结果颇具说服力:在模型设计完成后固定的测试集上,用随机旋转样本训练的无约束图模型虽然降低了坐标依赖,却无法彻底消除它。
这意味着依靠数据增强只是一种近似的、统计意义上的修补,模型本质上仍然可能对坐标系的选择敏感。对于追求物理严谨性的科学计算任务来说,这种残留误差是不可接受的。真正的解决之道应该是从模型结构层面保证旋转等变性,而非靠训练技巧弥补。
IKNO:把旋转对称性写进模型结构
论文提出的核心方法叫做不变条件各向同性核神经算子(Invariant-Conditioned Isotropic Kernel Neural Operator,简称IKNO)。这是一个紧凑的图模型,其设计思路可以概括为:用在旋转下保持不变的标量量,以及随数据一同旋转的向量方向,来构建局部相互作用。
这种构造带来了一个优雅的数学性质:当你旋转输入的位置和速度时,预测出的速度变化会以完全相同的方式旋转。这正是SO(3)等变性的严格定义——SO(3)是三维空间中所有旋转构成的群。换句话说,IKNO不是去近似旋转不变,而是在数值精度范围内做到了严格一致。
从近似到精确的关键差异
无约束模型加数据增强,得到的是「学来的、不完美的」旋转鲁棒性;IKNO得到的是「结构保证的、精确的」旋转等变性。这一区别在实际应用中意义重大:前者的误差会随着输入分布偏移而暴露,后者则天然免疫坐标系变换带来的任何偏差。
SO(3)等变性的概念值得稍作展开。SO(3)是三维特殊正交群,包含所有行列式为+1的3×3正交矩阵,直观上对应三维空间中绕任意轴的旋转操作(不含镜像翻转)。所谓"等变"(equivariant)而非"不变"(invariant),是一个重要区分:不变性指输出不随旋转改变(如分子的总能量),等变性则指输出以与输入相同的方式变换——若输入速度场旋转了角度θ,输出的速度预测也应精确地旋转同样的θ。流体动力学建模需要的正是等变性,因为速度是向量场,它的方向本身就携带物理信息。各向同性核(isotropic kernel)是实现这一性质的关键构件:各向同性意味着核函数只依赖于两点间的距离和相对方向在旋转下保持不变的标量特征,而非依赖绝对坐标,从而在架构层面天然满足旋转对称要求。
精度不打折,参数却大幅精简
一个常见的担忧是:严格的对称性约束会不会牺牲预测精度?论文的实验结果打消了这个疑虑。
IKNO在预测精度上追平了一个通用的旋转感知模型——张量场网络(Tensor Field Network, TFN),但参数量仅为后者的约1/5.6。同时,相比参数量相当的图模拟器(graph simulator),IKNO的表现更胜一筹。这组对比传递出一个明确信号:一个紧凑的、针对特定PDE定制的模型,完全可以在不损失预测精度的前提下彻底消除坐标依赖。
换个角度看,专用化设计在这里体现出相对于通用等变架构的效率优势。TFN作为一个通用框架需要处理各类对称性,而IKNO针对Navier–Stokes这一具体问题做了结构裁剪,因此能用更少的参数达到同等效果。
张量场网络(Tensor Field Network, TFN)是2018年提出的一类通用等变图神经网络,其核心思想是用球谐函数(spherical harmonics)展开特征,使网络对SO(3)旋转严格等变。球谐函数是定义在球面上的一组正交基函数,以"阶"(order)l来刻画角动量:l=0对应标量(旋转不变),l=1对应向量(随旋转线性变换),更高阶则对应张量表示。TFN的表达能力随着考虑的最高阶数增加而增强,但计算和参数开销也随之急剧上升——这是通用等变架构参数量偏高的根本原因。IKNO通过将模型限定在Navier–Stokes问题的物理结构上,只保留必要的不变标量和l=1向量特征,绕开了高阶张量的开销,以更精简的路径实现了同等的等变保证。
对科学机器学习的启示
这项工作的价值不只在于一个新模型,更在于它重新强调了归纳偏置(inductive bias)在科学机器学习中的分量。当我们明确知道物理系统应当遵守的对称性时,与其让模型从海量数据中「猜」出这种规律,不如直接把它编码进网络结构。
对于从事流体仿真、气象预测、分子动力学等领域的研究者而言,IKNO的思路提供了一个可借鉴的范式:精确等变 + 结构紧凑 + 精度不降。这类PDE专用模型或许无法像通用大模型那样「一招打天下」,但在特定科学问题上,它们展现出的物理一致性和参数效率,正是通用方法难以企及的。
当然,论文的验证目前集中在三维Navier–Stokes动力学这一具体场景,其方法能否推广到更广泛的向量值PDE问题,仍有待后续研究检验。但至少,它清晰地证明了一点:坐标依赖并非神经算子不可逾越的宿命。
归纳偏置(inductive bias)指在模型设计阶段预先嵌入的关于目标问题结构的假设,目的是缩小假设空间、提升样本效率。在经典机器学习中,卷积神经网络对图像的平移等变性就是一种典型的归纳偏置。对于物理系统,守恒律、对称性和微分结构都是已知且精确的先验知识,将其编码进模型结构,理论上可以同时获得三重收益:减少达到相同精度所需的训练数据量、提升在分布外输入上的泛化能力、以及保证预测结果在物理上自洽。IKNO的工作正是这一思路的具体实践,也与近年来物理信息神经网络(PINN)、哈密顿/拉格朗日神经网络等方向共同构成了"物理结构嵌入"这一研究范式的代表性工作群。
相关推荐
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
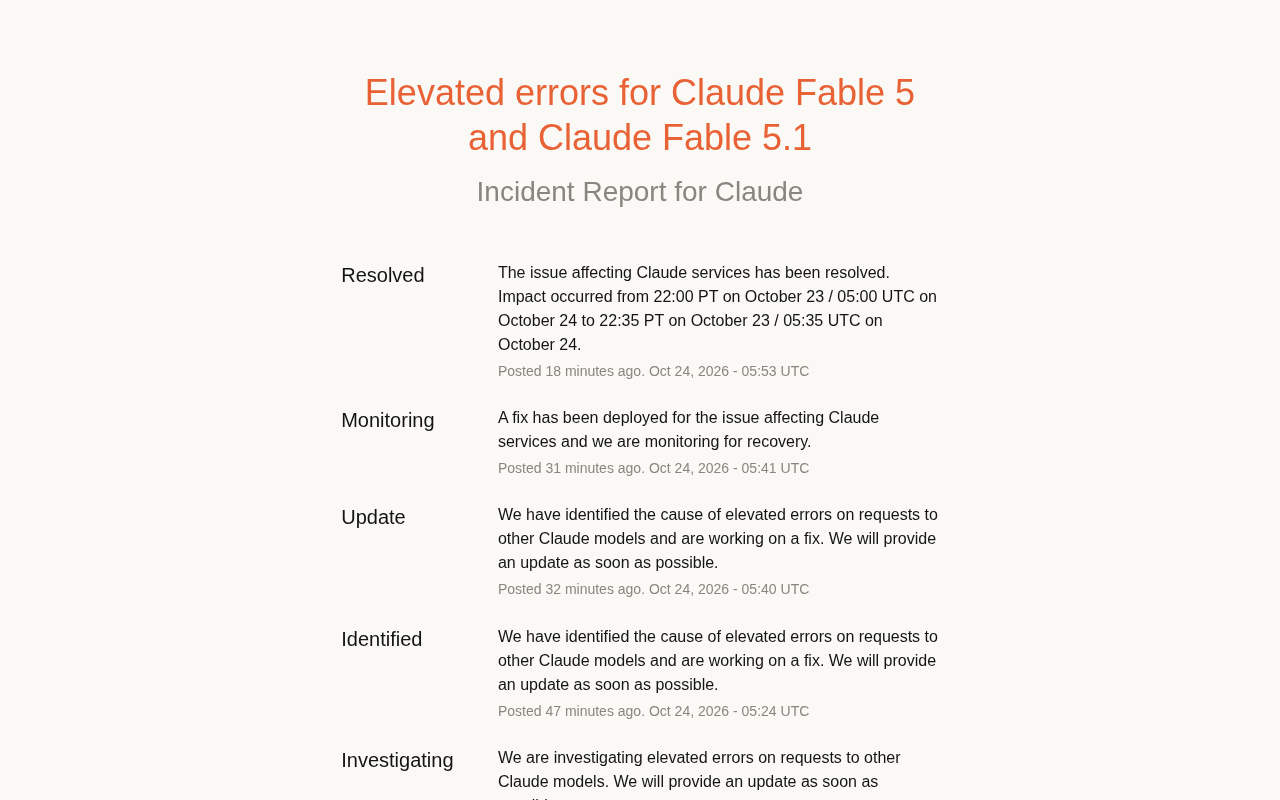
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。