TandemBench:多智能体协作决策模型基准

TandemBench基准揭示决策模型在团队计划选择准确率62.5%背后,最优性验证接近随机且存在系统性偏差。
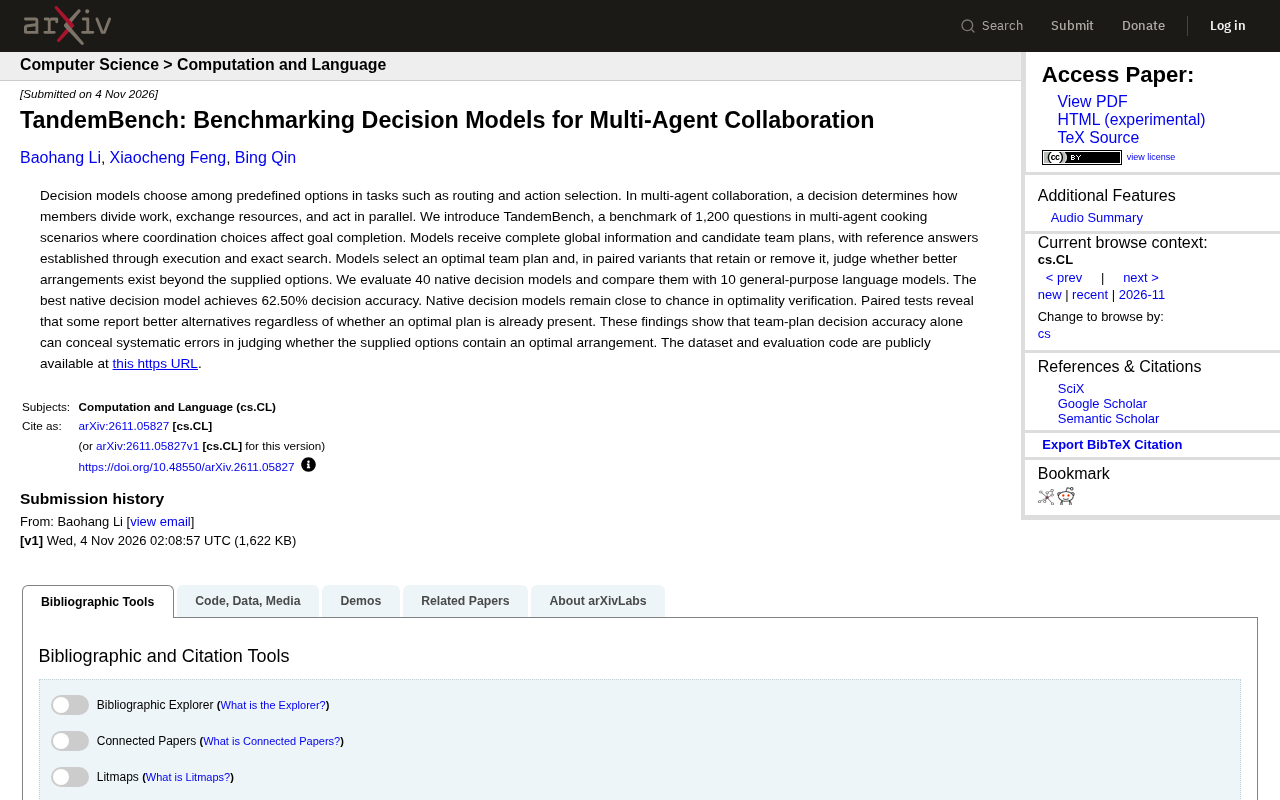
TandemBench 是一个包含1,200个烹饪场景的多智能体协作决策基准,要求模型从候选团队计划中选择最优方案,并判断给定选项是否已包含最优解。研究评估了40个原生决策模型和10个通用语言模型,最佳原生模型决策准确率达62.50%,但在最优性验证任务上接近随机水平。配对测试进一步揭示系统性偏差:部分模型无论是否提供最优计划,都会声称存在更好替代方案。这表明仅凭决策准确率可能掩盖模型在判断选项完整性时的错误。该基准数据集和代码已公开,为多智能体协作评估提供了更全面的视角。
多智能体协作中,决策模型如何选择团队计划?TandemBench 基准通过 1,200 个烹饪场景问题,揭示了当前决策模型在团队计划选择与最优性验证上的显著差距。
TandemBench 是什么?
TandemBench 是一个专门评估多智能体协作决策模型的基准,包含 1,200 个基于烹饪场景的问题。在这些场景中,协调选择直接影响目标能否完成。模型需要从候选团队计划中选出最优方案,并在配对变体(保留或移除最优计划)中判断是否存在更好的安排。
该基准的核心创新在于:不仅测试模型选择给定选项的能力,还检验其判断“是否已存在最优解”的元认知能力。参考答案通过执行和精确搜索建立,确保了评估的可靠性。
原生决策模型(native decision models)指专为序列决策或规划任务设计的模型(如基于强化学习或搜索的规划器),区别于通用语言模型(如GPT系列)。它们通常直接在状态-动作空间上训练,输出可执行的计划或动作序列,而非自然语言。TandemBench 将原生决策模型与通用语言模型对比,旨在评估不同架构在协作规划任务上的表现差异。原生决策模型在基准中达到62.50%的准确率,但在最优性验证上接近随机,提示其可能过度拟合于选择而非元认知判断。
评估设计与发现
研究评估了 40 个原生决策模型,并与 10 个通用语言模型进行对比。结果显示,最佳原生决策模型达到 62.50% 的决策准确率,看似不错,但深入分析后问题浮现。
在最优性验证任务中,原生决策模型的表现接近随机水平。更令人担忧的是,配对测试揭示了一个系统性偏差:部分模型无论是否已提供最优计划,都会声称存在更好的替代方案。这说明仅凭团队计划决策准确率,可能掩盖模型在判断“给定选项是否包含最优安排”时的系统性错误。
据原论文数据,这些发现指向一个关键结论:决策模型在复杂协作场景中的可靠性仍需大幅提升,尤其是在需要判断选项完整性的任务上。
配对测试(paired testing)是一种实验设计:对同一场景构造两个变体,一个包含最优计划,另一个移除最优计划,要求模型判断“是否存在更好方案”。通过比较模型在两个变体上的回答,可以检测模型是否真正评估了选项的完整性,而非仅依赖表面特征。TandemBench 利用配对测试发现,部分模型无论最优计划是否存在,都声称有更好替代方案,这揭示了模型在最优性验证上的系统性偏差——它们可能倾向于“过度优化”或无法识别已最优的状态。
对多智能体协作的启示
TandemBench 的评估结果对多智能体系统的实际部署具有警示意义。在路由、动作选择等任务中,决策模型的选择准确率固然重要,但若模型无法正确判断给定选项是否已包含最优解,系统可能陷入不必要的“优化循环”,或错失真正的最优方案。
该基准的数据集和评估代码已在 GitHub 公开(https://github.com/lililibaohang/TandemBench),为后续研究提供了可复现的测试平台。对于关注多智能体协作、决策模型评估的研究者和开发者而言,TandemBench 提供了一个更全面的视角:不仅要看模型选得对不对,还要看它是否知道自己选得对不对。
相关推荐

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。

trainlint:静态检查揪出不会崩溃的 ML 训练 Bug
trainlint 是一个静态检查工具,能找出不会报错的机器学习训练 bug,包括数据泄漏、eval 模式残留、softmax 与 CrossEntropyLoss 冲突等十四类问题。本文介绍其原理、验证结果与局限。