Uber如何让AI调用5000个工具而不撑爆上下文
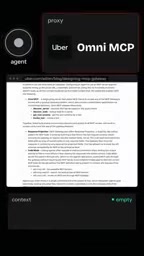
Uber用Omni MCP代理将5000个工具定义变为四步按需加载,解决智能体上下文溢出问题。
当AI智能体面对超过5000个工具时,标准MCP协议"全量加载工具定义"的做法会直接撑爆上下文窗口。Uber为此设计了Omni MCP代理层,只向智能体暴露四个元工具:发现服务器、列出工具、获取单个工具的schema、执行工具。智能体按需逐层检索,每步只有当前结果进入上下文,避免了海量工具定义的预加载开销。网关层还额外承担权限校验和响应裁剪(Response Projection)的职责,后者让智能体只拉取响应中所需字段,进一步压缩上下文占用。不过Uber未公布任何量化节省数据,且对于工具数量有限的小规模场景,引入代理层反而会增加调用轮次,标准做法依然更简洁。
当一个AI智能体面对超过5000个工具时,会发生什么?标准做法是把每个工具的完整定义都列给模型——结果是上下文窗口被塞满,模型还没开始干活,预算就已经耗光。Uber给出了一套名为 Omni MCP 的代理方案,核心思路是:不让智能体一次性加载所有工具,而是按需、分步地获取。
问题的根源:工具太多,上下文装不下
MCP(Model Context Protocol)的标准客户端行为是列出每一个工具的定义,包括名称、描述和输入参数。当工具数量只有几个时,这没什么问题;但在Uber这样的规模下,5000多个工具的定义会直接填满模型的上下文窗口。
上下文被工具定义占满,意味着两件事:一是留给实际任务推理的空间被压缩,二是每次调用的token成本急剧上升。对于需要高频调用工具的生产级智能体系统来说,这是一个绕不开的工程瓶颈。
MCP(Model Context Protocol)是由Anthropic于2024年底提出的开放协议,旨在为AI模型与外部工具、数据源之间提供标准化的接口规范。它类似于AI领域的"USB-C"——统一了智能体调用工具的方式,使不同厂商的工具可以被任何兼容MCP的模型直接使用。标准的MCP客户端在初始化时会调用tools/list接口,一次性拉取服务器上所有可用工具的完整定义(JSON Schema形式),这些定义会以system prompt或工具声明的形式注入模型上下文。对于GPT-4o或Claude这类模型,上下文窗口通常在128K到200K tokens之间,而一个工具定义平均占用数十至数百个token,5000个工具叠加起来轻松突破百万token量级,远超任何主流模型的窗口上限。
Omni MCP:用四个小工具代替5000个定义
Uber的解法是引入一个叫 Omni MCP 的代理(proxy)。它不把5000个工具直接暴露给智能体,而是只给智能体四个小工具,让它们按顺序使用:发现服务器、列出该服务器的工具、获取某个工具的schema(输入定义)、最后执行工具。
整个流程更像是一次渐进式的"检索":
- 智能体需要查询"订单状态"
- 它先找到对应的订单服务器
- 让该服务器列出自己的工具
- 只拉取一个工具的schema
- 最终只运行这一个工具
关键在于——只有这些结果会进入上下文。智能体不需要预先知道所有5000个工具长什么样,而是在真正需要时才逐层展开。这把"一次性全量加载"变成了"按需增量加载"。
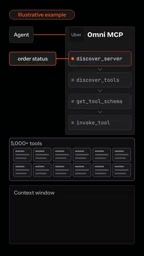
这种"按需增量加载"的思路在软件工程中有对应的经典模式——懒加载(Lazy Loading)。在传统数据库ORM或前端资源加载领域,懒加载指推迟对象或资源的初始化,直到它们真正被使用时才触发加载。Omni MCP将这一模式移植到了工具编排层:智能体首先只获得一个"工具目录的目录",每一步查询只拉取当前决策所需的最小信息量。这与检索增强生成(RAG)的核心逻辑有相通之处——RAG不把整个知识库塞入上下文,而是通过语义检索按需召回相关片段。Omni MCP的四步法可以看作工具版的RAG:发现服务器相当于粗排,列出工具相当于精排,获取schema相当于读取文档片段,最终执行才是真正的"引用"。
网关层做权限与响应裁剪
Omni MCP 不只是节省上下文,它还在网关层处理两件事。
权限校验:当某个工具被实际调用时,网关会检查调用方是否有权限。不过视频中特别指出,Uber 没有说明 工具列表本身是否会隐藏调用方无权使用的工具——也就是说,权限过滤是否发生在"列出"阶段还是仅在"执行"阶段,这一点并不明确。
响应裁剪(Response Projection):智能体在请求时只索要它需要的字段,网关会把响应中其余的部分裁掉。这进一步减少了进入上下文的无用数据,是Uber对这套机制的专门命名。
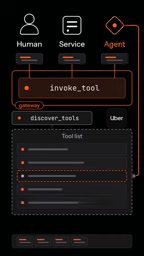
响应裁剪(Response Projection)这一命名借鉴了数据库查询中"投影"(Projection)的概念——在SQL中,SELECT field1, field2而非SELECT *就是一种投影操作,只返回查询方真正需要的列。Uber将这一思路应用于工具响应:智能体在调用工具时声明自己关心哪些字段,网关在收到下游服务的完整响应后,主动剔除无关字段再返回给模型。这对于返回体庞大的API尤为关键——例如一个订单查询接口可能返回包含数十个字段的JSON对象,但智能体当前任务只需要status和estimated_time两个字段。裁剪后进入上下文的数据量可能从数千token压缩至数十token,在高频调用场景下累积的节省相当可观。
没有公开的量化收益,该不该照搬?
值得冷静看待的一点是:Uber并没有公布任何实测的节省数据。这套架构在逻辑上成立,但到底省了多少token、延迟增加了多少,官方口径里是空白的。
因此是否采用这套方案,取决于你自己的规模:
- 如果你的工具列表很大,可以实测一下这"四步法"(发现→列出→取schema→执行)带来的效果。
- 如果你只有一个小型服务器,继续用标准的工具列表就好——引入代理层反而会增加不必要的调用轮次和复杂度。
对智能体工程的启示
Omni MCP 代表了一种在MCP生态中应对工具规模化的工程思路:把工具发现当成一个检索问题,而不是一个加载问题。当工具库膨胀到成百上千时,"全量注入上下文"的模式必然失效,分层懒加载(lazy loading)加网关侧裁剪会成为更可持续的架构选择。
这套做法也提醒我们,智能体系统的性能优化不只在模型本身,更多发生在工具编排、上下文管理和网关设计这些"管道"层面。真正的工程价值,往往藏在这些不起眼的中间层里。
相关推荐

用n8n自动将博客文章转为X推文与领英帖子
本文基于 YouTube 教程,讲解如何用自动化工具 n8n 配置 HTTP 请求节点调用 Gemini API,自动把博客文章改写成 X 推文和领英帖子,涵盖节点命名、POST 方法与 OpenAI 兼容端点等关键配置。

Uber如何用Omni MCP解决MCP最大的上下文难题
Uber推出Omni MCP代理服务器,用discover server、discover tools、get tool schema、invoke tool四个元工具解决MCP在5000+工具规模下的上下文爆炸难题。本文详解其架构、权限控制与响应投影机制。

企业级AI Agent实战:用智能体做事件根因富集
企业如何落地AI Agent?本文拆解事件富集(Incident Enrichment)实战用例:用事件响应Agent协同多个诊断Agent,通过MCP与身份网关安全收集证据、推理根因,在低风险高价值场景中加速故障定位。