微软数据中心首批Vera Rubin芯片交付:AI算力竞赛新里程碑
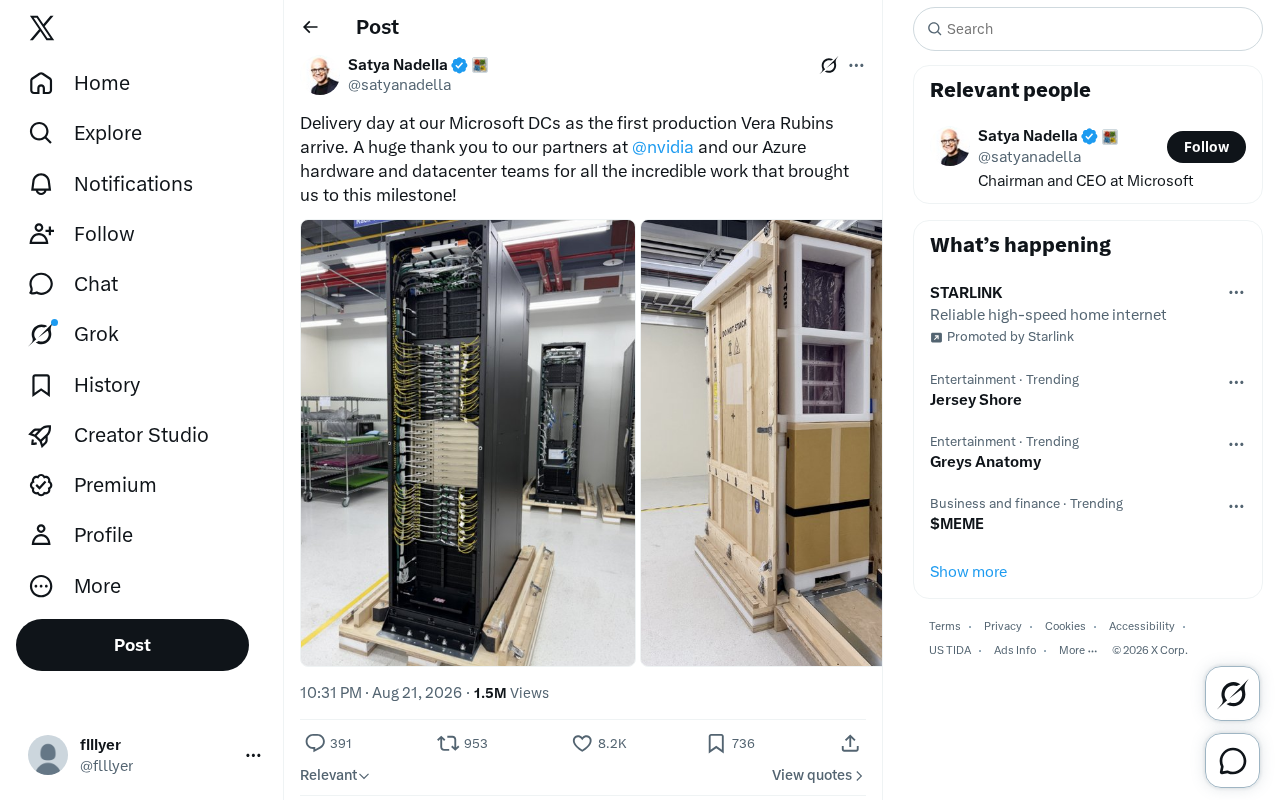
微软数据中心迎来首批Vera Rubin芯片:AI算力竞赛进入新阶段
微软官方近日宣布,首批量产版NVIDIA Vera Rubin芯片已正式部署至微软数据中心。微软在公告中特别致谢合作伙伴NVIDIA及Azure硬件与数据中心团队,称这标志着双方合作达成的重要里程碑。
这一动态背后,反映出云计算与AI基础设施竞赛的关键信号。作为NVIDIA下一代GPU架构,Vera Rubin进入超大规模云厂商生产环境,意味着新一轮算力升级周期正式启动。
Vera Rubin芯片:NVIDIA新一代AI计算平台
架构创新与技术特点
Vera Rubin是NVIDIA继Blackwell之后的新一代计算平台,命名源自发现暗物质关键证据的美国天文学家Vera Rubin,延续了NVIDIA以科学家命名架构的传统。
要理解Vera Rubin的技术意义,需要将其放在GPU架构演进的完整脉络中审视。GPU(图形处理单元)最初为图形渲染设计,但其大规模并行计算能力使其成为AI训练的理想硬件。NVIDIA从2012年AlexNet在ImageNet竞赛中使用GPU取得突破后,逐步将GPU架构针对深度学习进行专项优化。Pascal架构(2016)奠定了数据中心GPU的基础形态;Volta架构(2017)引入了革命性的Tensor Core——一种专用张量计算单元,能够在单个时钟周期内完成矩阵乘加运算,大幅加速深度学习中最核心的矩阵计算;Ampere架构(2020)引入稀疏计算支持和第三代Tensor Core,利用神经网络权重中的结构化稀疏性将有效吞吐量翻倍;Hopper架构(2022)则首次集成Transformer Engine,通过在FP8和FP16精度之间动态切换,在几乎不损失模型精度的前提下大幅提升大语言模型训练效率。Blackwell架构(2024)作为Hopper的继任者,引入第二代Transformer Engine和创新的双芯片封装设计,将单GPU晶体管数量推至2080亿。而Vera Rubin代表2025年的最新一代,采用台积电更先进制程节点,专为万亿参数规模模型和多模态计算设计,在浮点计算密度、能效比和互联带宽上实现全面跃升。值得注意的是,NVIDIA已将架构更新节奏从传统的两年一代压缩至一年一代,这种加速迭代节奏本身就是AI算力需求爆发式增长的最直接反映。
该平台采用全新设计的GPU与NVIDIA自研Arm架构CPU,构成完整的超级芯片解决方案。超级芯片(Superchip)是将CPU与GPU封装在同一模块内的异构计算方案,其核心价值在于通过高速互联实现处理器间的超高带宽通信,从根本上解决传统架构中的数据传输瓶颈。在传统方案中,CPU负责任务调度和数据预处理、GPU负责密集计算,两者通过PCIe总线连接——即便最新的PCIe 5.0标准也仅提供64 GB/s双向带宽,远不能满足大模型训练中CPU-GPU之间海量数据传输的需求。NVIDIA为此采用自研Grace CPU(基于Arm Neoverse V2架构,具备72个高性能核心)与GPU通过NVLink-C2C(Chip-to-Chip)技术封装成超级芯片,C2C互联提供高达900 GB/s的双向带宽,是PCIe 5.0的14倍。这种设计使CPU能够直接访问GPU显存,GPU也能直接访问CPU的LPDDR5X内存,构成统一内存地址空间。
这一架构特性在大模型推理场景中尤为关键。长上下文推理需要维护庞大的KV Cache(键值缓存)——这是Transformer注意力机制中用于存储已计算的键(Key)和值(Value)向量的数据结构,通过缓存这些向量避免在生成每个新token时重复计算之前所有位置的注意力信息。当上下文长度达到百万token级别时,KV Cache可能占用数百GB内存,远超单张GPU的显存容量。超级芯片的统一内存架构允许KV Cache在CPU和GPU内存间灵活分配和迁移,有效突破单一GPU显存容量限制。Vera Rubin延续并深化这一设计思路,使得大规模AI训练和推理在能效比和整体吞吐能力上实现显著提升。
应对超大规模AI计算需求
随着大语言模型参数规模持续扩大,多模态模型和推理系统对算力需求呈指数级增长。从具体数据来看,大语言模型参数规模的增长速度令人瞩目:2018年GPT-1拥有1.17亿参数,2019年GPT-2扩展至15亿参数,2020年GPT-3一跃达到1750亿参数——两年内参数规模增长约1500倍。随后Google的PaLM模型达到5400亿参数,而当前主流前沿模型普遍采用混合专家架构(Mixture of Experts, MoE),总参数量可达万亿级别。据报道,GPT-4采用8×220B专家架构,总参数约1.76万亿,但每次推理仅激活部分专家,在控制推理成本的同时大幅扩展模型容量。
参数规模增长直接推动算力需求的指数级膨胀:训练GPT-3需要约3640 PetaFLOP/s-day算力(大致等同于1000张V100 GPU持续训练34天),而训练GPT-4级别模型估计需要超过2×10²⁵ FLOPs,动用数万张A100/H100 GPU协同工作3至6个月,训练成本可达数亿美元。推理阶段同样面临严峻挑战:服务一个万亿参数模型即便使用FP8精度量化也需要约1TB显存来存储模型权重,加上KV Cache和中间激活值,实际内存需求更高。同时,为保证用户体验,每个token的生成延迟需控制在数十毫秒内,这要求极高的内存带宽和计算吞吐。模型规模的持续扩大遵循Scaling Law(缩放定律)——模型能力随参数量、数据量和算力呈幂律关系增长,当前尚未观测到明确的性能饱和拐点,这正是Vera Rubin等新架构重点解决的问题。
云厂商对下一代硬件的需求达到前所未有的高度。Vera Rubin针对这些挑战,重点解决超大模型训练中的算力瓶颈、内存带宽限制和高速互联问题。
内存带宽瓶颈是当前AI计算面临的核心挑战之一。内存带宽衡量单位时间内处理器能从显存读取或写入的数据量,通常以TB/s为单位。在大模型推理的自回归生成阶段,每生成一个token都需要从显存中加载整个模型的权重参数进行矩阵乘法运算。当模型达到千亿参数规模时,即便使用FP8量化(将每个参数压缩为8位浮点数),权重数据也有约100GB。如果显存带宽不足,GPU中数千个计算核心会处于空闲等待数据的状态,形成所谓的"memory-bound"(内存瓶颈)问题——此时实际算力利用率可能低于10%,大量计算资源被浪费。这也是为什么推理场景的性能瓶颈往往不在计算能力本身,而在内存带宽。
NVIDIA通过采用HBM3e(High Bandwidth Memory 3 Enhanced)显存技术来应对这一挑战。HBM是一种革命性的三维堆叠高带宽内存技术,通过硅中介层(silicon interposer)将多层DRAM芯片垂直堆叠并与GPU裸片紧密互联,相比传统GDDR内存在相同面积下提供数倍的带宽和容量。HBM3e相比前代HBM3在单堆栈带宽和容量上均有提升,单堆栈可达36GB容量和约1.2TB/s带宽。在Vera Rubin上集成多个HBM3e堆栈,预计总显存带宽可超过5TB/s,总容量达到288GB或更高。同时NVIDIA在芯片架构层面优化内存层次结构,包括大幅增加L2片上缓存容量(Blackwell已将L2缓存提升至约60MB,使更多频繁访问的数据能直接从片上高速缓存获取)、改进内存控制器的预取和调度算法以减少访存延迟、引入更智能的内存压缩技术以提升有效带宽,从多个层面协同缓解这一关键瓶颈。
高速互联技术方面,大模型训练通常采用多维并行策略——数据并行(将训练数据分片到不同GPU)、张量并行(将单层计算切分到多张GPU)、流水线并行(将模型不同层分配到不同GPU)和专家并行(MoE模型中将不同专家分布到不同GPU)——需要数千甚至数万张GPU协同工作,GPU间的数据通信效率直接影响整体训练速度。以张量并行为例,单层Transformer的计算被切分到多张GPU上,每次前向和反向传播都需要执行AllReduce等集合通信操作来同步中间结果,通信延迟和带宽直接决定了可扩展的并行度上限。
NVLink是NVIDIA专有的GPU间高速互联技术,从2016年第一代的20 GB/s起步,每一代都大幅提升带宽。第五代NVLink(用于Blackwell架构)单链路双向带宽达到112.5 GB/s,通过NVLink Switch互联最多576颗GPU形成NVLink域,域内任意两颗GPU间可实现全速双向通信。Vera Rubin预计将采用进一步增强的NVLink版本,扩展域内GPU数量并提升单链路带宽。在更大规模的集群中(跨机架、跨机房),节点间通信依赖InfiniBand或超高速以太网。NVIDIA旗下的Mellanox InfiniBand技术提供超低延迟(端到端约1-2微秒)和高带宽(当前NDR标准为400Gbps,下一代XDR将达到800Gbps),并支持RDMA(Remote Direct Memory Access,远程直接内存访问)技术——允许GPU绕过CPU和操作系统内核,通过GPUDirect RDMA直接读写远程节点GPU的显存,极大减少通信开销和协议栈延迟。
微软等云厂商部署Vera Rubin时,需要配套升级整个网络拓扑。大规模GPU集群通常采用Fat-Tree(胖树)拓扑提供全二分带宽(任意两个节点间可获得与单节点带宽相当的通信带宽),或Dragonfly(蜻蜓)拓扑在降低布线成本和光纤用量的同时保持较高带宽。网络升级的资本支出往往与GPU采购本身相当,是数据中心建设的关键投资方向——一个万卡级GPU集群的网络设备和光模块成本可达数亿美元。
微软率先部署的战略价值
云服务商算力竞争加剧
微软成为首家部署Vera Rubin量产版的云厂商,凸显其在NVIDIA合作体系中的优先地位。在当前AI浪潮中,谁能更早部署最新算力,谁就能在服务关键客户、推进自研AI能力上占据先机。
Azure作为OpenAI的独家云基础设施供应商,承载着ChatGPT和GPT系列模型的核心算力需求。这一深度合作始于2019年微软向OpenAI投资10亿美元并建立战略合作关系,此后合作不断深化——2023年微软追加投资,累计投资规模达百亿美元级别,成为科技史上最大规模的AI领域投资之一。协议的核心条款是OpenAI独家使用Azure云基础设施进行模型训练和服务部署,微软则获得OpenAI模型的商业化授权,将GPT系列模型深度集成到Microsoft 365 Copilot、Bing搜索、GitHub Copilot、Azure OpenAI Service等产品矩阵中。
这意味着ChatGPT、GPT-4、GPT-4o以及未来所有OpenAI产品的后端完全运行在Azure数据中心,包括由数十万张GPU组成的超大规模训练集群(据报道OpenAI的训练集群已达到十万张H100级别)。这种深度绑定创造了强大的战略互锁效应:微软必须保持最先进的AI算力供给,任何硬件迭代延迟都可能影响OpenAI的模型训练计划和产品发布节奏,进而威胁微软在生成式AI市场的领先地位;反过来,OpenAI也依赖微软持续的资本投入和基础设施扩张来支撑其研究雄心。值得注意的是,这种合作模式也引发了行业讨论——独家绑定是否限制了OpenAI的技术选择自由度(例如无法选用谷歌TPU等替代硬件),以及微软是否过度依赖单一AI合作伙伴带来的战略风险。但从短期商业逻辑来看,优先获得Vera Rubin芯片正是微软履行这一战略承诺、维护核心合作关系的具体体现。
数据中心基础设施协同升级
微软在声明中提及的"Azure硬件和数据中心团队",揭示了新芯片部署的复杂性。将Vera Rubin投入生产涉及数据中心电力系统、散热方案、网络互联和系统集成等一系列工程挑战。
新一代AI芯片的功耗和散热需求远超前代产品,数据中心液冷技术革新已成为行业必然趋势。以GPU单卡功耗(TDP,热设计功耗)演进为例:NVIDIA A100(2020)为400W,H100(2022)提升至700W,Blackwell B200(2024)达到约1000W,而Vera Rubin预计将进一步提升。当单个GPU机柜集成8至16张这类千瓦级芯片时,机柜总功耗可达40-100kW,远超传统风冷数据中心单机柜8-15kW的散热能力上限。
传统风冷方案通过冷热通道隔离、精密空调和架空地板送风等设计,在芯片功耗较低时尚可应对,但面对千瓦级单卡功耗已接近物理极限——空气的比热容和热传导效率决定了其散热能力的天花板。液冷技术通过冷却液直接接触或包围发热元件,散热效率比风冷高出10至100倍,成为唯一可行的技术路径。当前主流液冷方案包括两种:**冷板式液冷(Cold Plate)**将含有冷却液的金属冷板直接贴合在芯片表面,通过循环管路将热量带至外部热交换器,优点是改造成本相对较低、与现有服务器设计兼容性好,是当前部署最广泛的方案;**浸没式液冷(Immersion Cooling)**则将整个服务器主板浸入绝缘冷却液(如3M Novec氟化液或矿物油基液体)中,可承载更高功率密度且散热更均匀,适合极高功耗密度场景,但对密封性、冷却液管理和维护流程要求更高。
部署Vera Rubin这类高功耗芯片,还要求数据中心同步进行供电系统的根本性升级——包括变压器容量扩展、UPS(不间断电源)配置重新规划、配电单元(PDU)规格提升。单机柜功率从传统的15kW跃升至100kW意味着从市电引入到末端配电的整条供电链路都需要重新设计。此外还需优化机房布局以适应液冷管路分布,包括冷却液分配单元(CDU)的部署位置规划、管路走线设计、泄漏检测传感器布设和应急处理系统。这推动超大规模数据中心在液冷技术、供电架构、甚至建筑结构设计等方面同步革新,数据中心正从传统的"IT机房"演变为更接近工业设施的"AI工厂"。首批Vera Rubin的成功部署,实际上是芯片、系统软件与基础设施三者深度协同的综合工程成果。
AI行业影响深度解析
推动算力供给持续升级
头部云厂商部署新一代芯片,意味着未来一段时间内顶级算力供给将显著提升。这将直接惠及在Azure平台训练和部署模型的企业与开发者,可能催生新一轮模型能力突破。
这一预期的理论基础是Scaling Law(缩放定律)。2020年,OpenAI研究员Jared Kaplan等人系统阐述了语言模型性能(以交叉熵损失衡量)与三个核心因素之间的幂律关系:模型参数量(N)、训练数据量(D)和计算量(C)。核心发现包括:在固定计算预算下存在最优的参数量和数据量分配比例;模型性能随计算量呈现平滑且可预测的对数线性提升曲线;且目前尚未观测到这种提升趋势的饱和拐点。2022年DeepMind的Chinchilla论文进一步修正了最优缩放比例,指出之前的大模型普遍"训练不足"——最优策略应该是参数量和数据量同比例增长,而非一味增大参数量。
根据这些规律推算,要实现下一个数量级的能力突破,通常需要10至100倍的算力增长。当前顶级模型训练已消耗约10²⁵ FLOPs级别算力(如Meta的Llama 3 405B使用约3.8×10²⁵ FLOPs),未来瞄准AGI级别能力的模型可能需要10²⁶至10²⁸ FLOPs——这将需要数十万张最新GPU持续训练数月之久。这解释了为何云厂商和AI实验室对Vera Rubin等新一代硬件如此迫切:算力供给直接决定了能训练多大规模的模型,进而影响模型能力的天花板。
当然也有研究者指出,纯粹依赖规模扩张可能面临数据供给枯竭和边际收益递减的问题。算法创新——如更高效的注意力机制(FlashAttention将注意力计算从O(n²)内存降至O(n))、混合专家架构(在保持推理效率的同时扩展总参数量)、更好的数据质量筛选和课程学习策略——同样是突破能力边界的关键路径。但无论算法如何优化,硬件迭代始终是突破算力物理瓶颈、继续沿Scaling Law曲线攀升的基础前提。
NVIDIA生态地位进一步巩固
从Hopper到Blackwell,再到Vera Rubin,NVIDIA保持着年度级架构更新节奏,牢牢掌控AI芯片市场主导权。微软等云巨头的持续大规模采购,进一步强化了NVIDIA在AI基础设施领域的核心地位。
尽管各大云厂商都在推进自研AI芯片战略,但在最前沿的大模型训练场景中,NVIDIA GPU仍保持着难以撼动的主导地位。面对NVIDIA在数据中心GPU市场超过80%的份额和持续上涨的芯片价格(H100单卡售价约2.5至4万美元),各大云厂商纷纷投资自研AI芯片以降低供应商依赖和长期成本。
微软Maia 100于2023年发布,采用台积电5nm制程,集成1050亿晶体管,专为Azure云推理场景优化,配合自研Cobalt Arm CPU构成完整的自研算力栈。**谷歌TPU(Tensor Processing Unit)**是最早的自研AI芯片之一,自2016年第一代起已迭代至第六代(Trillium),拥有基于JAX和XLA编译器的完整软件栈。Gemini等谷歌旗舰模型主要在TPU集群上训练,有力证明了自研芯片承担顶级模型训练的技术可行性。亚马逊推出Trainium训练芯片(第二代Trainium2具有高达393 TFLOPs的BF16算力)和Inferentia推理芯片,通过AWS Neuron SDK支持PyTorch等主流框架。Meta则开发了MTIA(Meta Training and Inference Accelerator)芯片,主要用于其推荐系统和内部AI工作负载。
这些自研芯片的共同优势在于:针对自家特定工作负载深度定制优化、降低对单一供应商的供应链风险、长期改善成本结构(谷歌声称TPU训练成本比同级GPU低约50%)。但挑战同样显著,其中最大的壁垒是CUDA生态系统的护城河效应。经过15年以上的持续积累,CUDA已拥有数百万活跃开发者,构建了丰富的高性能计算库生态(cuDNN用于深度学习、cuBLAS用于线性代数、TensorRT用于推理优化、NCCL用于多GPU通信等),并获得PyTorch、TensorFlow、JAX等几乎所有主流AI框架的原生一等支持。这形成了强大的网络效应和生态锁定:开发者倾向使用工具最丰富的平台,而更多开发者的聚集又进一步丰富生态,创造正反馈循环。自研芯片的软件栈需要持续巨额投入且难以在短期内达到同等成熟度,客户将现有代码和工作流迁移到新平台的成本高昂——这不仅包括代码改写,还涉及调试工具、性能分析工具和运维流程的全面重建。
因此在最前沿的大模型训练场景——尤其是需要支持多样化客户工作负载的公有云场景——NVIDIA GPU凭借CUDA生态的通用性和成熟工具链仍占据不可替代的主导地位。自研芯片更多扮演战略性补充角色,在特定场景(如推理服务、推荐系统)和自用工作负载中发挥成本优势,短期内难以动摇NVIDIA在通用AI训练市场的核心地位。
展望:算力升级带来的新机遇
首批Vera Rubin部署至微软数据中心,是AI算力竞赛的又一关键节点。它既验证了NVIDIA新架构的量产能力和产业链协同效率,也展现了微软在下一代AI基础设施上的战略决心和执行力。
对于AI从业者而言,这类硬件层面的进展往往是预判未来模型能力上限的先行指标。当更强大的算力基础设施落地,新一代更大规模、更高质量的模型训练将随之启动。从历史经验看,每一代GPU架构的大规模部署都伴随着AI能力的阶梯式跃升——V100支撑了BERT时代的预训练革命,A100催生了GPT-3开启的大语言模型浪潮,H100使GPT-4级别的多模态大模型成为可能。Vera Rubin的部署,或将为下一代突破性模型和AI应用奠定算力基础,推动人工智能从当前的语言理解和生成,向更复杂的多步推理、长期规划和多模态智能迈进。我们有充分理由期待这一硬件里程碑带来的创新突破。
核心要点
-
首批量产Vera Rubin芯片部署至微软Azure数据中心,标志着NVIDIA最新一代AI计算平台正式进入超大规模云厂商生产环境,新一轮算力升级周期正式开启。
-
Vera Rubin采用GPU+自研Arm CPU超级芯片架构,通过NVLink-C2C高速互联实现统一内存地址空间,配合HBM3e高带宽显存和增强版NVLink互联,全面解决超大模型训练和推理中的算力、内存带宽和通信瓶颈。
-
微软率先部署凸显其战略优先地位,作为OpenAI独家云基础设施供应商,微软需要保持最前沿算力供给以支撑GPT系列模型训练和数十万GPU规模集群的持续扩张。
-
数据中心面临全栈基础设施升级挑战,千瓦级单卡功耗推动液冷技术从可选变为必选,供电系统、网络拓扑和机房设计需同步革新,芯片部署实质是系统级工程协同的成果。
-
NVIDIA凭借年度架构更新节奏和CUDA生态护城河保持主导地位,尽管微软、谷歌、亚马逊等厂商均在推进自研AI芯片,但在通用大模型训练的公有云场景中,NVIDIA GPU短期内仍难以替代。
-
Scaling Law驱动的算力需求尚无饱和迹象,前沿模型训练算力已达10²⁵ FLOPs级别,下一代突破可能需要10至100倍增长,Vera Rubin的部署为沿缩放曲线继续攀升提供了硬件基础。
相关推荐
开源AI的真相:你拿到的只是蛋糕,不是配方
海外博主深度揭秘开源AI真相:你下载的只是权重(蛋糕),而非训练数据与代码(配方)。文章拆解开放权重与真正开源的差异,剖析Meta、阿里、DeepSeek的商业策略,以及中美欧三国政府如何用营收门槛与算力上限重画开放边界。
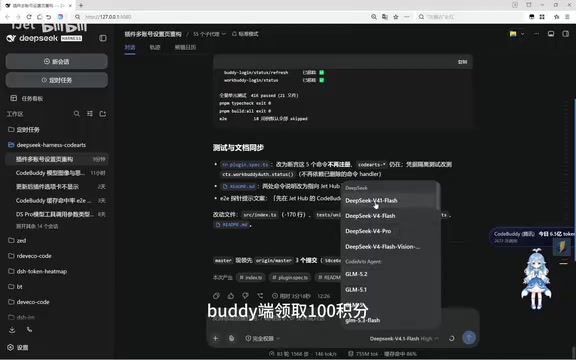
DSH白嫖DeepSeek V4.1 Flash:积分批量领取与国际版WorkBuddy实测
DSH项目最新升级实测:WorkBuddy端可批量领取100积分,限流额度提升、重置时间缩短,国际版WorkBuddy现已支持免费调用混元4与DeepSeek V4.1 Flash,附使用建议与风险提示。
DSH-SUBAGENT-UI插件:DeepSeek Harness子代理管理神器
DSH-SUBAGENT-UI 是 DeepSeek Harness Web 客户端插件,提供子代理总览、搜索、本地分类与完成快照功能,数据存本地不侵入原会话,一条命令即可安装,助力多子代理工作流高效管理。