WhaleRead:本地化AI翻译电子书阅读器,隐私优先的选择
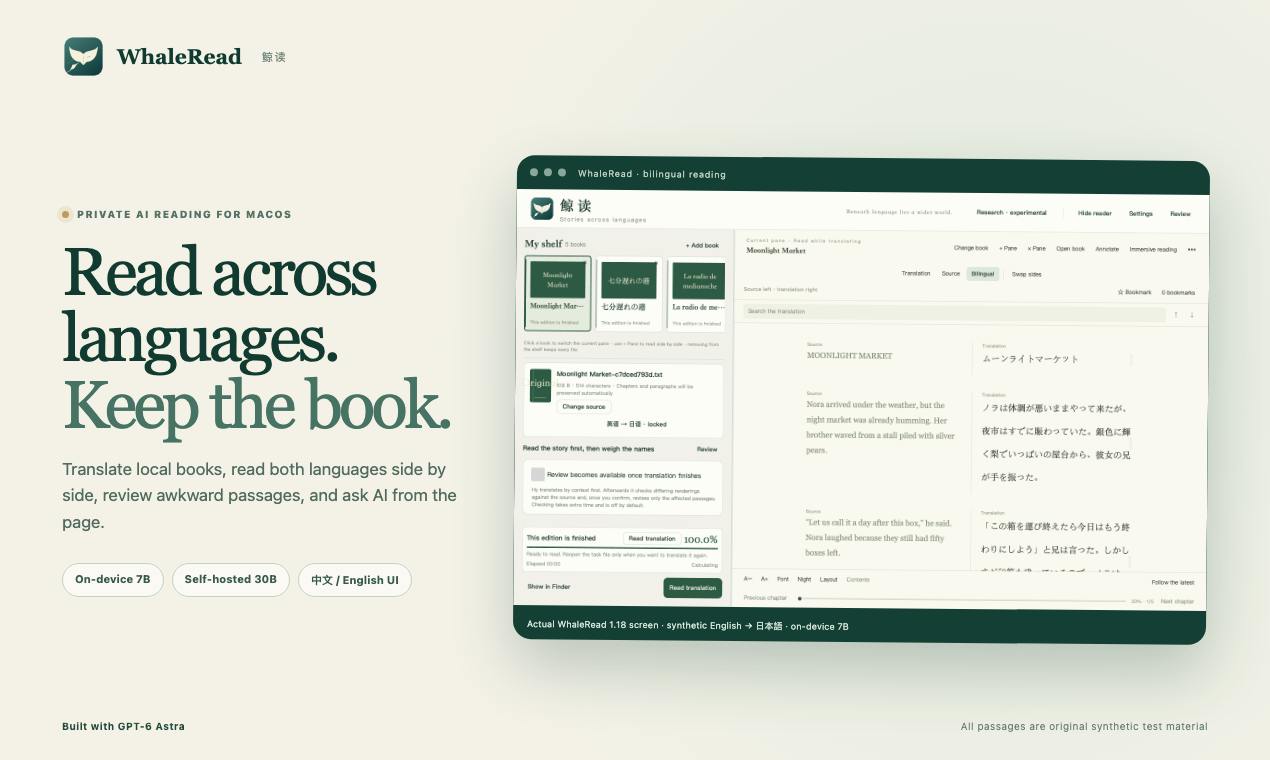
WhaleRead 是一款本地优先的 macOS 阅读器,用本地或自托管 AI 模型完成翻译,让数据不经过第三方服务器。
WhaleRead 是一款面向 macOS 的阅读器,以「本地优先」为核心差异化策略,支持 TXT、Markdown 和 EPUB 格式的 AI 翻译,同时将数据处理完全留在用户设备或私有环境中。它提供两条技术路线:在本地运行 7B 参数模型以满足日常需求,或接入用户自托管的 30B 私有模型以追求更高翻译质量。产品还具备双语对照阅读、人工确认审校和 Ask AI 对话等功能,将阅读器从翻译工具扩展为可交互的阅读助手。目前产品仅支持 macOS,处于早期阶段,本地模型的翻译质量与云端大模型仍有差距,30B 自托管方案对普通用户的硬件和技术门槛也构成挑战,但对于重视隐私和数据主权的用户,它提供了一个值得关注的新思路。
一款把翻译留在本地的阅读器
在AI翻译工具遍地开花的今天,绝大多数应用都依赖云端接口——你的书籍、笔记乃至阅读习惯,都要经过第三方服务器。WhaleRead 选择了一条不同的路:这是一款主打「本地优先(local-first)」的 macOS 阅读器,把翻译、审校和 AI 问答都尽量留在你自己的设备上完成。
它在 Product Hunt 上以 73 票、排名 #14 亮相,归入 Languages、Artificial Intelligence、Books 以及 OpenAI Day 等分类。产品定位非常清晰:支持 TXT、Markdown 和 EPUB 三类常见文本格式的翻译,同时把用户的书库牢牢握在自己手里。
核心能力:本地模型与自托管的两种路线
WhaleRead 最值得关注的设计,是它对翻译引擎的处理方式。它提供两条技术路线:一是在设备本地运行 7B 规模的模型,二是接入用户自托管的 30B 私有模型。
这两种方案对应着不同的使用场景。7B 模型体量适中,普通配置的 Mac 就能在本地跑起来,满足日常轻量翻译需求;而 30B 的自托管方案则面向对翻译质量要求更高、且有条件搭建私有推理服务的进阶用户。无论哪种,核心逻辑都是一致的:数据不出本地或私有环境,规避了云端翻译常见的隐私顾虑。
对于处理敏感文档、未公开手稿或个人笔记的用户来说,这种「数据可控」的属性是刚需,而不是锦上添花。
所谓「7B」和「30B」中的字母 B 代表 Billion(十亿),指模型参数量。参数量是衡量语言模型规模的核心指标——7B 模型拥有约 70 亿个参数,30B 模型约 300 亿个。参数量越大,模型在语言理解和生成质量上通常越强,但同时对内存和算力的需求也成倍增长。以 Apple Silicon 芯片的 Mac 为例,运行 7B 量化模型一般需要 8GB 以上统一内存,而 30B 模型则可能需要 32GB 甚至更多,且推理速度会明显下降。这也是为什么 WhaleRead 将两条路线分别对应「日常轻量用户」和「有条件搭建私有推理服务的进阶用户」——并非功能设计的差异,而是硬件现实的映射。近年来 Llama、Mistral 等开源模型的涌现,使得消费级设备本地运行 7B 模型成为可行选项,这正是「本地 AI 应用」从概念落地为产品的技术前提。
双语对照与人工确认的审校流程
除了翻译本身,WhaleRead 还保留了「双语阅读(bilingual reading)」体验,即原文与译文对照呈现。这对语言学习者和需要核对原意的读者尤其友好——机器翻译再强,读者也常常需要回看原文确认语气和细节。
更进一步的是它引入了「人工确认审校(human-confirmed review)」机制。AI 给出译文后,用户可以介入确认或修正,而不是被动接受一个不可编辑的结果。这种「AI 生成 + 人工把关」的协作模式,正契合当下对 AI 输出「不盲信、可校验」的普遍认知。
配套的 Ask AI 功能则让读者能针对文本内容随时提问,把阅读器从单纯的翻译工具,扩展成了一个可以对话的阅读助手。
本地优先趋势下的定位思考
WhaleRead 的出现,反映了一个正在升温的方向:随着小参数模型(7B 乃至更小)在消费级设备上跑得越来越流畅,「本地 AI 应用」正从概念走向实用。它不追求最强的翻译效果,而是用「够用的本地能力 + 完全的数据掌控」构建差异化。
需要客观看待的是,本地方案也有代价。7B 模型的翻译质量通常难以匹敌顶级云端大模型,30B 自托管则对硬件和技术门槛提出了要求,普通用户未必能轻松部署。此外,产品目前仅支持 macOS,Makers 信息显示为「New User」,评论数也仅 1 条,说明它还处在早期阶段,实际口碑和长期迭代能力有待观察。
对于把隐私和数据主权放在首位的读者、语言学习者,以及习惯在本地处理文档的开发者而言,WhaleRead 提供了一个值得试用的思路。它是否能在体验和质量上持续打磨,将决定它能走多远。
「本地优先(local-first)」是软件设计领域近年兴起的一种理念,最早由 Ink & Switch 研究团队在 2019 年系统阐述。其核心主张是:用户数据应首先存储和处理在本地设备上,云端仅作为可选的同步或备份渠道,而非必经的数据中转站。这一理念的兴起,部分源于对 SaaS 服务「数据托管风险」的反思——当云服务停止运营或更改隐私政策时,用户往往对自己的数据失去控制。对于 AI 应用而言,本地优先还额外解决了一个问题:防止用户输入的内容(无论是私人文档还是商业机密)被用于模型训练或被第三方访问。WhaleRead 将这一理念延伸到翻译场景,使其对隐私敏感型用户的吸引力具有明确的理论支撑,而不只是一个营销卖点。
相关推荐
Robinhood高管将亮相TechCrunch Disrupt 2026谈现代金融消费者
Robinhood产品营销副总裁Abhishek Fatehpuria将亮相TechCrunch Disrupt 2026,分享如何赢得现代金融消费者。早鸟报名9月25日前最高省200美元。
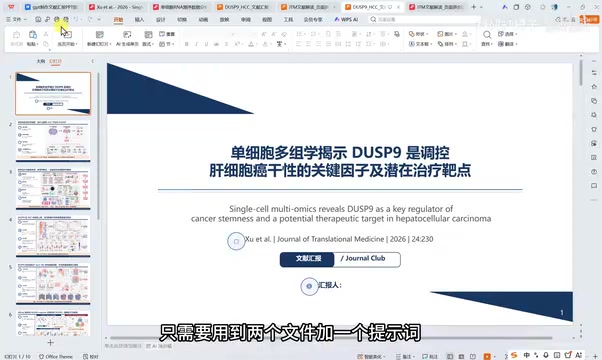
用ChatGPT批量生成可编辑学术PPT:科研人的效率工具实战
分享用ChatGPT批量生成可编辑学术PPT的完整流程:只需文献PDF、PPT模板和一段提示词,先出图再拼合转可编辑,半小时完成美观汇报PPT,并对比了ChatGPT与Codex的适用场景。
GPT-6满血版使用教程:通过GPT-work开启Ultra最高思考强度
本文详解如何付费使用GPT-6满血版:从Apple ID注册、Plus/Pro套餐充值,到通过GPT-work客户端工作模式开启GPT-6 Ultra最高思考强度与完整权限,并附网页版隐藏解锁路径。