吴恩达Agent智能体教程精读:如何构建真正有用的Agentic AI应用
吴恩达课程强调:Agentic AI 的核心价值在于评估驱动的工程纪律,而非营销噱头。
本文基于吴恩达的 Agentic AI 课程,梳理了智能体技术的实用价值与学习路径。文章首先指出"agentic"一词遭到过度营销,但真正有价值的智能体应用(涵盖客户支持、深度研究、法律文档、医疗辅助等场景)正在快速增长。区分炒作与实用是入门第一课。课程最核心的方法论主张是:构建优质 Agentic AI 的真正分水岭,不是选用哪个框架,而是能否建立以 evals(评估)和错误分析为核心的纪律性开发流程。Evals 提供可量化的改进依据,错误分析帮助定位失败根因,两者共同构成从业余走向专业的关键。对开发者的建议是:先理解智能体工作流解决什么问题,再以评估驱动迭代,避免被营销术语主导学习方向。
从热词到实用:Agentic AI 的真实价值
当吴恩达(Andrew Ng)最初提出 "agentic"(智能体化)这个词,用来描述他观察到的一种正在快速兴起的应用构建趋势时,他并没有预料到这个词会被大量营销人员当作贴纸,几乎贴到了所有能看到的产品上。结果就是,围绕 Agentic AI 的炒作被推向了顶峰。
但抛开喧嚣不谈,一个更重要的事实是:真正有价值、有用的 Agentic AI 应用数量也在快速增长——尽管增速可能没有炒作那么夸张。这正是这门课程想要传递的核心信息:忽略泡沫,聚焦于用智能体工作流(agentic workflows)真正能解决的问题。
对于开发者而言,区分"炒作"与"实用"是入门 Agentic AI 的第一课。词汇会被滥用,但底层的工程能力和方法论才是长期价值所在。
Agentic 工作流能做什么
吴恩达在课程中列举了当下 Agentic 工作流正在支撑的一系列真实应用场景,这些例子勾勒出了智能体技术的实际落地边界:
- 客户支持智能体:自动处理用户咨询与问题解决;
- 深度研究(Deep Research):辅助撰写具有深刻洞察的研究报告;
- 法律文档处理:应对结构复杂、条款繁琐的法律文件;
- 医疗辅助诊断:分析患者输入信息,给出可能的诊断建议。
这些场景有一个共同点:它们大多超出了"单次调用大模型"能够胜任的范围,需要模型进行多步推理、调用工具、检索信息、迭代修正。这正是智能体工作流的用武之地。
吴恩达坦言,在他带领的许多团队中,很多项目如果没有智能体工作流根本无法实现。这句话的分量在于——Agentic AI 不只是锦上添花的技巧,而是让某些应用从"不可能"变为"可能"的关键能力。
核心方法论:Evals 与错误分析
课程中最具启发性的观点,是吴恩达对"高手"与"普通开发者"差异的判断。他指出,能否真正构建好 Agentic AI 应用,最大的分水岭在于——是否具备驱动一套有纪律的开发流程的能力,尤其是围绕评估(evals)和错误分析(error analysis)展开的流程。
为什么 Evals 如此重要
智能体系统往往由多个环节串联组成,任何一个环节的偏差都可能被放大。如果没有系统化的评估手段,开发者很难判断问题究竟出在提示词、工具调用、检索质量还是推理逻辑上。Evals 提供的是一套可量化、可复现的衡量标准,让"感觉变好了"变成"数据证明变好了"。
Evals(评估体系)在 AI 工程中的地位,类似于软件工程中的单元测试与集成测试。具体实践中,开发者通常会准备一批"黄金测试集"——即覆盖典型场景和边缘案例的输入-输出对,用来衡量系统在每次迭代后是否真正进步。常见的评估维度包括:任务完成率、响应准确性、工具调用的正确率、多轮对话的连贯性,以及端到端的延迟与成本。
对于 Agentic AI 而言,评估难度远高于单轮问答系统,因为智能体的执行路径具有不确定性——同一个任务可能经由不同的工具调用序列完成,传统的精确匹配评估难以适用。当前业界常见的应对方式包括:使用 LLM 作为评判者(LLM-as-a-Judge)对输出质量打分、基于轨迹(trajectory)而非最终答案进行评估,以及通过人工标注构建参考基准。
错误分析的实战价值
错误分析则是找到改进方向的手段。与其盲目调参或堆砌复杂逻辑,不如系统性地拆解智能体在哪些具体案例上失败、失败的原因是什么,然后有针对性地优化。这种"以数据和错误为驱动"的迭代方式,是从业余走向专业的关键区别。
对很多急于上手框架(如 LangChain、LangGraph)的学习者来说,这个提醒尤为宝贵:工具只是手段,纪律性的评估流程才是构建可靠智能体的根基。
学习 Agentic AI 的现实意义
吴恩达在课程开篇反复强调,掌握构建 Agentic AI 应用的能力,是当今 AI 领域最重要、最有价值的技能之一。这一能力既能带来实实在在的职业机会,也能让开发者独立构建出令人惊叹的软件。
从课程的整体框架来看,围绕 Agent、RAG、MCP、Skill、LangChain、LangGraph 以及多智能体协同等主题的系统学习,构成了一条从概念到工程实践的完整路径。而贯穿始终的"评估驱动开发"理念,则是这些技术能够真正发挥价值的方法论保障。
对于希望进入这一领域的开发者,建议不要被满天飞的营销术语迷惑,而是回到工程本质:先理解智能体工作流解决什么问题,再学会用 evals 和错误分析来验证和改进你的系统。这才是这门教程想要传递的最有价值的东西。
文中提到的 RAG(检索增强生成)和 MCP(多上下文处理/模型上下文协议)是构建实用智能体时频繁出现的两个关键技术支柱。RAG 的核心思路是在模型生成回答之前,先从外部知识库中检索相关文档片段,以此突破大语言模型训练数据截止日期的局限,并减少"幻觉"问题。在智能体场景中,RAG 通常作为一个可调用工具存在,智能体自主决定何时触发检索。
MCP(Model Context Protocol)是 Anthropic 于 2024 年推出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的连接方式,类似于为 AI 应用定义了统一的"插件接口"。通过 MCP,开发者可以让智能体以一致的方式调用数据库、文件系统、API 等异构资源,而无需为每个工具单独编写适配逻辑,从而显著降低多工具智能体的集成复杂度。
相关推荐
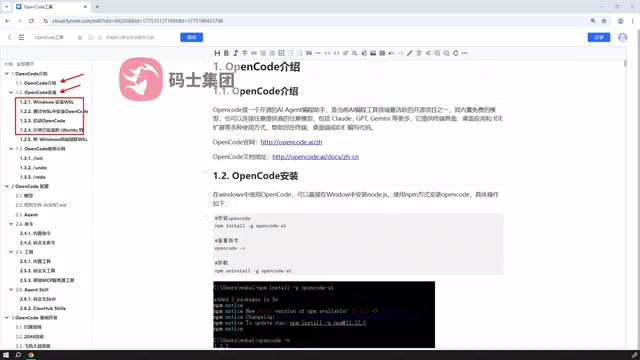
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
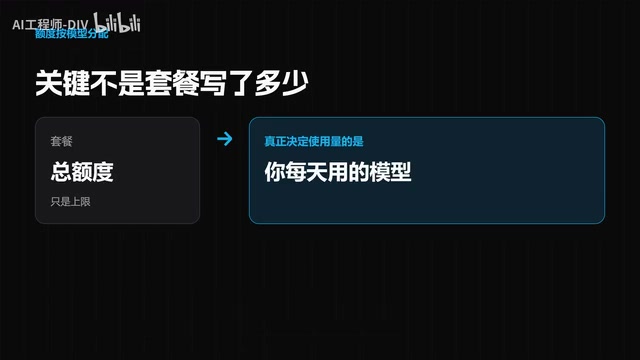
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
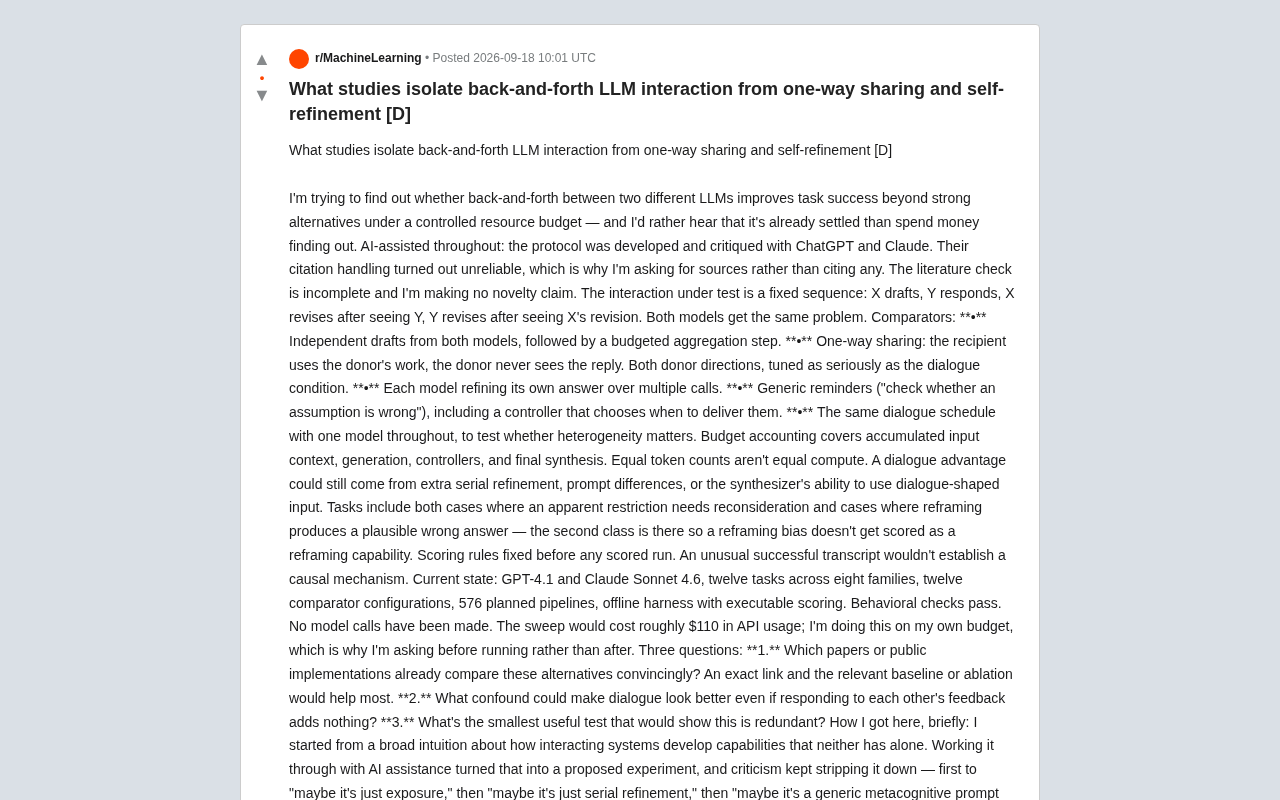
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。