小米MiMo-V2.6实测:登顶全球开源模型,价格仅为对手几十分之一
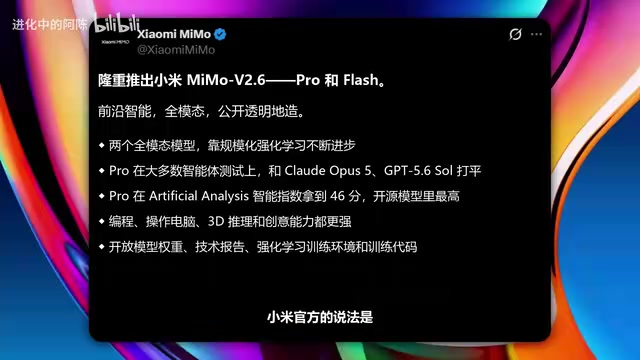
小米MiMo-V2.6 PRO登顶全球开源大模型榜单,以海外旗舰二十至六十分之一的价格实现对标性能,并全套开源训练环境。
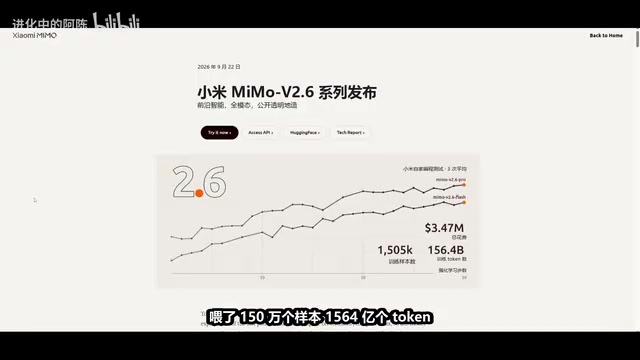
小米于2025年9月22日发布全模态大模型MiMo-V2.6,旗舰版PRO在海外独立评测榜单以46分登顶全球开源第一,较上代MiMo-V2.5 PRO的26分大幅提升20分,仅次于Claude、GPT等海外闭源顶级模型。在保持上一代定价不变的前提下(Pro版输入约2.9元/百万Token),官方宣称其成本仅为同等智能水平海外旗舰模型的二十至六十分之一。此次发布还同步开源了技术报告、强化学习训练环境与代码,并公开347万美元的RL训练账单。在实际演示中,模型展现出3D内容生成、物理仿真机械臂控制、游戏代码生成等多维能力,一段F1漂移场景的完整生成成本仅约两毛钱。短板主要在命令行任务与超长代码截断方面。
小米在9月22日突然发布全模态大模型 MiMo-V2.6,这款被外界称为"国产开源新王牌"的模型在权威榜单上拿下全球开源第一的成绩,同时把算力成本压到了同类旗舰的零头。提到开源大模型,过去大家最先想到的是 DeepSeek 或阿里的通义千问,而现在这份名单里恐怕要加上小米的名字了。
跑分登顶:从26分到46分的一代跨越
在海外一家独立评测机构的综合治理排行榜上,MiMo-V2.6 PRO 拿下 46 分,超过了 Kimi K3 和通义千问广告 3.8 Max,登顶全球开源第一。放眼整个行业,比它分数更高的只剩 5 个模型,全部是 Claude、GPT 这一档的海外闭源旗舰。
值得对比的是,上一代 MiMo-V2.5 PRO 在同一张榜上才 26 分,一代之间猛涨了 20 分。小米自己放出的跑分表更直观:在修真实代码的测试上,上一代只有 19 分,这一代直接冲到 71.9;在考真实职场任务的测试中它排第三,连 GPT-6 Astra 都被压在下面;在考自动化流程的测试上它排第二,再次把 GPT-6 Astra 和 Claude Ops 5 甩在身后。
小米官方的说法是,在大多数智能体测试上,MiMo-V2.6 已经能和 Claude Ops 5 这一档的旗舰正面对标。当然短板也摆在明处——在命令行里干活它只有 34.9 分,而 GPT-6 Astra 是 59.6 分,差距明显。
价格策略:聪明程度相当,成本仅为对手的几十分之一
如果把"聪明程度"和"做一道题的花费"放在同一张图上,MiMo-V2.6 稳稳站在又聪明又便宜的那一角,而海外几家顶级闭源模型则挤在最贵的右侧区域。
小米这次搞的是加量不加价,完全维持上一代的价格水平:Pro 版每百万 Token 输入约 2.9 元、输出约 5.9 元。官方称在同等聪明程度下,它的花费只有海外头部模型的二十分之一到六十分之一。被它超过的通义千问 3.8 Max 做同样的题,花费大约是它的 40 倍。
此外 Pro 版拥有整整 100 万 Token 的超大上下文窗口,并提供一个极速版本,输出最高能提速 20 倍,不过价格也要翻 10 倍。轻量版 MiMo-V2.6 Flash 则以极快的速度著称,目前已在海外平台免费开放测试。
Token 是大语言模型计费与上下文计算的基本单位,大致对应汉字或英文词的片段(通常1个汉字约等于1.5个Token,1个英文单词约等于1-2个Token)。"百万Token价格"是当前行业通行的定价标准。100万Token上下文窗口意味着模型单次对话可处理约75万汉字的内容,相当于一部中长篇小说,这对需要分析超长代码库、法律文件或多轮复杂任务的开发者而言至关重要。极速版输出提速20倍但价格翻10倍,折射出推理算力中"延迟"与"吞吐量"之间的工程权衡——加速通常需要为每个请求分配更多并行计算资源,边际成本随之上升。
训练账单与开源力度:把全套都晒了出来
这次最透明的地方在于,官方连强化学习这一轮的账单都公开了:一共花费 347 万美元(折合 2300 多万人民币),为了 150 万个样本、1564 亿个 Token。模型分数靠强化学习部署一路往上爬,走的是让模型自我进化的技术路线。
更关键的是,这次开源的不只是模型本身,连技术报告、强化学习用的训练环境和训练代码都一起放了出来。对整个开源生态而言,这意味着别的团队可以复现、改进乃至在相同环境里继续训练,门槛被显著拉低。
强化学习(Reinforcement Learning,RL)是一种让模型通过"试错—反馈—迭代"不断自我优化的训练范式,与传统的监督微调(SFT)不同,它不依赖人工标注的标准答案,而是让模型在执行任务后根据奖励信号判断行为好坏。近年来 DeepSeek广告-R1 等模型将 RL 大规模应用于推理能力提升后,这一路线被业界广泛验证:模型可以在没有额外人类示范的情况下,仅凭自身探索就涌现出更复杂的推理链。小米此次公开 347 万美元 RL 训练账单,并释出训练环境与代码,意味着外部团队可以直接在相同框架上继续"续训"——这种做法在 LLM 开源社区中相当罕见,因为训练环境往往比模型权重本身更难复现,也更具商业壁垒。
三维空间与物理推理:从机械臂到3D开放世界
官方放出的演示把三维空间与物理推理能力拉满。铅笔草图逐步生成的密体城堡、星空夜景、旋转木马与摩天轮的光影细节一应俱全;与国内团结引擎合作做出的 3D 开放世界,能骑马穿过大草原远眺雪山——测评者估计这种内容游戏开发者得写上好几个月,而模型几天就做出来了。
在英伟达的物理仿真环境里,它看着手腕和桌面两个摄像头的画面实时计算该往哪移、怎么转,自主推演并控制机械臂把红蓝方块放到对应位置,稳稳完成任务。从 3D 平台跳跃游戏到即时战略游戏里的坦克开火,再到揭开防尘盖、放上黑胶、切换转速的唱片机 3D 产品图,全都由模型自主生成。
英伟达的物理仿真环境指的是 Isaac Sim 或类似的机器人仿真平台,它能在虚拟世界中精确模拟重力、摩擦、碰撞等物理规律,让 AI 在无需真实硬件的情况下完成大量操控训练。将大模型与物理仿真结合,代表了"具身智能"(Embodied AI)的一条主流技术路径:模型不只处理文字或图片,还要理解三维空间关系并输出可执行的动作序列。多摄像头融合感知(如文中提到同时看手腕与桌面两路画面)是当前工业机械臂和服务机器人的常见配置,它能减少单一视角的遮挡盲区,提升空间推理精度。小米在此场景的演示,暗示其模型已初步具备从视觉感知到动作规划的闭环能力,这是走向实体机器人应用的关键一步。
开发者实测:从索尼克跑酷到F1漂移
官方演示再漂亮也得看第三方上手。海外开发者直接用它手搓出一款索尼克风格的 3D 跑酷游戏,绿色棋盘格跑道、金色圆环、弹簧起跳、计分系统一应俱全,而且完全能在浏览器里实机游玩。

在一个专门给 AI 出题打分的评测平台上,它为英伟达 RTX 5090 写产品页,用纯代码画出可旋转的 3D 显卡,内部均热板和散热风道都做成了动画。不过平台的 AI 评委指出它"野心很大但最终失败"——代码写得太长被截断,好几个交互功能用不了。
最炸裂的是一段 F1 赛车街头原地漂移画圈的演示:单个网页文件一口气输出了四万三千多个 Token,红色赛车甩尾冒烟、地上流下胎印、多机位切换、漂移积分与慢动作回放一应俱全,整套生成下来才花了两毛多钱。
系统复刻与审美表现
在复杂系统模拟上,它完整复刻了经典的 Windows 95 桌面,包含开始菜单、我的电脑、扫雷,甚至能打开复古老网页和 DOS 命令行。测评者坦言,细节做到这么全,原本只指望 GPT-6 Astra、Claude Fable 这类顶级闭源模型才做得到。
当然瑕疵也有:处理复杂的纽约港动画时,把本该横跨河面的大桥画到了楼顶上,车看着像在楼顶飞。但在 9 万多 Token 的体量下,它实现了拖动时间轴呈现日出到子夜的月相、潮汐与车流变化。
视觉审美上同样令人印象深刻:杂志排版风格的编辑部落地页、浮动树枝的动态油画、粒子翻滚的艺术画板,彻底摆脱了传统 AI 生成的千篇一律模板。小米官方放出的海岛经营游戏《总统之岛》也由模型自己做出,玩家能在三维海岛上分门别类盖房子、管资金、顾民众支持率。
结语:把智能做便宜的破局思路
MiMo-V2.6 真正的意义不只是跑分登顶,而是把高水平智能的使用成本压到了十分之一级别,并且把训练环境和代码一股脑开源。当国产开源模型开始自主推演物理空间、手搓 3D 游戏、在仿真世界里指挥机械臂,开源生态被砸出了一条新路。通用人工智能走向现实的下半场,或许正属于那些真正能把智能做便宜、让它落进生活的玩家。
相关推荐

OpenAI Agents SDK 实战:如何实现 Human-in-the-Loop 人工审批
基于 OpenAI Agents SDK 实现 Human-in-the-Loop 人工审批机制的完整教程:从 needs_approval 暂停工具调用、捕获 interruptions 中断,到 approve/reject 决策与 RunState 状态序列化恢复,让 AI Agent 在执行高风险操作前先征得人类同意。

MaRN开源:用低维参数映射训练神经网络的PyTorch库
开源PyTorch库MaRN通过低维参数映射训练神经网络,MNIST CNN参数压缩57.7倍仍保持91.8%准确率。本文解析其基准测试、功能构成与适用场景。

NeurIPS SAC门票不可转让引讨论:政策变动惹争议
NeurIPS SAC 门票是否仍可转让引发 Reddit 机器学习社区热议。本文梳理政策变动争议、收紧背后的可能原因及对参会者的实用建议,帮助研究者正确应对顶会票务管理变化。