小模型逆袭:微调0.8B SLM在语法标注上击败GPT-5.4

微调0.8B小模型在语法标注上反超GPT-5,成本降低16倍,学习参与度提升15.8%。
一项发布于arXiv的研究针对在线语言教育平台的规模化语法掌握度追踪问题,提出了一套以微调小语言模型替代调用前沿大模型API的工程方案。研究团队在教师生成的监督数据上对Qwen3.5系列(主力为0.8B版本)进行微调,将语法标注契约内化进适配器权重,从而用紧凑提示替代冗长指令,大幅降低推理开销。评测结果显示,0.8B和4B微调模型在精度与召回上均超过被提示的GPT-5.4和GPT-5.6 Sol,且随匹配标准趋严优势依然成立。部署后服务成本降低约16倍,在线实验显示学习者参与度提升15.8%、预约课时增长2.1%、新课程GMV增长13.2%。该研究为"垂直任务上微调小模型优于通用大模型"这一工程范式提供了完整的技术与业务闭环验证。
当语法纠错遇上规模化难题
纠正性反馈(corrective feedback)是公认的二语习得最有效驱动力之一。但在真实的语言教学场景里,老师在课堂上随口给出的纠正往往零散而短暂,很难汇聚成一张可操作的语法掌握度全景图。学习者需要的不只是“这句话说错了”,而是“你在哪类语法概念上反复出错、掌握程度如何”。
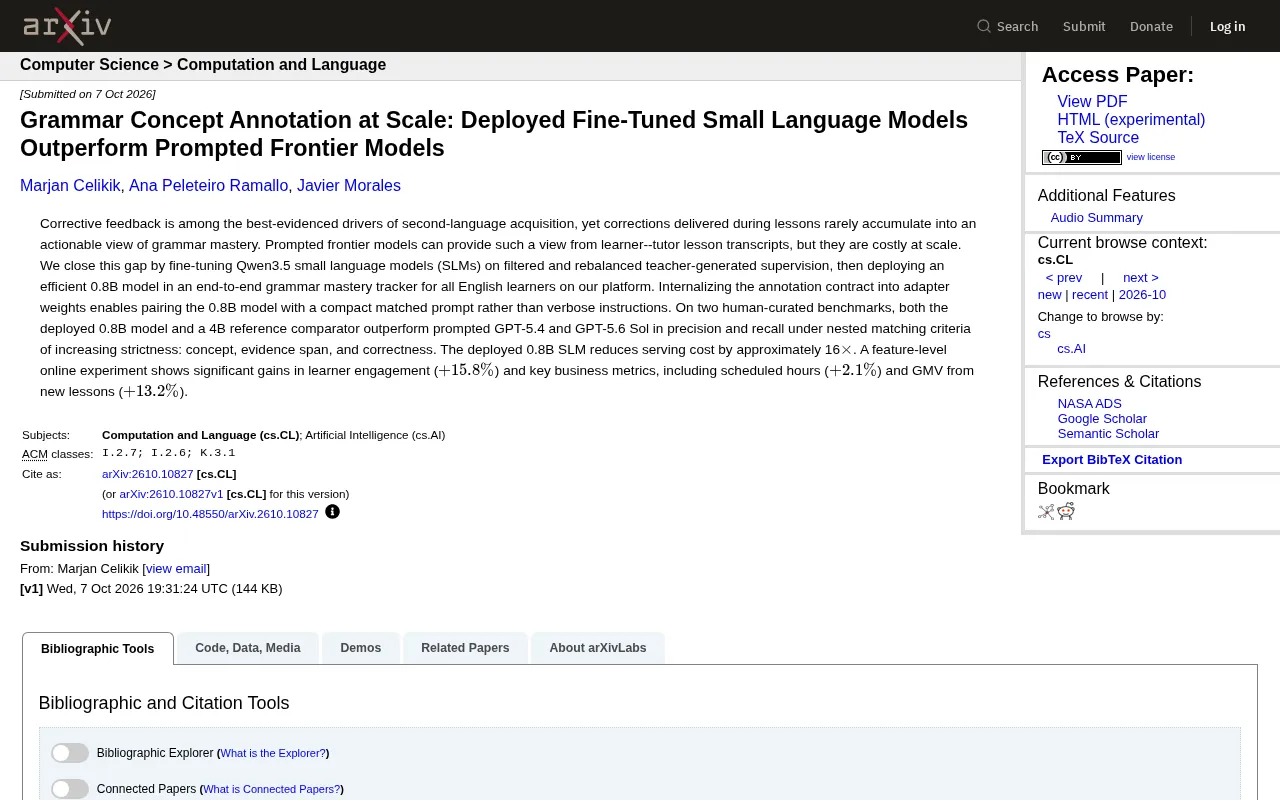
一篇新发布于 arXiv 的研究(arXiv:2610.10827)正是瞄准了这一痛点。研究团队指出,直接用提示(prompting)驱动的前沿大模型确实能从师生课堂转录文本中生成这样的掌握度视图,但代价是——在平台级规模部署时成本高得惊人。他们给出的答案出人意料:微调后的小语言模型(SLM)不仅能顶上,还能在精度与召回上反超被提示的前沿模型。
二语习得(Second Language Acquisition,SLA)研究中,纠正性反馈分为几种主要形式:明确纠正(explicit correction,直接告知错误并给出正确形式)、重铸(recast,用正确形式重述学习者的话而不明确指出错误)、元语言反馈(metalinguistic feedback,提示语法规则但不直接给出答案)等。其中,元语言反馈因能促进学习者主动加工语法规则,往往被认为效果更持久。然而,无论哪种形式,传统课堂反馈的共同瓶颈是"颗粒度粗、留存率低"——教师在实时对话中难以系统记录每位学习者在特定语法概念(如动词时态、冠词使用、从句结构)上的错误模式,遑论跨多节课的纵向追踪。这正是计算机辅助语言学习(CALL)长期试图解决的问题:如何把散落在真实互动中的语言错误信号,聚合成可操作的个性化诊断。
用 0.8B 小模型跑通端到端语法追踪
研究团队的核心做法,是在经过筛选和重新平衡的教师生成监督数据上,对 Qwen3.5 系列小语言模型进行微调,随后把一个高效的 0.8B 模型部署到平台上,为所有英语学习者提供端到端的语法掌握度追踪。
这里有一个值得玩味的工程细节:当标注契约(annotation contract)被内化进适配器权重后,0.8B 模型就不再需要冗长的指令提示,而是可以搭配一段紧凑、匹配好的提示工作。换句话说,模型把“该怎么标注”这件事学进了参数里,省下了每次推理都要重复喂入的长指令——这既降低了 token 开销,也让小模型在特定任务上更稳定。
这种“把规则烧进权重”的思路,正是当前小模型落地的典型范式:不追求通用能力的全面,而是针对单一垂直任务做深度专精。
这里提到的"适配器权重"(adapter weights)指的是参数高效微调(PEFT)技术中的低秩适配器(LoRA,Low-Rank Adaptation)或类似机制。与全量微调不同,适配器微调只在原始预训练权重之外插入少量可训练参数,冻结主干模型的大部分权重。这样做有两个关键好处:一是训练成本大幅降低,不需要对数十亿参数全部反向传播;二是"任务知识"被集中封装在适配器层中,原始模型能力得以保留,方便在不同任务间切换。当研究者说"标注契约被内化进适配器权重"时,意思是模型通过监督数据训练,把"什么算一个合格的语法概念标注、如何定位证据片段、如何判断正误"这套规则编码进了这些轻量参数中,而无需在每次推理时通过长系统提示重新"解释规则"。
两套基准下的硬碰硬
评测环节是这篇研究最有说服力的部分。团队在两套人工精选的基准上,采用了层层加码的嵌套匹配标准:
- 概念(concept):是否命中了正确的语法概念
- 证据片段(evidence span):是否定位到正确的文本证据
- 正确性(correctness):对错判断是否准确
结果显示,无论是部署的 0.8B 模型,还是作为参照的 4B 版本,在精度(precision)和召回(recall)上都超过了被提示的 GPT-5.4 以及 GPT-5.6 Sol。随着匹配标准越来越严格,小模型的优势依然成立。
这个结果打破了一个常见直觉——参数量越大就一定越好。在边界清晰、监督数据质量过硬的专精任务上,一个被精心微调的小模型完全可以压过通用的前沿巨头。关键不在于模型多大,而在于它是否真正“对齐”了任务的标注逻辑。
成本与业务指标:工程落地的真正价值
如果说精度反超是技术亮点,那么成本与业务数据才是让这套方案真正值得部署的理由。
论文给出的数字相当直观:部署的 0.8B SLM 将服务成本降低了约 16 倍。对一个需要为平台上所有英语学习者持续运行的追踪系统而言,这种数量级的降本意味着从“跑不起”到“跑得起”的质变。
更难得的是,团队还做了特征级的在线实验,拿到了实打实的业务收益:
- 学习者参与度提升 +15.8%
- 预约课时增长 +2.1%
- 新课程带来的 GMV 增长 +13.2%
技术指标好看不代表能转化为用户价值,但这组线上数据把语法掌握度追踪这件事和真实的学习行为、商业结果直接挂上了钩。参与度的双位数提升说明,当学习者能看到清晰的语法掌握全景时,他们确实更愿意持续学习。
GMV(Gross Merchandise Volume,商品交易总额)是电商与在线教育平台常用的营收规模指标,反映在一定时期内通过平台完成的总交易金额,而非平台实际到手收入。在在线教育场景中,新课程 GMV 增长 +13.2% 意味着因语法掌握度追踪功能上线,学习者购买新课程的总金额提升了这一比例,这是衡量功能对商业变现贡献的直接依据。在线实验(A/B 测试)在此类评估中至关重要:通过对照组与实验组的随机分配,可以将参与度、预约量、GMV 的变化归因于该功能本身,而非其他同期因素的干扰。能同时给出技术指标与在线 A/B 实验业务数据的论文,在 NLP/EdTech 领域仍属相对少见,这也是本研究说服力较强的原因之一。
给行业的启示
这项研究提供了一个颇具代表性的样本:在明确的垂直任务上,微调小模型 + 高质量监督数据,正在成为比“调用大模型 API”更经济、甚至更准确的方案。
对于教育科技、客服、内容审核等需要规模化处理结构化判断任务的场景,这条路径尤其值得参考。它背后的逻辑链条清晰:筛选并重新平衡监督数据 → 微调小模型内化任务契约 → 用紧凑提示降低推理开销 → 部署并以在线实验验证业务价值。
前沿大模型依然是强大的通用底座和原型验证工具,但当任务定型、需要规模化部署时,一个被打磨到位的小模型往往才是更务实的终点。
相关推荐

Reddit帖子被删引发AI内容审核争议
Reddit一则帖子被平台以违反内容政策为由删除,页面仅显示移除提示。事件折射出AI内容审核系统在透明度、误判风险和申诉机制方面的普遍困境,值得内容平台与创作者关注。

DSH+Ollama本地部署大模型实战:免费对话大肥鱼
B站UP主实测DSH+Ollama本地部署大模型全流程:从Ollama安装、迅雷加速下载、魔搭GGUF模型导入,到DSH自定义API地址配置,并对比千问3.5 4B、8B、Gemma等模型在8G显存下的表现,给出本地部署与API调用的选择建议。

899元Mac Mini实测:能替代200美元AI订阅吗?
实测M4 Mac mini能否替代200美元AI订阅:16GB内存装不下大模型,速度与质量均有差距,但隐私、无上限和近零运行成本让它成为常驻智能体的理想宿主。附各配置选购建议与省钱策略。