Codex配置实战:国内低成本接入GPT-5.5完整教程

为什么Codex值得关注
随着大模型编程能力的持续进化,命令行AI编程工具正在成为开发者的新宠。OpenAI推出的Codex系列工具,配合GPT-5.5这类新一代模型,能够在本地环境中直接生成、修改文件,大幅降低了从「复制粘贴代码」到「AI自动执行」的操作门槛。
对于国内开发者而言,最大的痛点一直是模型访问的稳定性与成本问题。本文核心思路是通过第三方API中转网站接入最新模型,从而实现相对低成本的使用体验。以下将梳理这类配置流程的技术逻辑,帮助读者理解Codex类工具的工作方式。

Codex是什么
简单来说,Codex是一类将大模型能力集成到本地开发环境的命令行工具。与在网页端手动向对话框粘贴代码不同,Codex可以直接读取项目文件、理解上下文,并在本地一键生成或修改代码文件。这种「Agent化」的工作方式,正是当前AI编程工具演进的重要方向——从被动应答转向主动执行。
Codex最初是OpenAI于2021年发布的专门针对代码生成的语言模型,其底层架构基于GPT系列,通过在GitHub等大规模代码语料库上进行微调训练而来。随着GPT-4及后续模型的能力跃升,「Codex」的概念也从单一的代码生成模型演变为一类工具形态。这类Agent工具的核心技术突破在于**工具调用(Function Calling/Tool Use)**与上下文窗口的扩大,使得模型不再局限于文本输出,而是能够主动调用本地文件系统、执行终端命令、乃至发起网络请求,真正实现从「语言生成」到「任务执行」的范式转变。
工具调用机制详解:工具调用的理论基础来自谷歌研究院于2022年提出的ReAct(Reasoning + Acting)框架。ReAct由Shunyu Yao等人发表于ICLR 2023,其核心贡献在于将「链式思维(Chain-of-Thought)」推理与外部环境交互统一在同一生成序列中——与单纯的CoT提示不同,ReAct的行动步骤会产生真实的外部副作用(如查询维基百科、执行Python代码),观察结果作为新的上下文输入反哺模型推理。ReAct的核心思想是将推理过程与外部行动交织在一起,形成「思考→行动→观察」的迭代循环——模型在推理链中插入真实的外部操作(如读取文件、执行命令),并根据操作结果动态调整后续推理路径,这一框架被认为是从「语言模型」到「语言智能体」的关键转折点。OpenAI将这一思想工程化落地为Function Calling(后更名为Tool Use):开发者在API请求中预定义工具的JSON Schema,模型需要调用工具时输出符合Schema的结构化指令,由外部运行时捕获并执行,再将结果反馈给模型继续推理,形成完整闭环。上下文窗口的扩大同样不可忽视——从早期GPT-3的4K Token到GPT-4 Turbo的128K Token,使得模型能够在单次对话中容纳整个代码文件乃至多文件项目结构,是Agent工具实现跨文件理解与修改的基础设施前提。值得一提的是,Agent化范式的另一重要支撑是**结构化输出(Structured Output)**能力的成熟:模型能够可靠地生成符合预定义JSON Schema的响应,使工具调用的指令解析从启发式字符串匹配升级为确定性的模式验证,显著降低了Agent执行流程中的错误率。
分步配置流程详解
整个配置过程大致分为三个阶段:获取API密钥、安装客户端工具、绑定模型并启动。
第一步:注册并获取API密钥
首先进入目标API中转网站完成注册。新用户通常可以领取一定额度的Token用于体验模型调用。
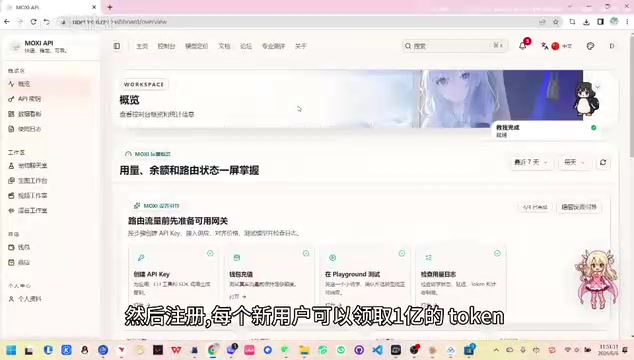
Token是大语言模型处理文本的基本计量单位,并非等同于字符或单词。OpenAI采用BPE(Byte Pair Encoding)算法——这是一种源自数据压缩领域的子词分割技术,最初由Philip Gage于1994年提出用于文本数据压缩,其核心逻辑是通过贪心合并高频字节对来减少序列长度。在NLP领域,BPE解决了词表设计中的两难困境:纯词级词表面临未登录词(OOV)问题,纯字符级词表则导致序列过长、计算成本激增。BPE的子词粒度在两者之间取得平衡——常见词被完整保留为单一Token(如"the"、"function"),罕见词则被拆分为可复用的子词片段(如"tokenization"→"token"+"ization")。BPE从单字符词表出发,通过统计语料中相邻字节对的共现频率迭代合并,最终生成兼顾覆盖度与词表大小的平衡词元集合。OpenAI的tiktoken分词器基于BPE改进变体构建:GPT-4系列采用cl100k_base词表(约10万词元),GPT-4o系列升级至o200k_base(约20万词元),后者对中文等非拉丁语系的分词效率有所提升,但中文单字仍普遍独立成Token。这一特性导致中文使用成本显著高于英文——英文文本1个Token约对应4个字符,而中文通常1个汉字对应1-2个Token,由于汉字本身就是高度语义自足的最小单位,BPE通常不会进一步合并,导致中文Token密度(语义信息/Token数)远低于英文,这是中英文Token消耗量差距的根本原因,也是计费时需要特别注意的结构性差异。
OpenAI官方对输入Token(Prompt)和输出Token(Completion)分别计费,GPT-4o级别的模型目前官方定价约为每百万输入Token 2.5美元、输出Token 10美元。所谓「一亿Token免费」,若换算为实际使用量——一次包含1000行代码的上下文输入约消耗3000-5000 Token,单次任务即可消耗近万Token——大约相当于完成数千次中等规模的代码生成任务。这一数字表面看起来丰厚,但需结合中转平台的商业模式综合评估:若平台自身调用的是OpenAI官方API,其边际成本与官方定价挂钩,大幅低价或免费策略必然依赖数据收集、流量变现或订阅增值服务等其他收入来源,免费额度往往是获客手段而非长期承诺。
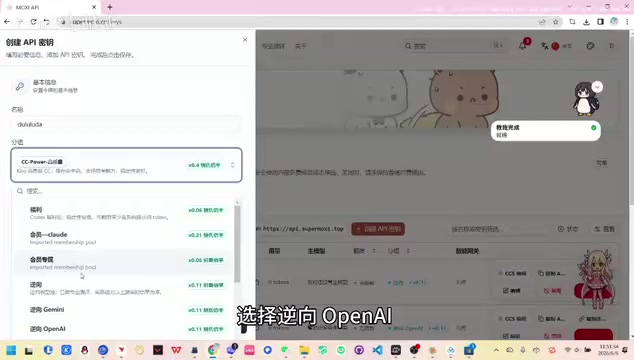
注册完成后,进入「API密钥」页面,点击「创建API密钥」,为密钥设置自定义名称。关键一步是在接口类型中选择「逆向OpenAI」——即兼容OpenAI官方API格式的转发方式,让本地工具能够无缝对接。保存更改后,密钥即可投入使用。
所谓「逆向OpenAI」接口,是指第三方平台通过模拟OpenAI官方API的请求格式与响应结构,构建出与官方完全兼容的中转服务。OpenAI的Chat Completions API遵循RESTful架构风格,核心端点为POST /v1/chat/completions,请求体采用标准JSON格式,必填字段包括model(模型标识符)和messages(含role与content的对话历史数组),响应体则包含choices(生成内容)、usage(Token消耗统计)和finish_reason(生成终止原因)等核心字段。这套接口规范已事实上成为AI推理服务的行业标准——Anthropic的Claude、本地推理框架Ollama等均提供高度兼容的接口,这也正是第三方中转服务得以快速复制的技术前提:只需实现相同的路由路径和JSON Schema,本地客户端工具即可无缝切换至中转服务商,无需修改任何代码。
API兼容标准的行业影响:OpenAI API格式的事实标准化地位,深刻影响了整个AI工具链生态的演进方向。从软件工程角度看,这是一种典型的「接口即协议」设计:标准化的HTTP端点与JSON Schema充当了模型能力与应用层之间的解耦契约,使底层推理后端的替换对上层工具完全透明。这一兼容层不仅催生了大量中转服务,更推动了本地推理框架(Ollama、vLLM、LM Studio)、企业私有化部署方案乃至各类开发者工具的快速涌现——它们只需对接一套接口规范,即可适配市面上绝大多数主流模型。然而,标准化的代价是同质化竞争——当所有服务都提供相同的接口,差异化只能依赖模型质量、价格策略与服务可靠性,这也是中转服务市场高度碎片化、优胜劣汰加速的根本原因。值得注意的是,这种兼容设计也为安全边界的模糊化埋下伏笔:接口协议的透明性意味着中间节点对请求内容具有完整可见性,这与传统加密通信协议(如TLS)在传输层保护数据内容的思路形成根本性矛盾——即便使用HTTPS,中转服务器作为TLS终结点仍可完整读取明文请求体。
然而,这种兼容层在网络架构上构建了一条完整的中间链路:本地客户端 → 中转服务器(具备完整请求内容可见性)→ 实际推理后端 → 返回响应。任何经过中转节点的代码片段、业务逻辑乃至密钥字符串都存在被记录的隐患。
第二步:安装CCS与Codex
下一步是下载并安装两个核心组件:CCS配置工具和Codex主程序。CCS承担配置管理器的角色,负责将API密钥、模型选择等参数自动写入Codex的配置文件,省去手动编辑的繁琐步骤。
Windows用户也可直接在微软应用商店搜索「Codex」下载安装。完成后即可进入配置环节。
第三步:绑定GPT-5.5模型并启动
打开CCS编辑器,选择Codex作为目标工具,在模型列表中选择GPT-5.5,CCS将自动完成配置文件的写入。
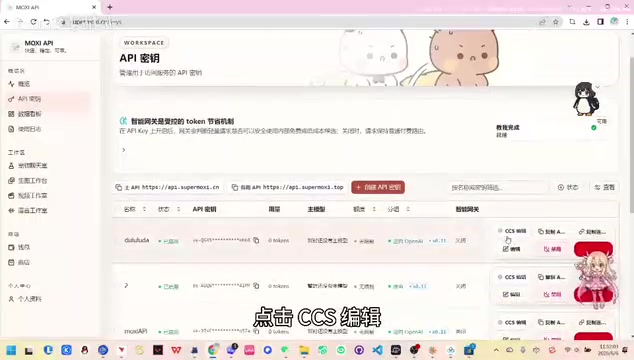
配置完成后,切换回CCS点击「启动」,Codex便会自动匹配到所选模型。此时即可在本地环境中正常使用Codex的AI编程能力,无需再反复往对话框粘贴代码片段。
这类方案的价值与风险
效率提升是真实的
从工作流角度看,Codex这类本地Agent工具确实解决了核心痛点。传统模式下,开发者需要在网页端和IDE之间频繁切换,手动搬运代码片段;而Codex可以直接读取本地项目结构、生成完整文件,让AI真正融入日常开发流程,编码效率的提升是显而易见的。
需要理性看待的几个问题
然而,「第三方API中转 + 逆向接口」方案也存在明显隐忧,使用前应保持清醒认识:
一是稳定性与合规性。 第三方中转网站的服务质量无法保证,「逆向OpenAI」接口本质上属于非官方渠道,随时可能因封禁而失效。「海量Token免费」的宣传,同样需要审慎评估其商业模式的可持续性。
二是数据安全风险。 将API请求和代码内容经由不明第三方中转,意味着代码可能被记录或滥用。涉及商业机密或敏感业务的项目,这种风险不可忽视。由于兼容层在技术上对请求内容完全透明,任何经过中转节点的代码片段、业务逻辑乃至密钥字符串都存在泄露隐患。对于企业开发者,此类风险还可能触发合规层面的数据主权与隐私保护法规约束——例如GDPR要求数据处理具备明确的法律依据与数据流向透明度,而国内《数据安全法》与《个人信息保护法》同样对涉及业务数据的境外传输设有限制,使用来源不明的中转服务可能使企业在无意中触碰合规红线。
三是模型真实性存疑。 宣称提供「满血GPT-5.5」等服务的中转平台,实际调用的模型是否名副其实,往往难以验证。这一问题的根源在于当前AI推理服务缺乏标准化身份验证机制——大模型推理本质上是一个概率生成过程,无法像传统软件那样通过哈希校验来验证「执行体」的完整性。由于OpenAI API响应体中仅返回请求时指定的model字段而非经过密码学签名的模型身份证明,中转平台完全可以在响应中填写任意模型名称,而实际使用更低成本的模型。学界已有若干探索方向,包括基于「模型水印(Model Watermarking)」的被动验证——在训练阶段将特定统计模式嵌入模型输出分布中,以及基于「模型指纹(Model Fingerprinting)」的主动探测——通过精心设计的输入输出对来识别特定模型的行为特征。然而,这些方法均未形成产业标准,且在中转场景下面临响应被篡改的对抗性威胁。目前业界缺乏标准化的模型身份验证机制,开发者只能通过特定基准题目(如知识截止日期测试、特定能力边界探测)进行有限的侧面验证,无法从根本上解决模型真实性问题。
更稳妥的长期选择
对于希望长期稳定使用AI编程工具的开发者,建议优先考虑官方渠道或信誉可靠的正规服务商。成本虽然相对更高,但在稳定性、数据安全和模型可信度上均有保障。
此外,本地部署开源代码模型也是兼顾隐私与成本的可行路径。当前主流的开源代码模型包括Meta的Code Llama系列(参数规模从7B到70B不等)、DeepSeek广告 Coder、以及Mistral旗下的Codestral等。
本地部署的可行性在过去两年内因量化技术的成熟而大幅提升。量化(Quantization)的本质是将模型权重从高精度浮点数(FP32/BF16,每参数占2-4字节)压缩为低比特整数表示(INT8/INT4,每参数占0.5-1字节)。神经网络量化的理论依据在于模型权重的统计分布特性——大型语言模型的权重值通常呈现近似正态分布,极端值(outlier)占比极低,这使得用较少比特位近似表示大多数权重成为可能。GPTQ(Generative Pre-trained Transformer Quantization)采用逐层量化策略,通过Hessian矩阵近似最小化量化误差;AWQ(Activation-aware Weight Quantization)则在此基础上进一步识别对激活值影响较大的「显著权重」并给予更高精度保护,在相同比特数下获得更好的性能保留。研究表明在GPTQ、AWQ等算法下,4-bit量化模型的性能损失通常在1-3%以内,且量化对不同任务的影响并不均匀:代码生成任务(尤其是语法正确性要求高的场景)对量化误差相对鲁棒,而需要精确数值推理的数学任务则更为敏感——这一特性使得量化模型在编程辅助场景中的实用性高于其在综合基准测试中的评分所暗示的水平,是本地部署代码模型性价比较高的重要原因。
GGUF格式(由llama.cpp项目推广)由Georgi Gerganov提出,是对早期GGML格式的重大升级,其核心设计目标是「自描述性」——将模型权重、量化参数、分词器词表、超参数和特殊Token映射等所有运行所需元数据打包为单一文件,使模型分发与加载无需额外配置文件,并支持CPU/GPU混合推理(部分层卸载至显存)。这一设计极大降低了本地部署的工程门槛,使7B参数模型的显存需求从约14GB降至4-6GB,消费级GPU即可承载,也是Ollama等框架能够实现「一命令拉取运行」体验的基础设施前提。Code Llama系列具备Fill-in-the-Middle(FIM)能力,可根据光标前后文本填充中间代码,适合IDE补全场景;DeepSeek Coder在多个代码基准测试(如HumanEval、MBPP)上表现接近同参数规模的商业模型,且对中文注释场景的理解能力更优。
借助Ollama、LM Studio等本地推理框架——Ollama通过封装llama.cpp后端并暴露与OpenAI API完全兼容的本地HTTP服务端口(默认localhost:11434),使现有基于OpenAI SDK的工具链(包括Codex)可以零改动切换至本地推理后端,将原本需要手动配置推理参数的流程简化为单条命令行——普通消费级GPU(如RTX 3090/4090)即可运行7B至13B参数的量化模型,代码补全和简单生成任务的响应速度完全满足日常开发需求。
这类方案的核心优势在于:代码数据完全不离开本地环境,且无需订阅费用,一次部署长期可用。代价是相比GPT-4级别的商业模型,在复杂逻辑推理和跨文件理解能力上仍存在差距。具体而言,本地7B-13B量化模型在单函数级别的代码生成、bug修复和代码解释任务上表现较好,但在需要跨模块依赖分析、架构设计建议或理解大型代码库全局结构的场景下,与GPT-4o等商业旗舰模型仍有可感知的差距。实际使用中,不少开发者采用「本地模型处理日常补全+商业API处理复杂任务」的混合策略,在成本控制与能力上限之间取得平衡。
Codex类Agent工具所代表的技术方向无疑值得期待——AI正从「问答助手」进化为「能动手的开发伙伴」。理解其工作原理,选择可靠的接入方式,才能真正把握这波AI编程生产力变革的红利。
核心要点
- Codex类工具的本质是将ReAct范式工程化落地——通过工具调用与扩大的上下文窗口,实现从「语言生成」到「任务执行」的范式转变;ReAct框架发表于ICLR 2023,其核心贡献在于将链式思维推理与真实外部行动统一在同一生成序列中
- Token计费的结构性差异:中文使用成本显著高于英文,BPE分词机制决定了汉字普遍1字对应1-2 Token,评估「免费额度」价值时需将此纳入考量
- 兼容层是双刃剑:OpenAI API事实标准化降低了工具切换门槛,但也使中转服务对请求内容完全透明——即便使用HTTPS,中转服务器作为TLS终结点仍可完整读取明文请求体,代码数据安全与模型真实性验证是无法回避的隐患
- 本地部署已具备实用性:GPTQ/AWQ量化技术将4-bit量化性能损失控制在1-3%以内,GGUF格式的「自描述性」设计使单文件包含所有运行所需元数据,配合Ollama框架使消费级GPU可承载7B-13B代码模型,且与现有Codex工具链零改动兼容
- 混合策略是务实选择:本地模型处理高频日常补全任务,商业API应对复杂跨文件推理需求,在隐私保护、成本控制与能力上限之间寻求动态平衡
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。