英特尔Connection 2026大会:AI时代如何赋能开发者

英特尔借助OpenVINO首日适配与端云协同范式,将AI能力落地到本地硬件,构建开发者生态闭环。
英特尔正通过技术与生态两条线推动AI能力的本地化落地。技术层面,OpenVINO工具套件为通义千问Image 2.1、MiniCPM 5 2B等新模型提供首日硬件适配,使开发者能在AIPC的CPU/GPU/NPU上零token成本地运行AI推理;端云协同范式则将云端大模型(负责任务规划与验收)与端侧算力(负责高频执行)的优势有机结合。生态层面,英特尔联合火山引擎、魔搭、荣耀等伙伴发布大使计划、开发者社区与创新大赛,并通过线下工作坊和选手作品展示,将AI落地从技术示范推向真实业务场景,标志着英特尔从硬件厂商向AI开发者生态核心节点的角色转型。
提到英特尔,多数人会想到电脑上那张熟悉的处理器标签。从手边的笔记本到网站背后的服务器,英特尔的芯片一直支撑着我们熟悉的数字世界。而进入AI时代,这家芯片巨头的角色正在悄然转变——它不只是提供算力的硬件厂商,更想成为连接模型、智能体与开发者的生态搭建者。
在英特尔Connection 2026大会的AI开发者区,这种转变被具象成了一个个可以上手体验的应用。B站UP主Everett(胡同学)实地探访现场后,呈现了英特尔在AI落地环节的几条清晰思路。
模型首日适配:让新能力更快跑在本地硬件上
每当新模型发布,人们的第一反应往往是「它又变强了多少」。但模型能力再强,真正要用起来还得解决一个现实问题:怎么让它在具体的电脑上跑得好、跑得快。这正是英特尔在做的核心工作之一。
现场重点介绍的通义千问广告 Image 2.1 已经获得了 OpenVINO 在英特尔硬件平台上的 Day 0(首日)支持,让开发者能够在模型发布的第一时间就开始尝试。类似地,来自面壁智能的端侧模型 MiniCPM 5 2B 也同步跟进了适配,已经可以在端侧实现本地的工具调用等 Agent 任务。
现场基于 MiniCPM 5 2B 的能力,展示了一个端侧的桌面小应用,用户可以直接在应用中与模型进行互动——所有推理都在本地完成。
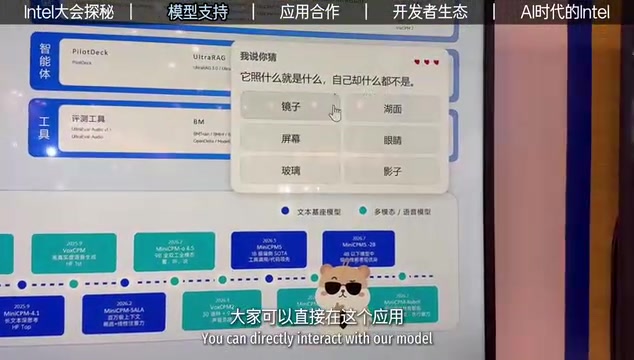
这种「模型首日支持」的策略意义不小。它缩短了从模型发布到开发者可用之间的时间差,让国产模型与英特尔硬件之间形成更紧密的协同。
"Day 0支持"(首日支持)是芯片生态竞争中的重要指标。模型发布后,若没有对应硬件平台的优化适配,开发者即便下载了权重也难以流畅运行——可能遇到算子不兼容、精度损失、速度过慢等问题。英特尔通过提前与模型团队协作,在模型公开发布的同一天推出OpenVINO适配版本,本质上是压缩了"模型可用"与"模型好用"之间的时间差。MiniCPM 5 2B中的"2B"指模型参数量约为20亿(2 Billion),这一规模经过专门的端侧优化后,可以在消费级AIPC的NPU上实现实时推理,同时支持工具调用(Tool Use)等复杂Agent能力——工具调用允许模型在对话中主动调用外部函数或API,是构建自主智能体应用的基础能力之一。
OpenVINO 与 AIPC:本地运行、零 token 成本
开发者区还有不少能直接上手玩的应用。一款借助 Trae 开发的体感小游戏,玩家在摄像头前做出健身练肩的动作,屏幕里的「黄金矿工」就能同步放出绳索淘金;旁边的霓虹打砖块则用到了 OpenVINO。
这些游戏背后体现的,是英特尔 AIPC 的开发优势。借助英特尔开源的 OpenVINO AI 软件套件,配合模型的首日支持,开发者可以在最新 AIPC 硬件的 CPU、GPU、NPU 上构建这类互动应用。关键在于,它们完全可以在本地运行,用户不用承担任何 token 的费用开销。
把智能体模型和芯片的分工看清楚,也就更容易理解英特尔与 Trae、Marvis 这类 Agent 伙伴的合作逻辑:模型负责智能,芯片负责高效承载,而本地化运行则直接消除了云端调用的成本顾虑。
OpenVINO(Open Visual Inference and Neural network Optimization)是英特尔开源的推理优化工具套件,核心作用是将训练好的AI模型(支持PyTorch、TensorFlow、ONNX等主流框架)转换并优化为能在英特尔硬件上高效运行的格式。它可以自动识别并调度CPU、集成GPU和NPU(神经网络处理单元)各自最擅长的计算任务,从而在不依赖云端服务的情况下实现接近专用AI加速卡的推理性能。AIPC则是英特尔推出的面向AI本地运算的个人电脑平台标准,其关键特征是内置NPU——这是一种专为低功耗、持续性AI推理设计的独立计算单元,与CPU和GPU协同工作,使AI任务可以在笔记本等终端设备上长时间运行而不过度消耗电量。对开发者而言,OpenVINO+AIPC的组合意味着:模型推理的延迟、成本与隐私风险都留在本地,无需为每一次API调用支付token费用,也无需将用户数据发送至云端。
端云协同:各司其职的 AI 协作范式
应用开发过程中,一个绕不开的问题是:本地和云端到底该怎么分工?
现场发布了英特尔 AI 创新大使计划,彭超老师作为首批大使之一,分享了 AIPC 上端云协同的具体场景。他介绍了一种类似「Coworker」形态的端云协作方式:端侧负责执行,云端负责编排。
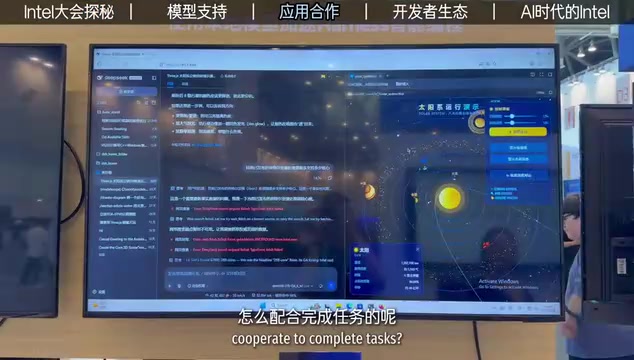
具体来说,云端使用了具备强大「大脑」的 DeepSeek广告 V4.1 Flash,负责把任务拆解得非常详细;而端侧依靠本地算力执行,完全不用考虑 token 消耗,因此可以通过多轮迭代达到更好的代码执行效果,最后再交由云端模型负责验收。
这种「云端规划 + 端侧执行」的范式,正好把大模型的推理能力和本地算力的成本优势结合起来,是 AIPC 时代一种颇具代表性的工程思路。
"端侧"与"云端"的分工本质上是算力位置与成本结构的取舍。云端大模型(如DeepSeek V4.1 Flash)参数规模庞大、推理能力强,但每次调用都产生token计费,且存在网络延迟;端侧模型运行在用户本地设备上,推理成本固定(硬件折旧),适合高频、迭代性的任务。"云端规划+端侧执行"的范式正是利用了这一差异:复杂的任务拆解和最终验收由云端强模型处理(调用次数少,token消耗可控),而需要多轮循环、反复尝试的代码执行过程则完全在本地进行(零边际成本)。这种架构在Agent(智能体)场景中尤其有价值——Agent完成一个任务往往需要数十次乃至上百次中间步骤的推理,若全部在云端完成,token费用会迅速累积;将执行层下沉到端侧,可以在不降低任务完成质量的前提下大幅压缩运行成本。
从动手实践到落地支持:开发者生态的闭环
光有技术还不够,开发者真正关心的是:做出来的应用能不能用起来、卡住了找谁交流、作品做好后去哪里获得反馈。英特尔在现场围绕这些痛点搭建了一套支持体系。
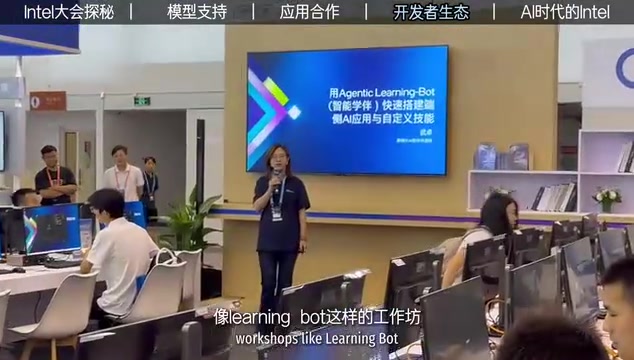
像 LearningBot 这样的工作坊提供了动手实践的机会,开发者可以在讲师指导下尝试搭建端侧 AI 应用和自定义技能。
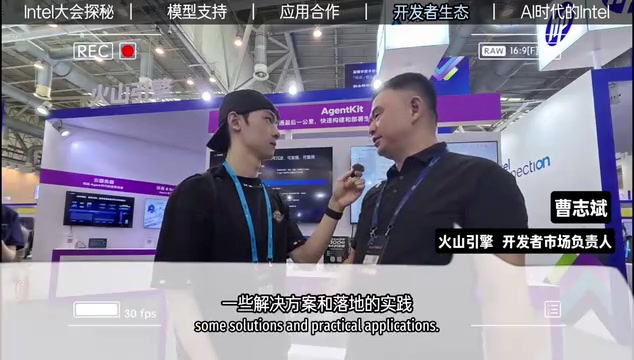
在落地支持层面,大会发布了荣耀英特尔 AI 制造创新赛,以及英特尔与火山引擎 Agent 社区之间的联动。据火山引擎 Agent 社区的曹博士介绍,火山开发者社区官网新增了英特尔内容板块,感兴趣的开发者可以了解火山与英特尔联合解决方案的细节。双方还计划在不同城市举办面向本地开发者的线下聚会,由火山和英特尔的专家共同介绍云与英特尔技术结合的落地实践。
真实需求驱动:开发者作品落地现场
现场也有开发者带着自己的作品前来。英特尔和魔搭联合举办的智能体技能创新大赛总决赛上,选手们把具体需求做成 skill 带到现场演示,并与评委交流。
其中一个项目聚焦采购审计、合同标书等高责任报告的交付前核验,需求源自一家矿产企业客户的真实痛点——面对大量数据和审计采购报告,人工审核压力巨大。开发者从这个很窄的方向切入,做了一个能减轻重复性工作、检查报告与采购中问题的 skill。
这类从真实业务场景出发的应用,恰恰说明了英特尔生态布局的落点:不是堆砌技术概念,而是让 AI 能力解决具体问题。
结语:从芯片标签到解决真实需求
逛完整个 AI 开发者区,英特尔在 AI 时代做的事情也有了更具体的轮廓——它与模型厂商、Agent 伙伴以及开发者一起,正在把 AI 能力真正带到我们的电脑上。
过去,我们或许通过电脑上那块芯片标识认识英特尔;而未来,让我们重新认识它的,可能正是今天这些开发者做出的、解决真实需求的 AI 应用。
相关推荐
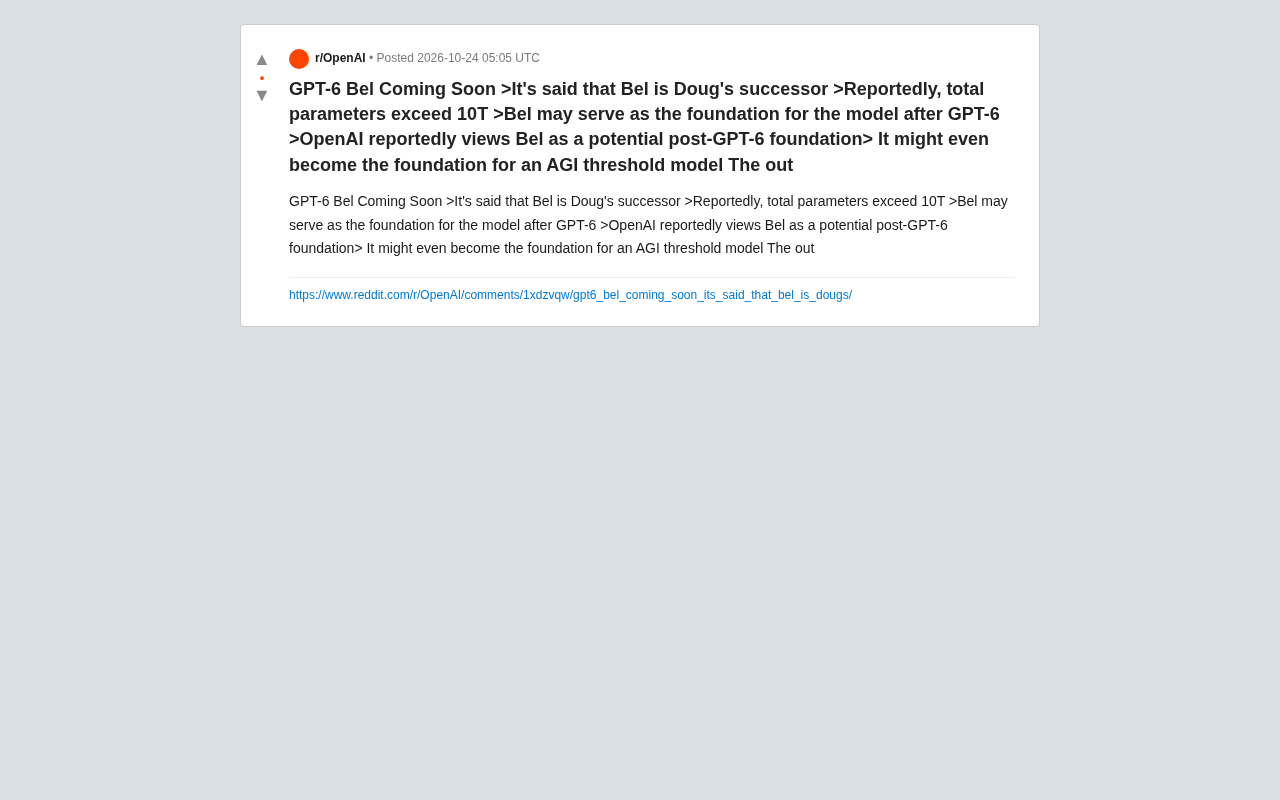
OpenAI新模型Bel曝光:10万亿参数,或成AGI基座
Reddit爆料称OpenAI新模型Bel即将问世,总参数超10万亿,或作为GPT-6之后的基础模型甚至AGI门槛基座。本文拆解爆料关键信息并评估可信度。
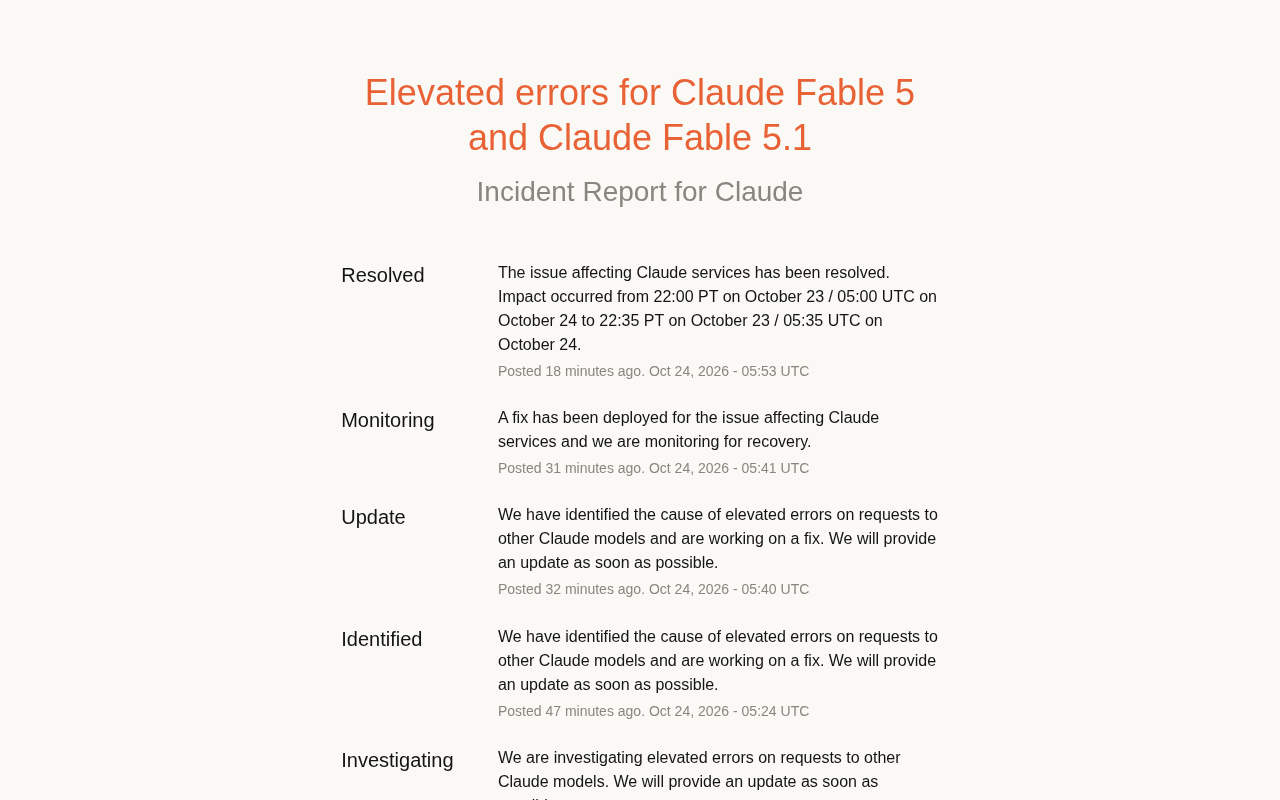
Claude Fable 5/5.1报错事件:30分钟故障复盘
Claude Fable 5与Fable 5.1出现错误率升高的服务故障,官方状态页显示影响约35分钟,从Investigating到Resolved仅用37分钟。本文还原故障时间线,分析对其他Claude模型的波及范围,并给出开发者重试、多模型路由与监控告警的应对建议。
Kimi K3.1开源模型实测:3万亿参数挑战闭源巨头
Kimi K3.1 开源权重模型深度实测:3万亿参数MoE架构、100万token上下文,3D渲染惊艳但空间推理与事实准确性存短板。基准逼近Opus 5.5,每任务成本仅2.11美元,开源前沿的真实水位全解析。