英伟达推出NVKE:Kubernetes原生AI算力管理新引擎

英伟达或推NVKE,将GPU算力管理从芯片层延伸至Kubernetes编排层。
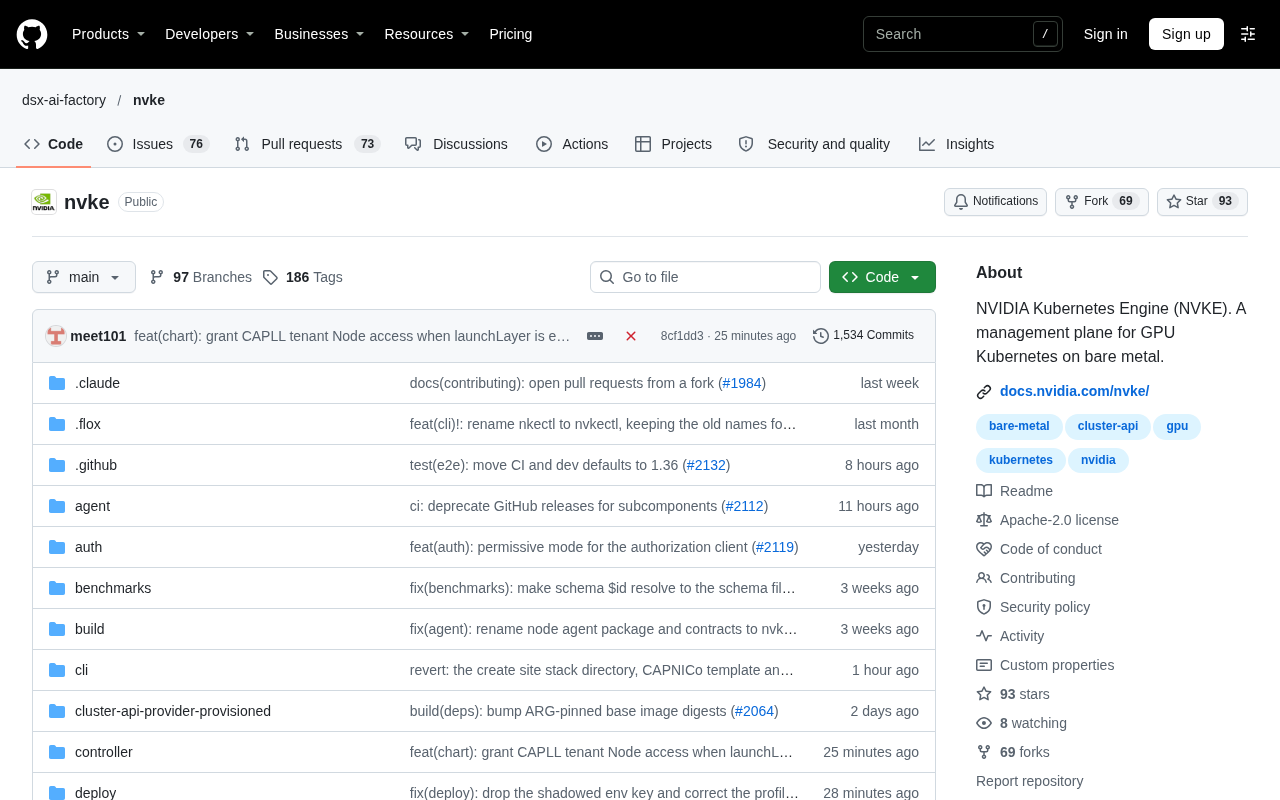
文章基于Hacker News上一则信息极少的Nvidia Kubernetes Engine(NVKE)项目条目,从命名范式推断英伟达可能推出面向GPU基础设施的Kubernetes发行版或托管控制平面。作者分析其动机在于通用调度器难以处理GPU拓扑感知、NVLink互联、MIG分区与多租户隔离等能力,而现有GPU Operator仅解决节点级问题。文章认为NVKE更可能定位为可移植的参考控制平面而非与GKE/EKS直接竞争,AI平台团队可借此卸下驱动维护负担,但需警惕控制平面深度绑定带来的供应商锁定风险。全文强调目前分析均属基于命名的推演,需等待官方文档与代码验证。
英伟达正在将其在AI算力领域的影响力从芯片层向编排层延伸。Hacker News上出现了一个名为 Nvidia Kubernetes Engine(NVKE) 的新项目条目,虽然目前披露的信息非常有限,但这个命名本身已经传递出清晰的信号:英伟达希望用一种Kubernetes原生的方式,来管理其GPU算力集群。
NVKE是什么:从名字读出的产品定位
从命名结构看,NVKE与业界熟知的GKE(Google Kubernetes Engine)、EKS(Amazon Elastic Kubernetes Engine)、AKS(Azure Kubernetes Service)属于同一命名范式。这意味着NVKE大概率不是又一个GPU监控插件,而是一个面向英伟达GPU基础设施的Kubernetes发行版或托管控制平面。
这个定位值得玩味。过去几年,英伟达在软件侧的投入集中在CUDA、cuDNN、TensorRT、Triton推理服务器以及GPU Operator等工具链上,但这些组件更多是"在Kubernetes里运行",而非"管理Kubernetes本身"。NVKE若如其名,则意味着英伟达要把控制面也纳入自己的产品版图。
为什么英伟达要做自己的Kubernetes引擎
AI训练与推理负载对基础设施的要求与通用Web服务差异巨大:GPU是稀缺资源,拓扑感知、NVLink互联、MIG分区、显存调度这些能力,通用Kubernetes调度器并不能开箱即用地处理好。
英伟达此前通过GPU Operator和Device Plugin缓解了部分问题,但多租户隔离、GPU利用率优化、训练任务排队与抢占等能力,仍然需要用户自行拼装调度器与队列系统。一套官方维护的Kubernetes引擎,可以把这些最佳实践固化下来,降低企业落地AI基础设施的门槛。
另一个不容忽视的背景是推理侧的变化。随着大模型推理成为常态负载,企业需要的是能弹性伸缩、按GPU型号分层调度的平台能力,而不是给每台机器手工装驱动。
NVLink与MIG:NVLink是英伟达GPU间的高带宽互联技术,多卡训练时负责GPU之间的数据交换,其拓扑结构(如哪些卡直连、跨NUMA节点距离)直接影响分布式训练效率。MIG(Multi-Instance GPU)则允许将单块A100/H100等GPU物理切分为多个独立实例,每个实例拥有隔离的显存与计算单元。Kubernetes原生调度器只看到整卡资源,无法感知NVLink拓扑亲缘性或MIG实例的细粒度分配,这正是英伟达需要在控制平面层做扩展的底层原因。
GPU Operator与Device Plugin:GPU Operator是英伟达提供的Kubernetes Operator,用于自动化部署驱动、容器运行时、Device Plugin、DCGM监控等组件;Device Plugin则是Kubernetes设备插件框架的实现,负责向kubelet上报GPU资源并完成容器内的设备挂载。二者解决了“GPU能被Pod使用”的问题,但不涉及调度策略、队列管理与多租户配额,属于节点级能力而非控制平面能力。
与现有生态的竞合关系
NVKE不可避免要与云厂商的托管Kubernetes服务形成微妙关系。一方面,云厂商是英伟达GPU最大的采购方,NVKE如果只在自有数据中心有意义,价值会大打折扣;另一方面,云厂商也有强烈动机维护自家控制平面的差异化。
可以预期的路径是,NVKE更可能定位为参考架构与可移植的控制平面,让企业在自有集群、边缘节点和混合云之间保持一致体验,而不是直接与GKE/EKS抢托管生意。这一判断目前只是基于命名的推测,Hacker News的讨论热度(17个点、1条评论)也说明社区仍在观望。
托管控制平面与参考架构:托管控制平面指云厂商负责运维Kubernetes API Server、etcd、调度器等控制面组件,用户只管理工作负载;参考架构则是一套经过验证的部署拓扑与配置清单,用户在自己的基础设施上自行搭建。GKE/EKS/AKS属于前者,而NVKE若走后者路线,则更接近“英伟达认证的Kubernetes发行版”——提供经过GPU场景调优的调度器配置、CRD与Operator组合,但控制面仍由用户或云厂商托管,从而避免与云厂商的直接冲突。
对AI基础设施团队意味着什么
如果NVKE最终落地为一套官方Kubernetes引擎,AI平台团队的工作重心会发生变化:底层驱动、设备插件、拓扑调度这些"脏活"有望交给英伟达维护,团队可以把精力放在模型服务编排、配额治理和成本优化上。
但也需要警惕供应商锁定问题。控制平面一旦深度绑定英伟达的调度扩展与CRD,迁移到其他加速器生态的成本会上升。对多芯片策略的企业来说,评估NVKE时要重点看它是否坚持上游Kubernetes的一致性,以及扩展点是否保持开放。
目前NVKE公开信息极少,上述分析更多是基于命名惯例与英伟达既有产品线的推演。真正的答案,要等官方文档和代码放出来才能揭晓。建议关注该项目的开发者从GPU Operator的演进路线入手,观察英伟达是否在逐步向上接管编排层。
供应商锁定与上游一致性:供应商锁定在此处指控制平面依赖英伟达专有的调度扩展、CRD或准入控制器,导致工作负载定义难以迁移到AMD、Intel等加速器平台。评估时需关注两点:一是NVKE是否通过Kubernetes的Device Plugin、RuntimeClass、ResourceClaim等上游标准API暴露GPU能力,而非私有接口;二是调度扩展是否以Scheduler Framework插件形式实现并可替换。坚持上游一致性意味着多芯片策略的企业可以在不同加速器生态间复用工作负载描述,降低迁移成本。
相关推荐
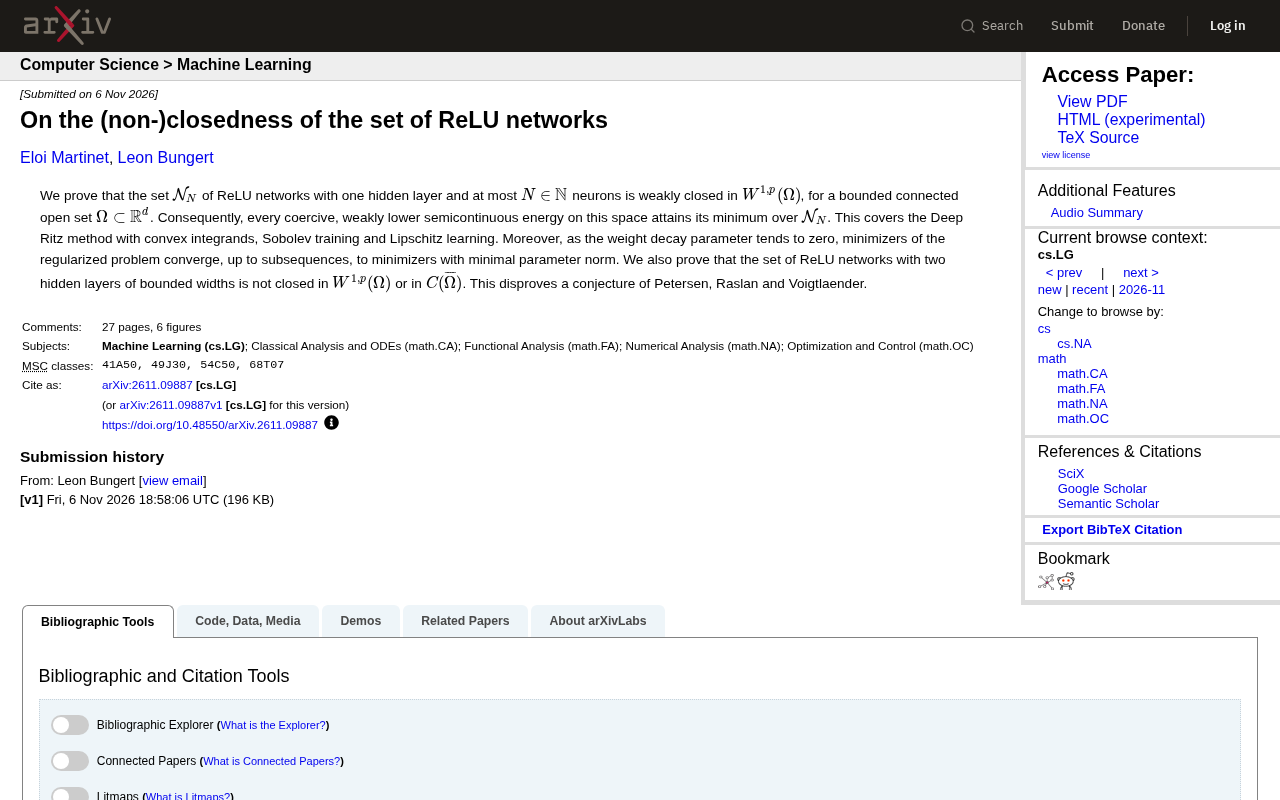
ReLU网络集合的闭性新证:单隐层弱闭,双隐层非闭
新研究证明单隐层ReLU网络集合在W^{1,p}中弱闭,保证Deep Ritz等方法解的存在性;而双隐层网络集合非闭,推翻已有猜想。
FlowMoP:随机多人运动预测新框架
FlowMoP提出条件流匹配框架,联合生成多个智能体的多样化未来运动,通过B样条重参数化与双流Transformer实现交互感知预测,在CMU-Mocap和3DPW上超越确定性基线,并建立WorldPose首个运动预测基线。
分级卷积网络:无需尺度参数的尺度不变性与抗模糊鲁棒性
分级卷积网络利用图像高斯射流的分级向量空间结构,通过回缩操作实现无需尺度参数的尺度不变性,并在未知高斯模糊下显著提升鲁棒性。MNIST实验显示,两像素模糊下准确率保持88.4%,优于尺度归一化导数的66.2%。