用Fisher信息距离实现神经网络最优剪枝:一种几何视角
用微分几何统一神经网络剪枝:测地线距离最短即最优剪枝准则
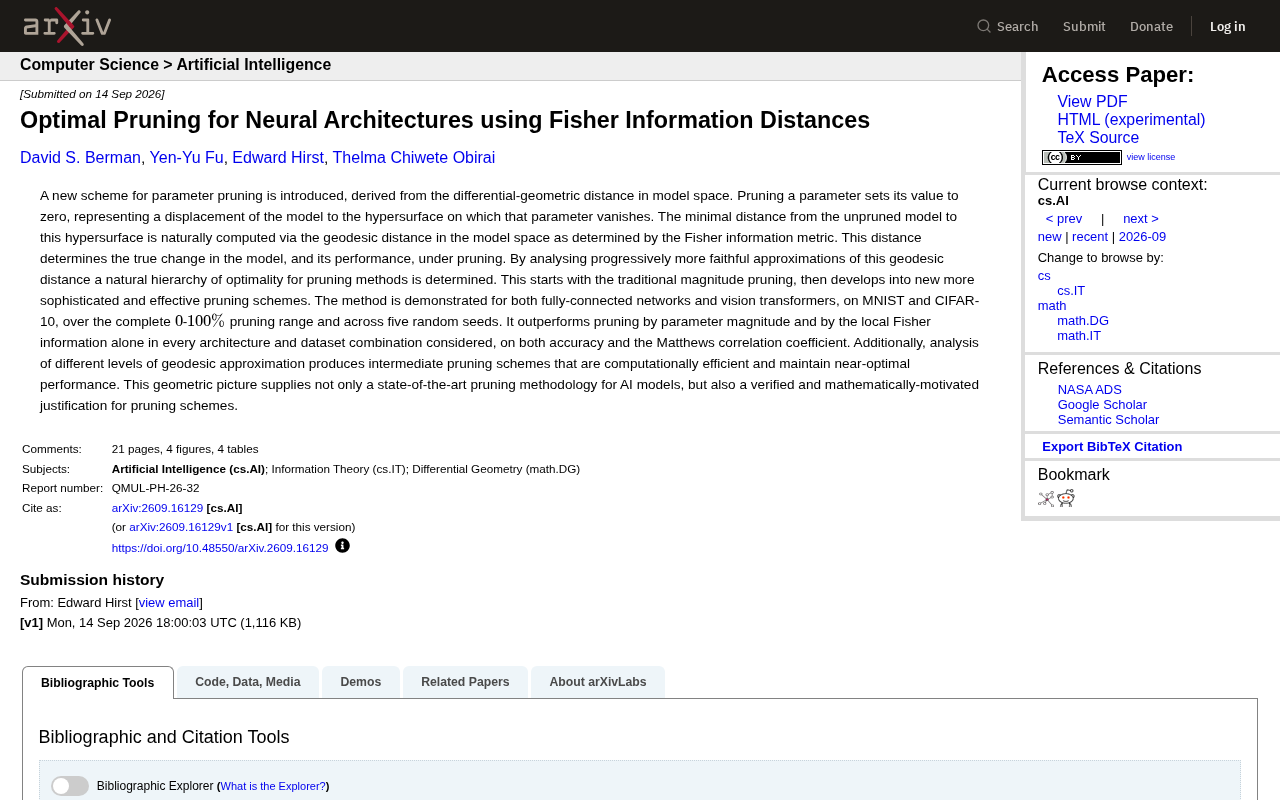
这篇arXiv论文从微分几何视角重新定义了神经网络剪枝:将参数置零等价于模型在Fisher信息度量空间中向超曲面的位移,最优剪枝对应最短测地线距离。通过对该距离逐级近似,论文构建了一个统一的最优性层级——最粗糙的近似还原为经典幅值剪枝,中间层引入局部Fisher信息,最精细层逼近真实测地线距离。实验在MNIST与CIFAR-10上的全连接网络和视觉Transformer中进行,覆盖0%至100%完整剪枝区间,在准确率与MCC两项指标上全面超越幅值剪枝和局部Fisher基线。该框架不仅提供了实用的先进剪枝方法,更从理论层面解释了各类剪枝准则背后的统一数学原理,为模型压缩领域带来了"知其所以然"的理论清晰性。
从几何视角重新审视神经网络剪枝
模型剪枝(Pruning)是压缩神经网络、降低推理成本的关键技术之一,其核心思路是移除对模型性能影响最小的参数。长期以来,业界最常用的方法是幅值剪枝(Magnitude Pruning)——直接把绝对值最小的权重置零。这种方法简单有效,但缺乏严格的理论支撑:为什么权重小就意味着可以安全删除?
一篇新发布的arXiv论文(arXiv:2609.16129)给出了一个更本质的回答。研究者从微分几何的角度重新定义了剪枝问题:将参数置零,本质上是把模型从原点移动到"该参数消失"的那个超曲面上。而衡量这一移动带来的真实变化,最自然的度量方式,是模型空间中由Fisher信息度量(Fisher Information Metric)所决定的测地线距离(Geodesic Distance)。
Fisher信息度量(Fisher Information Metric)是统计流形上的一种黎曼度量,由统计学家Ronald Fisher提出。直观而言,它衡量的是:当模型参数发生微小变化时,模型所代表的概率分布改变了多少。对于神经网络而言,Fisher信息矩阵(FIM)的第 $(i,j)$ 项描述了参数 $\theta_i$ 与 $\theta_j$ 的联合敏感度。Fisher度量的核心优势在于它是坐标无关的——不同于欧氏距离那样依赖参数的具体数值大小,Fisher距离反映的是模型行为(即输出分布)层面的真实差异。这正是它比简单幅值比较更适合作为剪枝准则的根本原因:一个绝对值很小的权重,如果所在位置对输出分布极为敏感,Fisher度量就会给出较大的"移动代价",从而阻止该参数被错误剪除。
核心思想:剪枝就是模型空间中的位移
论文的洞见在于把"剪掉一个参数"这一操作,转化为一个可精确度量的几何问题。当你把某个参数设为零,模型就从当前位置"位移"到了那个参数取值为零的超平面上。这段位移的最小长度——即测地线距离——直接刻画了剪枝后模型及其性能的真实改变量。
换句话说,理想的剪枝策略应当优先删除那些让模型在Fisher度量下"移动最少"的参数。这为剪枝提供了一个明确的最优性准则,而不再依赖直觉。
一个由近似程度决定的最优性层级
真正巧妙的地方在于,精确计算测地线距离在计算上代价高昂。论文通过对这一测地线距离逐级采用更精细的近似,构建出一个剪枝方法的最优性层级(hierarchy of optimality):
- 最粗糙的近似:恰好还原为传统的幅值剪枝,这从理论上解释了幅值剪枝为何长期有效——它是几何最优解的一阶粗略近似。
- 中间层级的近似:引入局部Fisher信息,得到计算高效、性能接近最优的中间方案。
- 最忠实的近似:逼近真实测地线距离,给出理论上最优的剪枝效果。
这个层级结构的价值不仅在于提供了新方法,更在于它把从简单到复杂的各类剪枝方案统一在同一个数学框架之下,让工程师可以根据算力预算在"精度"与"效率"之间做出有依据的权衡。
**测地线距离(Geodesic Distance)**是黎曼流形上两点之间的最短曲线长度,是欧氏空间中"直线距离"概念在弯曲空间中的推广。在参数空间这一统计流形上,两组参数之间的测地线距离不是简单的欧氏范数,而是沿着曲率由Fisher信息矩阵决定的弯曲空间中最短路径的长度。精确计算测地线距离通常需要求解微分方程,计算代价高昂,这也正是论文引入逐级近似体系的动机所在——不同精度的近似对应不同的计算开销,从而在理论最优与工程可行之间架起一座桥梁。
实验验证:在多种架构上全面超越基线
论文在两类具有代表性的架构上验证了该方法:全连接网络和视觉Transformer(Vision Transformer),数据集选用MNIST与CIFAR-10。实验覆盖了从0%到100%的完整剪枝比例区间,并跨越五个随机种子以确保结果稳健。
结果显示,在所有考察的"架构×数据集"组合中,该几何方法在准确率和**马修斯相关系数(Matthews Correlation Coefficient, MCC)**两项指标上,都全面优于以下两种基线:
- 基于参数幅值的剪枝;
- 仅基于局部Fisher信息的剪枝。
值得关注的是完整剪枝区间的测试。许多剪枝方法只在低剪枝率下表现良好,一旦大幅压缩就急剧退化。而覆盖0%-100%全区间的实验,能更真实地反映方法在激进压缩场景下的可靠性。
计算效率与性能的平衡点
除了追求极致精度,论文还强调了中间近似方案的实用价值。这些方案通过牺牲一定的几何精确度,换取显著更低的计算开销,同时保持接近最优的性能表现。对于需要在资源受限环境中部署模型的团队而言,这类"性价比"方案往往比理论最优解更具落地意义。
**马修斯相关系数(Matthews Correlation Coefficient, MCC)**是一种综合考量真阳性、真阴性、假阳性、假阴性的分类评估指标,取值范围为 $[-1, 1]$,其中 $+1$ 表示完美预测,$0$ 表示与随机猜测相当,$-1$ 表示完全反向预测。相比准确率,MCC对类别不平衡问题更为鲁棒——在剪枝实验中,当模型被大幅压缩后某些类别的预测能力可能严重下降,此时准确率可能因多数类的掩盖效应而虚高,MCC则能更真实地反映模型在各类别上的综合判别能力。同时使用这两项指标,有助于更全面地评估高剪枝率下模型性能的真实退化程度。
意义:为剪枝提供数学上的正当性
这项工作的贡献可以从两个层面理解。
在方法层面,它提出了一套在实验中达到当前先进水平的剪枝方法,且不局限于单一架构,在传统网络和现代Transformer上均有效。
在理论层面,它给出了一个经过验证、有数学动机的剪枝正当性解释。过去的剪枝很大程度上是经验驱动的"炼丹",而这套几何框架说明了不同剪枝准则背后的统一原理——它们不过是同一测地线距离在不同近似精度下的产物。这种"知其所以然"的理解,对于未来设计更好的压缩算法具有指导意义。
小结
这篇论文用微分几何的语言重新表述了神经网络剪枝:剪枝即模型在Fisher信息度量空间中的位移,最优剪枝对应最短测地线距离。通过逐级近似,它把从幅值剪枝到复杂几何方案的整个谱系纳入统一框架,并在MNIST、CIFAR-10上的全连接网络与视觉Transformer实验中,全面超越了幅值剪枝与局部Fisher方法。对于关注模型压缩与高效推理的研究者和工程师,这一几何视角既提供了实用工具,也带来了理论上的清晰认识。
相关推荐
Claude挑战循环真相:Wayfinder技能修复AI一次构建应用
解析Claude挑战循环(Challenge Loop)的运作原理与两大致命缺陷,以及如何用Matt Pocock的Wayfinder技能生成可验证规格文件,让AI代理一次性构建真实项目而非仅限游戏演示。
Claude Code 令牌耗尽?7个隐藏消耗点审计与修复指南
Claude Code 总是提前撞上令牌限制?本文拆解 Token 复合增长的底层机制,梳理从 /clear 到定时任务的七个隐藏消耗点,并澄清短提示、压缩、截图等无效省钱建议,附实用自查命令与审计方法。
MiniMax H3实测:3步采样打造整首歌口型同步MV
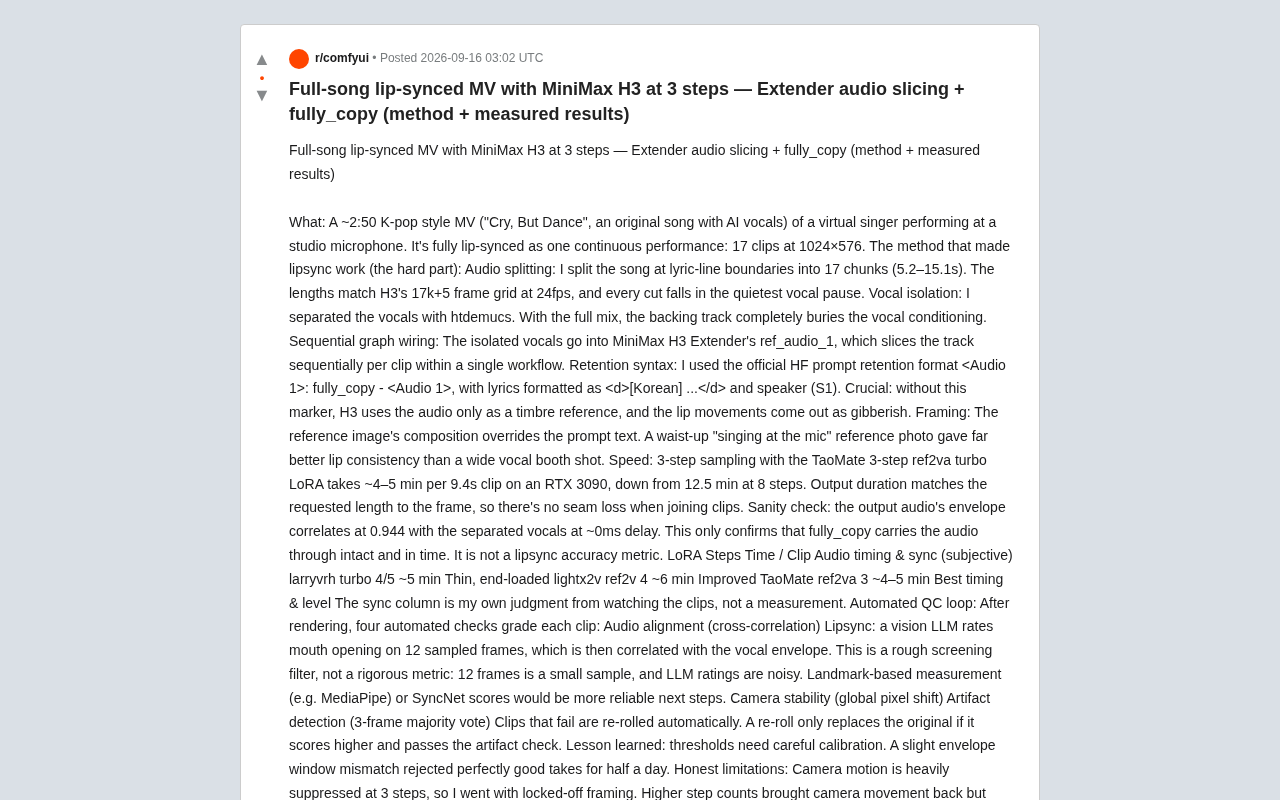
一位创作者用MiniMax H3 Extender制作整首歌口型同步MV的完整实测:音频切片、htdemucs人声隔离、fully_copy保留语法、3步turbo LoRA提速,附三款LoRA对比与自动化质检方案。