用MCP连接Web Fetch服务器:让AI无需浏览器抓取网页

通过MCP连接Web Fetch服务器,将网页HTML转为Markdown并用Pydantic校验,为智能体提供轻量可靠的网页抓取能力。
本文介绍了在Agentic AI系统中,如何利用模型上下文协议(MCP)以标准化方式抓取网页内容,而无需依赖完整浏览器。整个流程包含五个关键环节:通过stdio启动Fetch服务器、初始化会话并动态发现可用工具、携带URL白名单与长度限制调用Fetch工具、将返回的多段文本块拼接后进行错误拦截,以及用Pydantic将内容校验为结构化数据对象。其中将`raw`参数设为false可自动将HTML转换为对语言模型更友好的Markdown,是减少噪音的实用技巧。最终调用方获得包含状态、内容或错误信息、字符计数的可预测结果,极大简化了下游编排逻辑。
为什么需要一个标准化的网页抓取通道
网页是为人类设计的,而应用程序需要的是可靠、结构化的数据。当我们想让大语言模型获取网页内容时,一个核心问题浮现出来:能否在不启动完整浏览器的情况下,让模型稳定地读取网页?模型上下文协议(Model Context Protocol,简称 MCP)正是为解决这类连接问题而生的标准。
这节课(Agentic AI 课程第 27 阶段第 2 课)聚焦于一个具体实践:通过 MCP 连接一个 Web Fetch 服务器,让智能体以标准化方式抓取网页,并把杂乱的 HTML 转换成模型更易理解的 Markdown 文本。相比直接依赖浏览器自动化,这种方式更轻量、更可控,也更容易在生产环境中保持稳定。
模型上下文协议(MCP)是由 Anthropic 于 2024 年底提出的开放标准,旨在为大语言模型与外部工具、数据源之间的交互定义统一的接口规范。其核心思想类似于 USB 接口之于硬件外设:无论底层实现如何不同,只要遵循同一套协议,模型就能以一致的方式发现和调用各类能力——无论是文件系统、数据库,还是本文涉及的网页抓取服务。MCP 采用 JSON-RPC 2.0 作为消息格式,支持 stdio(标准输入输出)和 HTTP+SSE 两种传输层,前者适合本地进程间通信,后者适合跨网络部署。这种分层设计使得协议本身与具体的运行环境解耦,开发者可以在本地开发时使用 stdio,在生产环境中切换到 HTTP 而无需修改业务逻辑。
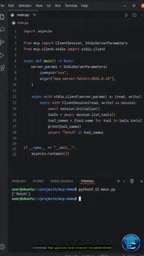
启动 Fetch 服务器并初始化会话
整个流程从通过 Studio 启动 Fetch 服务开始,它使用标准输入输出(stdio)作为通信通道。这是 MCP 中最常见的本地传输方式之一:客户端与服务器通过标准 I/O 管道交换 JSON-RPC 消息,无需额外的网络端口配置。
会话建立后的关键一步,是先初始化会话,再检视服务器所声明(advertised)的工具列表,然后才去调用具体工具。这个顺序很重要——它体现了 MCP 的自描述特性:客户端不需要硬编码知道服务器能做什么,而是在运行时动态发现可用能力。这种设计让智能体具备了更强的适应性。
调用 Fetch 工具:参数设计体现工程细节
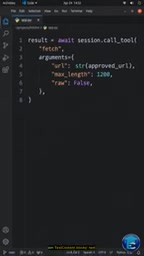
真正发起抓取时,调用 Fetch 工具需要传入几个关键参数:
- 已批准的 URL(approved URL):只对经过许可的地址发起请求,这是一道基础的安全边界。
- 长度限制(length limit):控制返回内容的字符数量,避免超长网页撑爆模型的上下文窗口。
raw设为 false:这是一个很实用的选项。关闭 raw 模式后,服务器会把原始 HTML 转换为 Markdown,剥离标签噪音,保留结构化的文本内容——对于后续喂给语言模型处理,Markdown 远比裸 HTML 友好。
这些参数看似简单,却覆盖了网页抓取中最常见的三类问题:安全、容量和可读性。
处理返回结果:拼接、校验与错误拦截
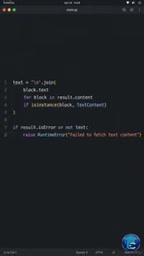
服务器返回的内容通常由多个文本内容块(text content blocks)组成,需要将它们拼接成完整文本。
但拼接只是第一步,真正体现工程严谨性的是对异常情况的拦截:如果工具返回了错误,或者输出为空,就应当直接拒绝,而不是把残缺数据传递下去。这种"快速失败"的处理方式能有效防止下游逻辑在无效数据上继续运行。
用 Pydantic 做结构化校验
拿到文本后,使用 Pydantic 将其校验并映射为一个预先定义的数据记录(record)。Pydantic 的作用是把"一段可能格式混乱的文本"转化为"类型明确、字段清晰的结构化对象"。
经过这一层校验,调用方最终得到的是一个可预测的结果:包含明确的状态(status)、内容(content)或错误信息(error),以及字符计数(character count)。无论抓取成功与否,调用方都能拿到结构一致的返回,这极大简化了错误处理和后续编排逻辑。
Pydantic 是 Python 生态中广泛使用的数据校验库,其核心机制是通过类型注解(type hints)声明数据模型,并在运行时自动完成类型转换与合法性检查。与手动编写 if/else 校验逻辑相比,Pydantic 的优势在于:一旦数据不符合预期模式,它会立即抛出带有详细字段路径的异常,而非静默地传递错误数据。在智能体系统中,语言模型的输出天然带有不确定性——同一个问题在不同运行时可能产生格式略有差异的文本。将模型输出强制经过 Pydantic 模型的过滤,相当于在模型的"自由输出"与下游确定性逻辑之间加了一道契约层,是目前业界处理 LLM 结构化输出的主流实践之一。FastAPI 框架的广泛采用也进一步推动了 Pydantic 在生产级 Python 服务中的普及。
这套流程的工程价值
把这节课的要点串起来看,它其实演示了一个构建可靠智能体工具的通用范式:
- 标准化连接——用 MCP 和 stdio 替代脆弱的自定义集成;
- 运行时发现——先检视工具再调用,保持灵活性;
- 参数化约束——通过 URL 白名单、长度限制保证安全与可控;
- 格式转换——HTML 转 Markdown,让数据对模型友好;
- 严格校验——用 Pydantic 保证输出结构可预测。
对于正在搭建 Agentic AI 系统的开发者来说,这种"轻量抓取 + 严格校验"的模式比直接调用浏览器更适合规模化部署。它把网页这种"面向人类"的非结构化资源,转化成了"面向应用"的可靠数据流,而 MCP 则充当了两者之间那座标准化的桥梁。
相关推荐

Claude Sonnet 6疑泄露,Anthropic内部模型加速惊人
Anthropic疑似泄露Sonnet 6,Meter报告称其AI研发加速1.9倍;OpenAI发布GPT-6 Cyber,GPT-6.2 Astra或将至;Google Gemini Omni 1.2 Flash登顶视频生成榜;Meta stealth模型与实时头像亮相;市场波动下Google仍投170亿美元建数据中心。

科幻小说对AI的预测有多准?
科幻小说对AI的预测有多准?本文结合Hacker News讨论,分析科幻作品在AI发展中的远见与盲区,探讨其真正价值在于启发思考而非精准预测。

SwarmEvolve:潜空间智能体集群加速进化搜索
SwarmEvolve框架让数百个低成本智能体在潜空间中集群推理,通过KV缓存共享信息,在数学发现和科学计算问题上实现快速进化搜索,中位数仅3-8分钟达到其他框架60分钟的最佳分数。