深度
AI 领域长篇解读、行业观察、技术分析 —— 慢下来读一篇。

离线策略RL+在线推理调优:我在CoRL 2026 RoboEval挑战赛的解决方案
本文介绍了CoRL 2026 RoboEval挑战赛的解决方案,结合离线策略强化学习与在线推理调优,在八项双臂任务中达到0.990 RDS的评分,接近人类演示水平。

一次性分层联邦聚类:破解分布式非IID生物医学数据难题
介绍一种面向分布式非IID生物医学数据的一次性分层联邦聚类框架:客户端单向传输原型,服务端用多粒度竞争学习融合聚类小簇,在聚类质量、隐私保护与计算效率之间取得平衡。

零知识证明+共识聚合:打造鲁棒隐私的Swarm Learning
本文介绍一种鲁棒且隐私保护的Swarm Learning框架,通过零知识验证者准入和共识聚合机制,确保数据质量并抵御梯度缩放攻击。实验显示在CIFAR-100上保持94%准确率,远超FedAvg的2.1%。

MicroSim:对比图神经网络实现二进制代码相似性检测
MicroSim 利用 IDA Pro 微码构建图,通过对比孪生图神经网络实现二进制代码相似性检测,在 TREX 基准上 ROC-AUC 达 0.9972,优于 Gemini、SAFE 等模型。

CallCleaner:轻量级生物声学降噪新突破
CallCleaner 是一种轻量级生物声学降噪器,仅1900万参数,CPU上90倍实时运行,无需检测器,噪声去除比Biodenoising少11 dB,开源代码和权重。

容量感知决策策略如何破解出院预测的恶性循环
医院出院预测算法面临删失偏差导致的恶性循环。一项研究提出容量感知决策策略,通过运营逻辑自然分散住院时长观测点,将学习误差降低24%-25%,再入院成本差距缩小38%-63%,同时改善预测精度与公平性。

无最优臂反馈的遗憾分析:奖励依赖延迟下的 Bandit 新进展
本文解读随机Bandit中奖励依赖延迟且无最优臂反馈的新研究,介绍Balanced Historical Optimism算法、遗憾下界及实验分析,探讨延迟与反馈缺失下的学习策略。
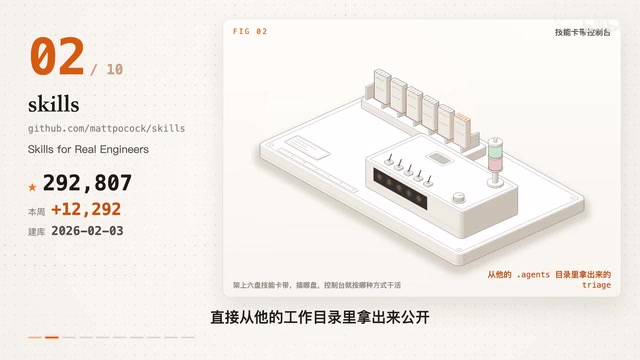
GitHub周涨星最猛的10个AI开源项目盘点
本周GitHub涨星最猛的10个AI开源项目盘点:REA逆向工程7天涨21万星,AirLLM让4G显存跑28000亿参数模型,Text to CAD一句话生成可加工零件,还有Claude MEM、OpenMontage等实用工具。
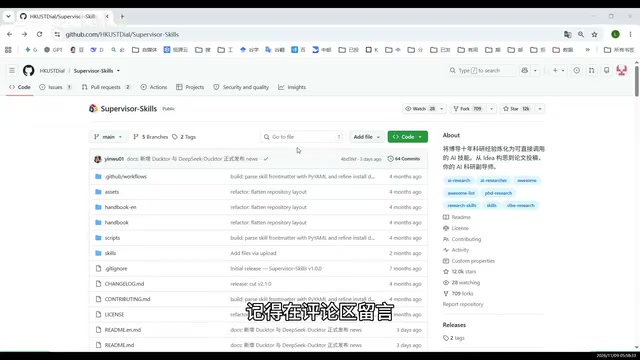
港大开源Supervisor-Skills:把十年博导经验装进AI
港大骆老师团队开源的Supervisor-Skills项目在GitHub获万星关注,将十年博导带学生的隐性科研经验提炼为理论指南加12个独立skill,覆盖idea评估、文献调研、论文写作、投稿审查全流程,支持AI智能体一句话自动安装配置。

编码器懂孟加拉语复合动词,大模型却只会字面翻译
BengaliCV-Probe基准测试26个模型发现:编码器能内部区分孟加拉语复合动词的两种含义,准确率高达93%,但大语言模型很少调用该知识,翻译系统字面化率15%-55%,小模型在正确搭配上反超Qwen2.5-7B。

DeepFinance基准:AI能否胜任百亿级私募尽调?
DeepFinance基准用21个PE和IB端到端任务评测AI,人类平均耗时27.1小时。最佳配置GPT-6 Astra仅满足57.6%评分标准,模型常从错误输入算出正确答案,暴露金融尽调中判断力的短板。

删除不到0.05%权重,竟媲美全量微调?
研究发现,将大模型不到0.05%的权重置零,即可在强化学习、监督微调和蒸馏中媲美全量微调。Deletion Tuning 方法存储更小、遗忘更少,为后训练提供新思路。

SCorPion:用GraphRAG打造可控制的人格化对话伙伴
SCorPion是一个基于GraphRAG的战略性、可控且人格化的对话伙伴,从多样语料提取聊天策略,实现动态风格切换与显式因素控制,为开放域对话提供新思路。

KeyASRBench:ASR关键词保留率的新衡量标尺
KeyASRBench提出基于整短语标注的关键词错误率KER,在中英双语10小时、1501条片段上评测ASR关键词保留能力,揭示低WER系统KER高达33.81%的结构性差距。

MultiTurnRoute:多轮对话LLM路由新平台
MultiTurnRoute是一个用于构建和评估多轮LLM路由器的平台,其Chain-of-Route算法利用近期与循环对话历史预测回复质量,并结合可复用前缀估算成本。在WildChat和LMSYS-Chat-1M基准上,CoR相对最强基线最多降低20.3%归一化成本,同时保持或提升峰值质量。

视觉-代码诊断:测试时精炼让图表代码生成更准
最新研究提出Visual-Code Diagnostics框架,首次将测试时精炼用于图表到代码生成。通过错误分类与轻量判别器定位问题,利用视觉反馈迭代修复代码,在多种生成器上一致提升生成质量,显著优于测试时缩放基线。
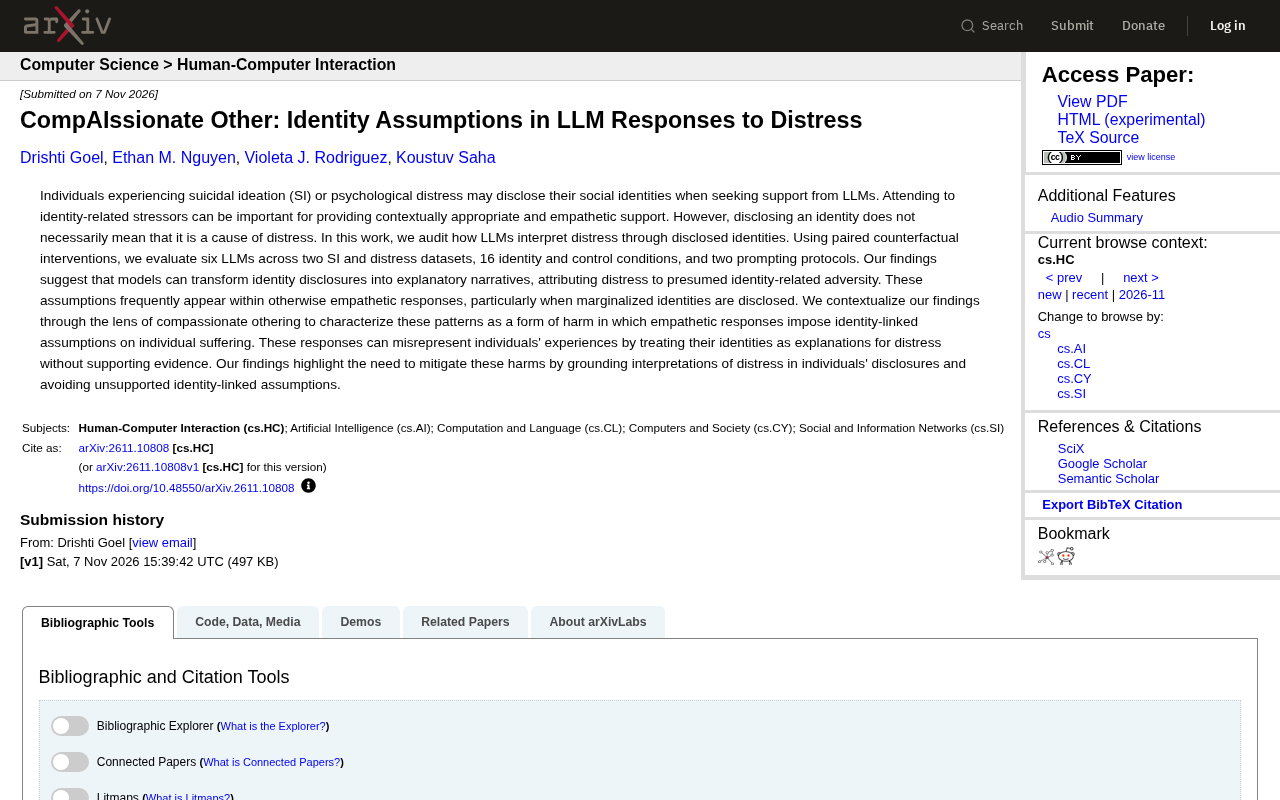
LLM的"共情偏见":当身份披露被误读为痛苦根源
新研究审计六个LLM如何解读痛苦中的身份披露,发现模型常把身份自动转化为痛苦成因,形成"共情式他者化",边缘化身份更易被过度解释。

GPU加速全局求解器GEAR:用线性界传播破解非线性规划难题
GEAR是一种GPU加速的全局非线性规划求解器,借鉴神经网络验证中的线性界传播技术,在GAMS和MINLPLib基准上超越Gurobi、BARON和SCIP等六种求解器,成功求解421/505个问题,其中16个问题无其他求解器能解。

EmbodiedIntentBench:用任务意图衡量机器人运行时自适应能力
EmbodiedIntentBench 是面向移动机器人任务意图的运行时自适应基准,用结构化契约评测覆盖、时效、上报与资源约束下的策略表现,揭示高召回配置反而任务完成率低、忽略观测损失会颠倒策略排序等关键发现。

分组条件共形风险控制:精确保证、局限与重叠扩展
本文解读分组条件共形风险控制(Group-Conditional CRC)的最新研究:针对不相交分组给出精确有限样本保证与双侧风险界限,揭示局部支撑和校准秩粒度等根本局限;针对重叠分组提出分组限制校准联合部署与直接校准两种有效方法,分析调和间隙与尺寸优势,并通过糖尿病视网膜病变数据展示实际权衡。