#前沿研究
共 9147 篇相关文章
工业数据如何转化为决策力:资产追踪与AIoT落地指南
从资产可见性到工业AIoT落地,解析RFID、BLE、RTLS、IoT传感器等资产追踪技术的选型取舍,并给出六步实施方法与衡量指标,帮助工业企业把追踪数据转化为更可靠的运营决策。

腾讯云关联AI智能体探测阿里高德:2600次自主侦察敲响API安全警钟
研究人员追踪到超2600次源自腾讯云关联基础设施的AI智能体探测行为,目标为阿里巴巴高德服务,且均无授权。事件暴露了自主智能体时代API安全边界在首次接触时刻的鉴权盲区。

Qwen-Audio-Jev:统一音频决策接口,推理提速20倍
Qwen-Audio-Jev 通过在 Qwen-Audio-3.1-ASR-Flash-Next 上增加决策头,用 CHOICE/NOUL/SCORE 三个原语统一音频决策任务,推理提速约 20 倍,在 MMAU-mini、VoxCeleb1-O、NISQA 等基准上给出完整评估结果。
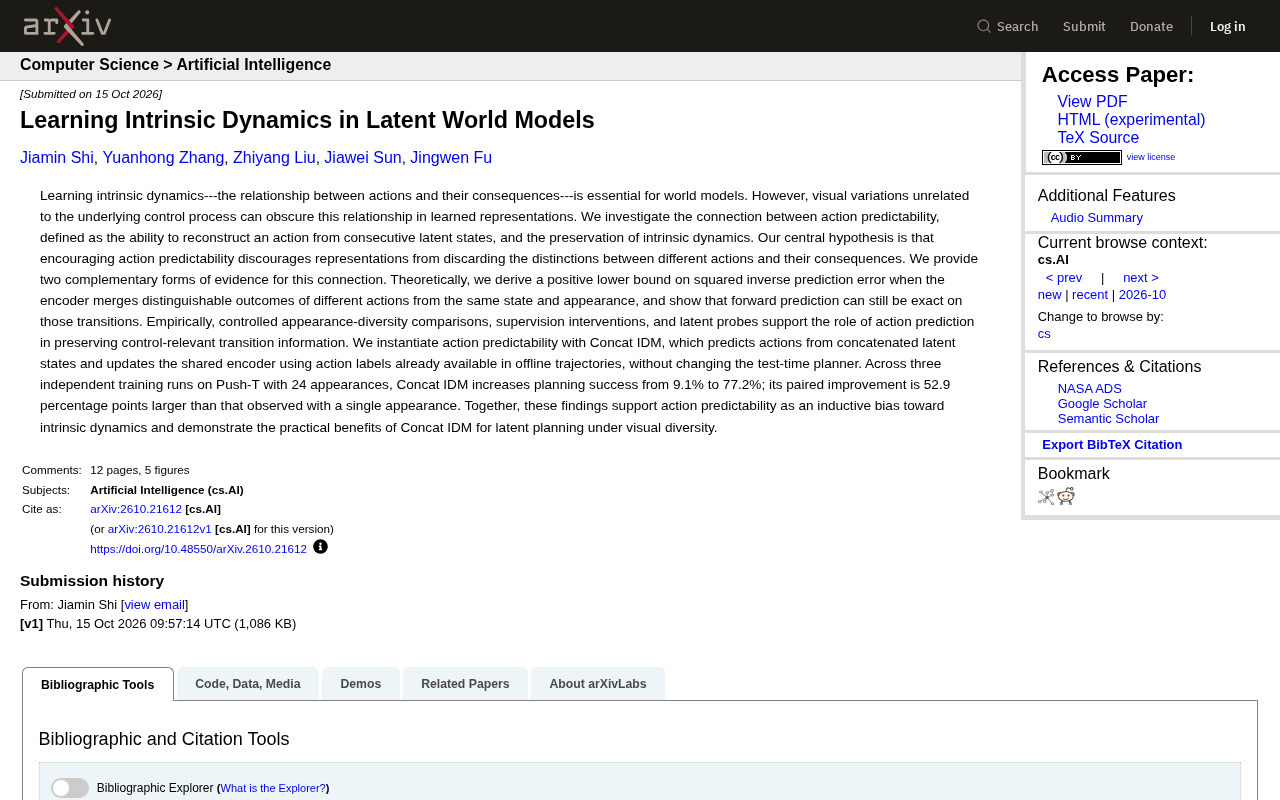
潜在世界模型如何学习内在动力学?新研究揭示动作可预测性的关键作用
研究揭示动作可预测性如何帮助潜在世界模型学习内在动力学。通过理论推导和实验验证,Concat IDM方法在视觉多样性场景下将规划成功率从9.1%提升至77.2%,为机器人学习和具身智能提供新思路。

LLM智能体探究能力评估:假设、推理与探索
一项新研究构建了LLM智能体探究能力评估框架,通过改造Countdown任务考察假设生成、推理与探索能力。实验显示七个LLM自主探究成功率偏低,但教育脚手架式引导能显著提升表现,揭示了战略探索与假设修正是当前核心短板。

LLM解码iOS定位数据:不可靠的分析师,却是好用的工具制造商
一项研究用Claude和GPT逆向iPhone定位服务的Protobuf schema,发现LLM直接分析错误率高且难以察觉,但让AI编写可验证的Extractor工具则能可靠恢复schema,并成功解码越狱iPhone 8的定位流量。

LOADBench:面向模拟IC设计的开源数据集与基准
LOADBench 发布大规模开源模拟IC数据集,涵盖百余种运放拓扑与六项标准化基准任务,旨在解决ML for EDA领域数据封闭与评测不可比的问题。

AVALON:无需建图零样本室内导航新框架
AVALON 提出零样本室内导航框架,利用人类播种的拓扑记忆让机器人在未建图建筑中执行任务。Unitree Go2 实测比 DimOS-Go2 减少 40.9% 执行时间,5/5 成功率。

LoopAhead:让循环语言模型解码提速7.82倍
LoopAhead 提出面向循环Transformer的推测解码框架,通过轻量前瞻草稿器预测多个未来token、深层反馈筛选草稿分支、全深度模型做最终决策,在保持输出分布不变的前提下实现最高7.82倍解码加速。

Jev 成为 Vercel 史上采纳速度最快的 AI 模型
Vercel AI Gateway 数据显示,Jev 是该平台史上采纳速度最快的 AI 模型。本文解读这一数据的意义、对开发者和模型生态的影响,以及需要审慎看待的地方。
骗子遇见演员:Elizabeth Holmes与Nathan Fielder的荒诞碰撞
Nathan Fielder纪录片《You Can See Everything》将Theranos创始人Elizabeth Holmes置于表演真实的框架中,探讨媒体时代诚信、身份与真实性的本质。本文分析两位'造假者'的镜像关系及其文化启示。

Tressfecta:用科技减轻发型师编发负担
Tressfecta 致力于用技术减轻发型师编发时的身体负担,团队将在 TechCrunch Disrupt 展示其解决方案。本文分析编发行业的痛点与这一创新的潜在影响。
Elorian发布首款AI模型Glimpse:用图像推理,而非推理图像
Elorian发布首款AI模型Glimpse,采用视觉原生推理架构,据其评估在科学图表推理和短视频描述任务上超越GPT-6 Astra,探索"用图像推理而非关于图像推理"的新路径。

AI编程代理91%能跑通,仅25%安全可上线
LSCBench基准测试用150个真实漏洞检验六大前沿编程代理:91%能通过功能测试,但仅25%同时安全可上线。Kimi-K3功能通过率最高却最不安全,SSRF和信息暴露类漏洞几乎无人能防。

Grok Bot技能工程指南:类型化工具Schema与MCP架构
深入解析Grok Bot Skills的类型化工具Schema设计、两阶段dry-run保护与MCP协议集成,附500次压力测试数据和生产级Python实现蓝图,帮助企业构建确定性的自主AI智能体执行引擎。
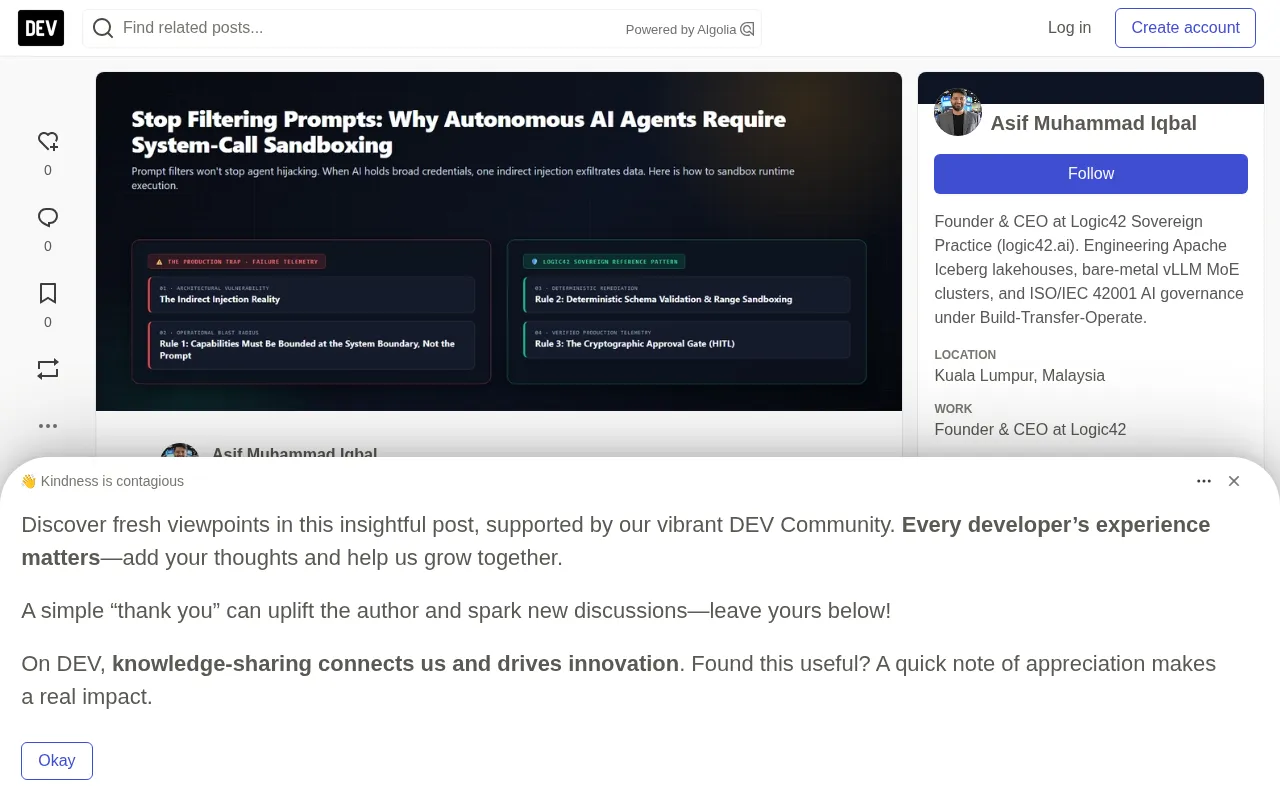
别再过滤提示词:自主AI智能体需要系统调用沙箱
Logic42创始人Asif Muhammad Iqbal指出,自主AI智能体的安全不能依赖提示词过滤,必须在OS内核层实施系统调用沙箱,配合最小权限、确定性Schema校验和密码学审批门,才能将间接提示词注入的影响半径降到可控范围。

云上T4跑不满规格:Gemma 4解码因过热掉速7%
实测 Google Cloud 单卡 Tesla T4 在 Gemma 4 E2B 推理下的热漂移:冷态45°C解码115.3 tokens/s,热态77°C降至106.8,持续掉速7.4%,热节流从未触发,功耗墙与漏电流才是主因。

推理模型何时值得付费?三条判断标准帮你决策
推理模型何时值得付费?本文基于Dan Klein在Chain of Thought播客中的观点,提炼出三条判断标准:检查器是否存在、延迟预算是否允许、思考token成本是否低于答错成本,并给出路由代码草图和评分卡实践方案。