#前沿研究
共 9147 篇相关文章
填补二进制盲区:领域知识注入提升LLM对npm恶意包的识别能力
针对LLM在npm恶意包检测中的二进制盲区,该研究提出领域知识注入方法,通过结构化安全知识引导模型识别原生扩展与WASM等二进制载荷,为供应链安全自动化研判提供新范式。

肯德尔广场年会:在创新浪潮中重构社区纽带
肯德尔广场协会第18届年会聚焦新技术如何推动社会共享繁荣,探讨创新集群中的社区建设挑战与路径,为全球创新中心提供参考。
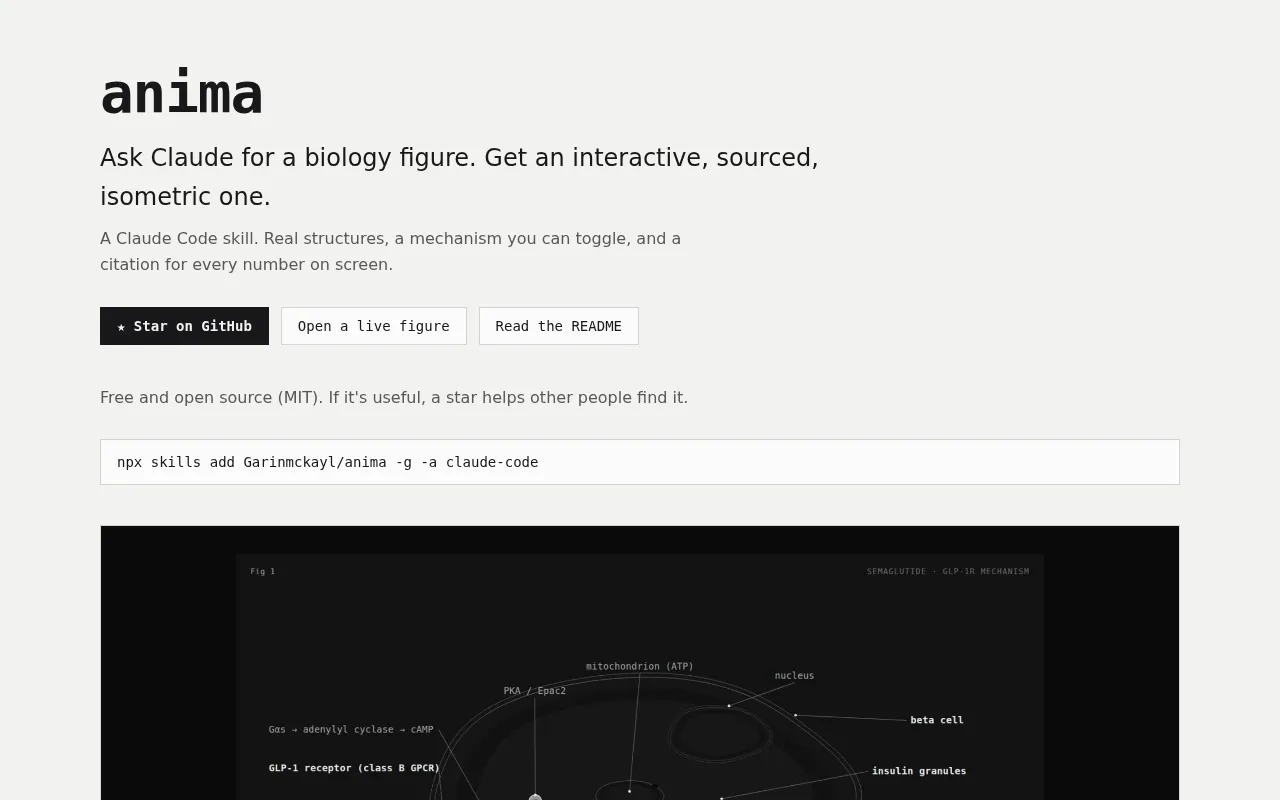
Anima:用自然语言生成交互式生物模型的开源工具
Anima是一个开源工具,允许用户用自然语言描述生物过程并生成交互式生物学模型。本文分析其定位、技术挑战与应用场景,适合生物信息学与教育科技从业者参考。

AI 内容创作者的每日抓取:从 Hacker News 热帖看技术社区关注点
从 Hacker News 热帖 "Men with Queer Nerves: The Jumping Frenchmen of Maine" 出发,分析技术社区对跨学科内容的关注偏好,以及 AI 内容创作者可借鉴的选题思路。

ClaimScope:不看标签的见证验证,让数学命题审计更可靠
ClaimScope 是一个 72 任务的数学命题审计基准,用标签盲见证检查器验证反例与修复方案。实验显示验证器反馈提升反例接受率至 23/39,但 verdict 准确率基本不变,收益主要来自见证结构修正。

从认证程序学习可执行制版搜索:SemDraft框架解析
SemDraft是首个从成对修改前后缝纫版型中学习搜索可执行制版程序的框架,通过三重认证机制(重编译、动作顺序判定、独立回放)恢复制版编辑步骤,学习型排序器在1000次搜索内认证63-64个案例,显著优于非学习型排序器的53-52个。

工具图记忆被高估?多轮工具调用研究揭示真相
最新研究在九个模型、两个基准上评估工具图记忆,发现其很少显著超越基线,增益主要来自额外计算而非记忆本身,且成本超两倍LLM调用。将经验存为文本洞察效果更优,几乎不增加调用成本,表明记忆应作为软先验而非工具规定。

Waypoint-OPD:用门控蒸馏迁移RL策略偏移
Waypoint-OPD通过引入中间检查点判断教师模型RL策略偏移的方向一致性,对端点偏移进行门控,在数学与代码推理的六个设置中取得最优蒸馏效果。

DialFork:对话智能体的过程幻觉评测新基准
DialFork 是首个面向原始对话文本的过程幻觉评测基准,由 IDIAP 发布。它通过受控分叉构造 36,278 段对话,覆盖 24 个任务、12 个领域,并提出 FlowKL 与 FlowScore 指标衡量对话流程偏离,证明语义相似度无法替代流程相似度。

知识注入可写性研究:GPT-2 受控实验与生产记忆对比
一项关于大模型知识注入的受控研究,用 GPT-2 2×2 实验对比 Qwen、DeepSeek 生产记忆系统,发现写入成功不等于提问可召回,词面命中率高但严格答案得分为零,并揭示锚定对漂移的抑制作用。

SCRIBE:让大脑语义研究从词袋走向上下文
SCRIBE 框架用开源大模型集成生成可解释的词级语义表示,在 921 人行为实验中达到人类噪声上限的 75-81%,并在自然叙事脑活动中显著优于非上下文语义表示,为真实语言语义的神经科学研究提供可扩展基础。

大脑-LLM对齐可被语义分解?SCRIBE框架给出新答案
研究利用SCRIBE可解释语义表示分解LLaMA2-7B与大脑活动的对齐关系,发现共享语义方差占主导,具体性语义属性贡献更大,为AI可解释性与神经科学提供新视角。

OPRD:让代码智能体摆脱"提醒依赖"的新训练法
OPRD通过On-Policy Reminder Distillation训练长周期编码智能体,训练时提供多粒度提醒、推理时完全移除,在SWE-bench系列基准上平均提升11.3个点,错误事件减少50.2%。

大模型会讲倒叙故事吗?非线性叙事基准测试揭示能力边界
一项涵盖83部出版作品的基准测试显示,19个大语言模型默认倾向线性叙事,即使用户要求非线性结构,读者仍认为模型写出的倒叙故事更难跟随。指令遵循与叙事能力之间存在显著差距。

SpecAgent:让强模型做审稿人,工具智能体推理成本减半
SpecAgent 提出轨迹级推测与语义验证协议,让弱模型起草工具调用轨迹、强模型单次前向验证,在 τ²-Bench 等基准上质量逼近强模型同时内存流量和延迟减半。

TITAN框架:破解低资源多语言翻译的稀疏电路机制
TITAN框架通过因果干预与稀疏特征分解识别多语言transformer中的翻译电路,仅更新不到5%参数,在印地语到乌尔都语和信德语翻译上实现BLEU提升33.75%和45.86%,并挑战了英语中转假设。

AI安全投资的市场激励:博弈论视角下的供应链分析
一项博弈论研究揭示AI供应链中安全投资的市场激励:下游竞争促使企业增加安全投入,而上游LLM提供商因补偿不足可能投资偏低。监管干预需针对激励错位设计。

未知自适应策略下的Bandit迁移学习:上下界新突破
多臂老虎机迁移学习新研究:当历史数据来自未知自适应策略时,KL-UCB-Transfer算法实现对数级遗憾并在特定条件下改进领头常数,还分析了单边约束下的三类遗憾区域。