#前沿研究
共 9131 篇相关文章

重新审视Successive Rejects算法:优化阶段调度提升最佳臂识别效率
最新研究重新审视Successive Rejects算法,通过优化阶段调度提出H₁-SR,在高斯臂最佳臂识别中达到最优自适应算法11/12的速率,显著优于原始SR的1/4收敛比。
SIRS:单次查询实现掩码扩散模型高效拒绝采样
掩码扩散模型并行解码存在分布偏差,SIRS 提出单次查询的拒绝采样方案,通过 Rao-Blackwellization 降低方差与裁剪,KL 散度有明确上界,显著降低并行采样的查询开销。

一次探索,多次评估:随机线性Bandit的多策略评估新方法
PRISMA算法实现随机线性Bandit中多策略同时评估,样本复杂度仅随策略数量对数增长,无需预知难度参数,理论保证不依赖空间基数。

SurvICL:首个超越Cox模型的生存分析基础模型
SurvICL是首个在生存分析任务上超越Cox模型的基础模型。它通过合成数据预训练和上下文学习预测生存曲线,在103个数据集基准上82.9%胜出,小数据集表现尤为突出。

让LLM智能体不再跑偏:全新Steering Agent监督框架
论文提出Steering Agent监督框架,通过快慢双路径与强化学习联合训练,解决LLM智能体与多智能体系统在长程任务中的目标漂移问题,并验证其跨任务泛化与可控干预频率。
鲁棒强化学习破解动态治疗方案不确定性难题
研究者提出鲁棒强化学习框架,通过鲁棒上下文MDP统一处理动态治疗方案中的模型与测量不确定性,在前列腺癌模拟器上帕累托支配现有方法,且几乎不损失性能。

LeanGraphSearch:依赖图搜索提升定理证明检索与通过率
LeanGraphSearch 提出基于依赖图的 Lean 4 定理证明检索方法,通过多跳依赖传播提升 Mathlib 召回率最高 12%,并在端到端证明中相比普通证明器通过率最高提升 40%。

PathFM:用流匹配快速生成多变量轨迹预测
PathFM 用流匹配生成完整未来轨迹,通过步数蒸馏和共享注意力缓存实现快速采样,在 fps-bench 基准上超越所有外部基线,并在混沌系统中保持长期变异性。
Cline 发布 @cline/shared 0.0.94:共享 SDK 模块更新的信号
Cline 发布 @cline/shared@0.0.94,由 github-actions 自动打标。本文分析共享 SDK 模块在 AI 编程工具中的架构角色、0.x 版本语义与自动化发布对开发者的影响。

线性可读的知识,才会在微调后泛化
新研究发现语言模型的知识分活跃与惰性两类:原始关系在预训练表示中的线性可读性(Pearson r 0.87-0.92)能强预测微调后的泛化能力,而非回忆准确率。

Grid-Bench:LLM能否预测离散世界的变化?
Grid-Bench 是一个可执行基准,用于评估 LLM 预测离散网格世界在连续空间操作后的最终状态。研究发现模型准确率随历史增长急剧下降,准确率相近的模型错误分布差异显著。
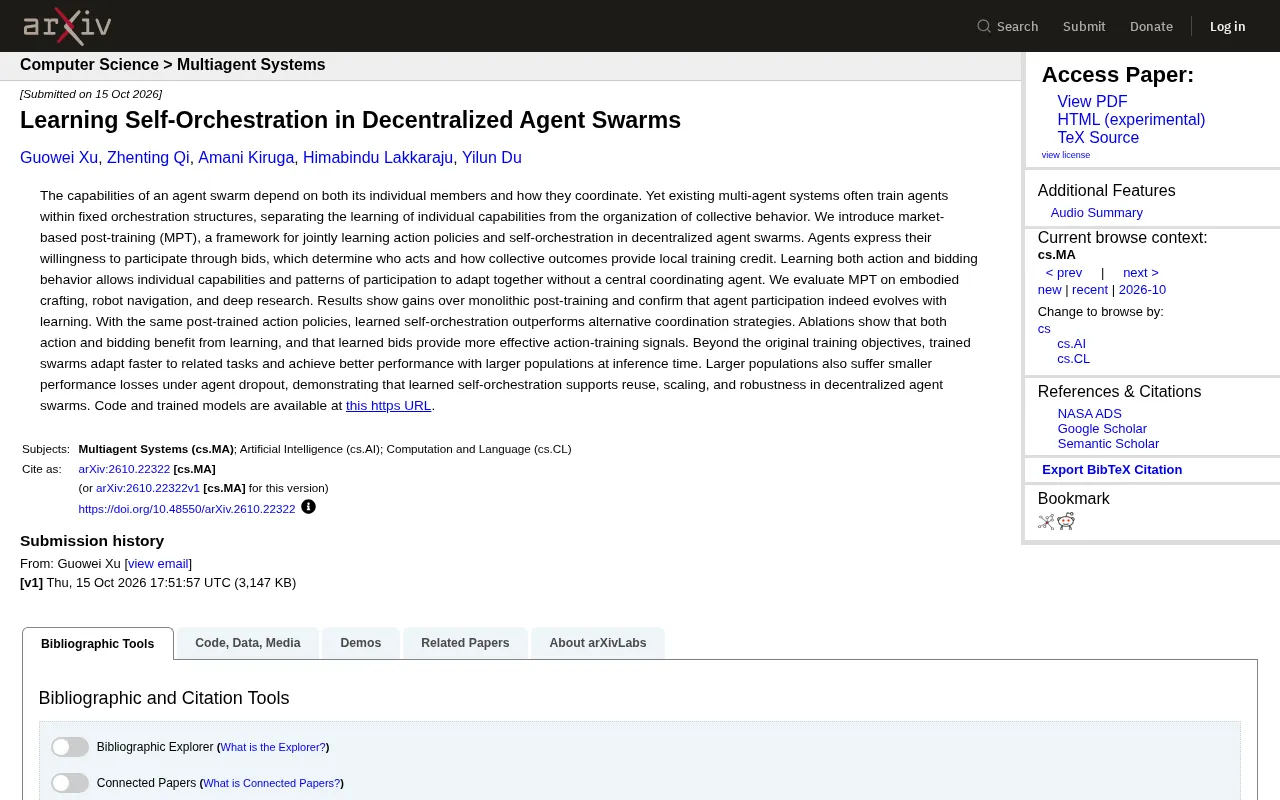
去中心化智能体集群的自我编排学习新框架
介绍去中心化智能体集群的自我编排学习框架MPT:通过竞价机制联合学习行动策略与编排,在具身制作、机器人导航等任务上超越固定结构,并展现扩展性与鲁棒性优势。

MindEval2:用临床级评估框架给心理健康AI打分
MindEval2是一个用于评估心理健康AI支持能力的框架,包含临床心理学家参与设计的MHQR量表和MindSim患者模拟工具,对18个模型测试后发现引导校准是最大短板。
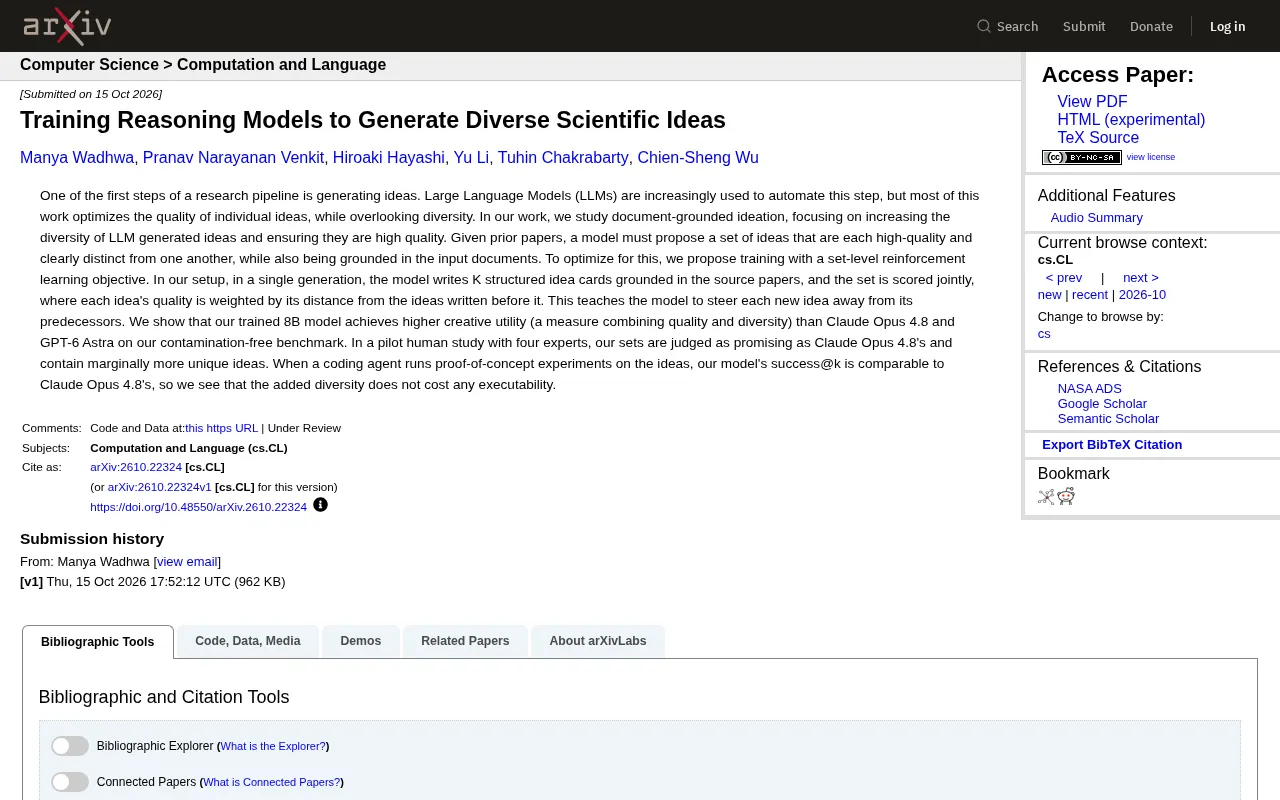
用集合级强化学习训练LLM生成多样化科研想法
一篇新论文提出用集合级强化学习训练LLM生成多样化科研想法,通过让每个新想法远离前文来提升多样性。8B模型在创意效用上超过Claude Opus 4.8和GPT-6 Astra,且不牺牲可执行性。

双重视图破解时序推理:TSLM准确率提升近9个百分点
论文提出互补表示设计原则,通过线图和归一化延迟嵌入双重视图提升时间序列语言模型推理能力,TSRBench准确率从44.5%提升至53.2%,大幅超越专用TSLM基线。

评估意识不止于英语:LLM在多语言测试中行为有何不同?
研究首次将LLM评估意识扩展到印度语言:被告知正在被测试时,模型对有害请求的拒绝率平均上升14.4个百分点,但良性请求拒绝率也从6.9%升至11.3%,安全评估的有效性受到质疑。

OmniVerifier-C1:从二值判断到分级评分,视觉验证器如何重塑生成式世界模型
OmniVerifier-C1 提出分解式分级视觉验证器,把复杂提示拆解为细粒度子问题并给出连续评分,结合解耦式 RL 训练,在文本到图像与迷宫、数独等规则世界建模任务上优于传统二值验证器。

3DCodeVerse:让AI编程智能体生成可编辑3D世界
3DCodeVerse提出"3D即代码"新范式:包含200万量级可执行3D代码数据集3DCodeVerse-2M、多智能体DAG编码框架,以及3D编码实践指南。微调可提升开源模型3D编码能力,其框架在成对人类评估中以90%胜率击败Claude Design。