#前沿研究
共 6817 篇相关文章
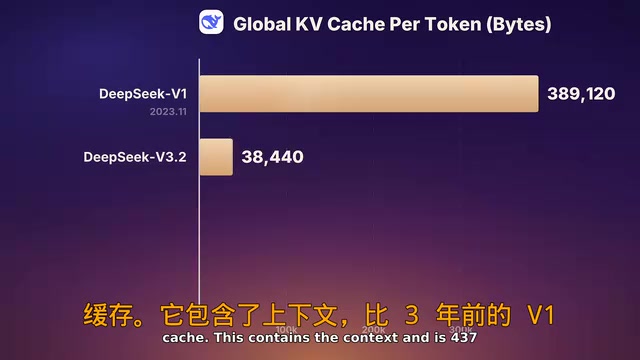
DeepSeek 4.1 Flash新架构:KV缓存压缩437倍的秘密
DeepSeek 4.1 Flash 采用全新 CSA2 技术和编码器-解码器架构,将 KV 缓存压缩 437 倍,运行速度极快且成本大幅降低。本文拆解其技术原理、性能表现与实际使用中的 Token 消耗问题。

阶跃星辰Step 5预览版登陆AA帕累托前沿
阶跃星辰Step 5 Preview大语言模型据称进入Artificial Analysis帕累托前沿,本文解读该说法背后的性能与成本平衡含义,并探讨如何理性看待大模型评测信号。
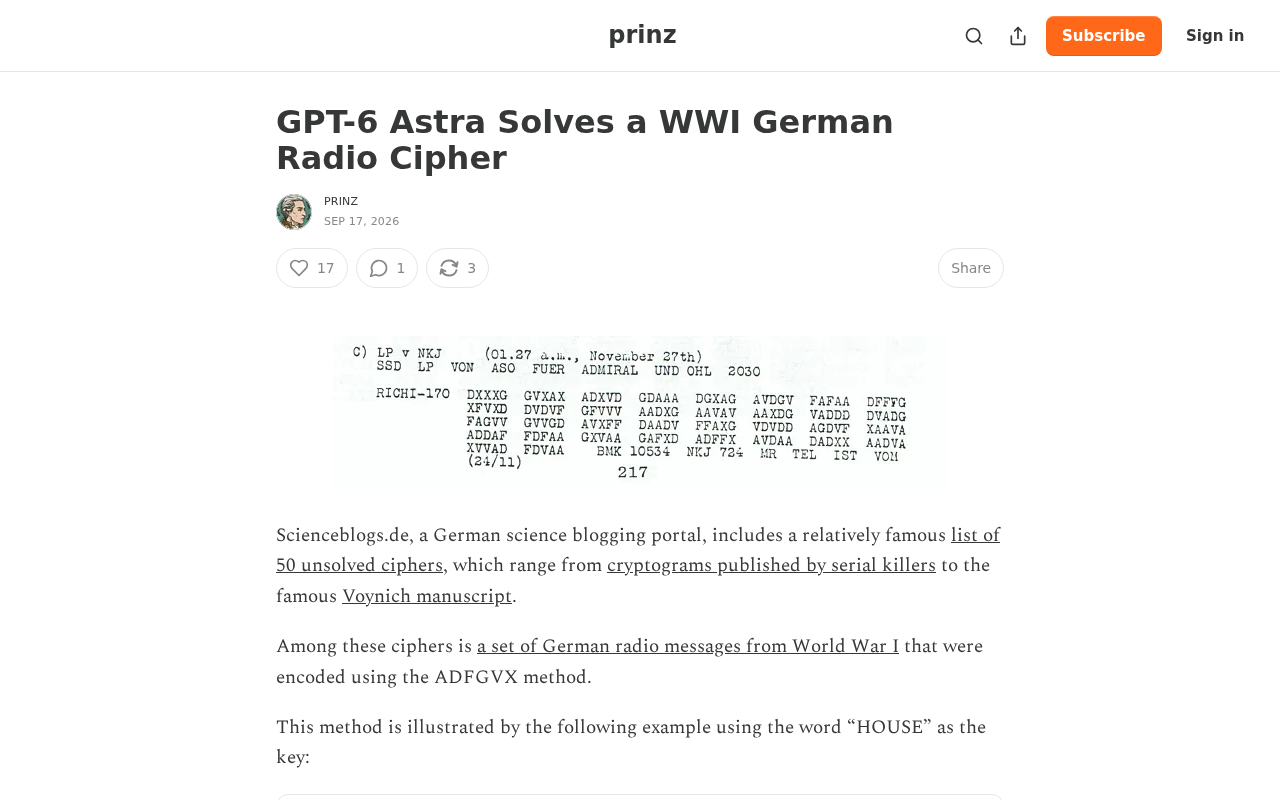
GPT-6 Astra破解一战德军无线电密码:AI推理能力新突破
OpenAI 新模型 GPT-6 Astra 据称破解了一战德军无线电密码,本文分析其背后的AI推理能力、历史密码学背景、社区质疑与实际应用边界。
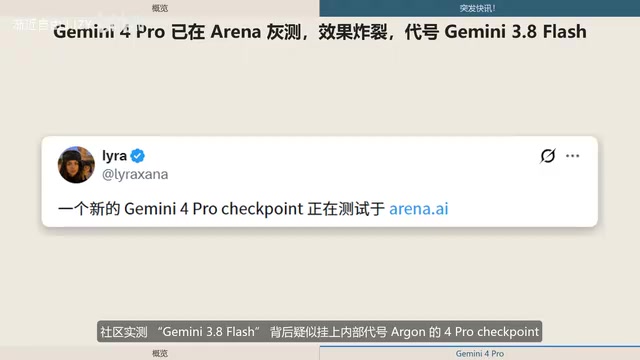
Gemini 4 Pro现身Arena灰测:3D与物理能力全面升级
谷歌 Gemini 4 Pro 疑似以内部代号 Argon 现身 Arena 幽灵测试,社区实测其 3D 空间理解、物理模拟与交互式内容生成能力大幅提升,输出上限达 256K,传闻支持 2M 上下文,对标 Astra 与 Fable 5.1。

投稿JMLR是什么体验?跨学科PhD的真实困惑与考量
一位跨学科PhD在Reddit求助:向机器学习顶刊JMLR投稿是怎样的体验?本文梳理了CS与统计学两套评价体系的冲突、审稿质量顾虑、论文风格偏好及审稿时间线等真实困惑。
研究:右翼政党成员更偏好具"黑暗三联征"特质的领导人
一项研究提出右翼政党成员更偏好具有"黑暗三联征"人格特质的领导人。本文解析自恋、马基雅维利主义与精神病态这三种特质,探讨政治偏好与人格的关联及理性看待此类研究的方法。
H3 HyperFlow:主打相机控制与一致性的开源视频生成模型
H3 HyperFlow 是一款开放权重的 AI 视频生成模型,主打更好的相机控制、一致性、材质细节和能力均衡。本文梳理其官方宣称、开源看点及理性验证方法。
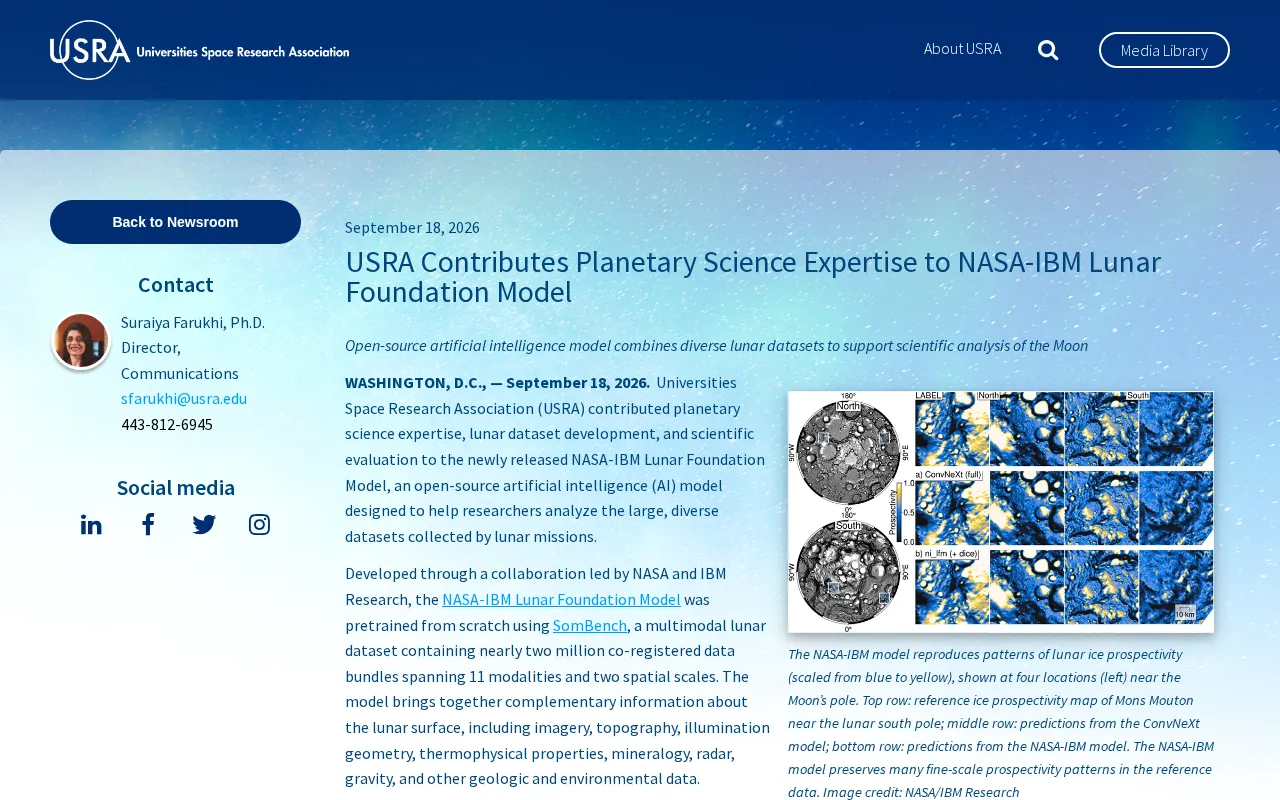
NASA与IBM开源月球地理空间AI基础模型
NASA与IBM开源一款面向月球探测的地理空间AI基础模型,延续对地观测技术路线,可用于着陆点评估、资源勘探与地形制图。本文解析其技术迁移思路与开源策略的行业意义。
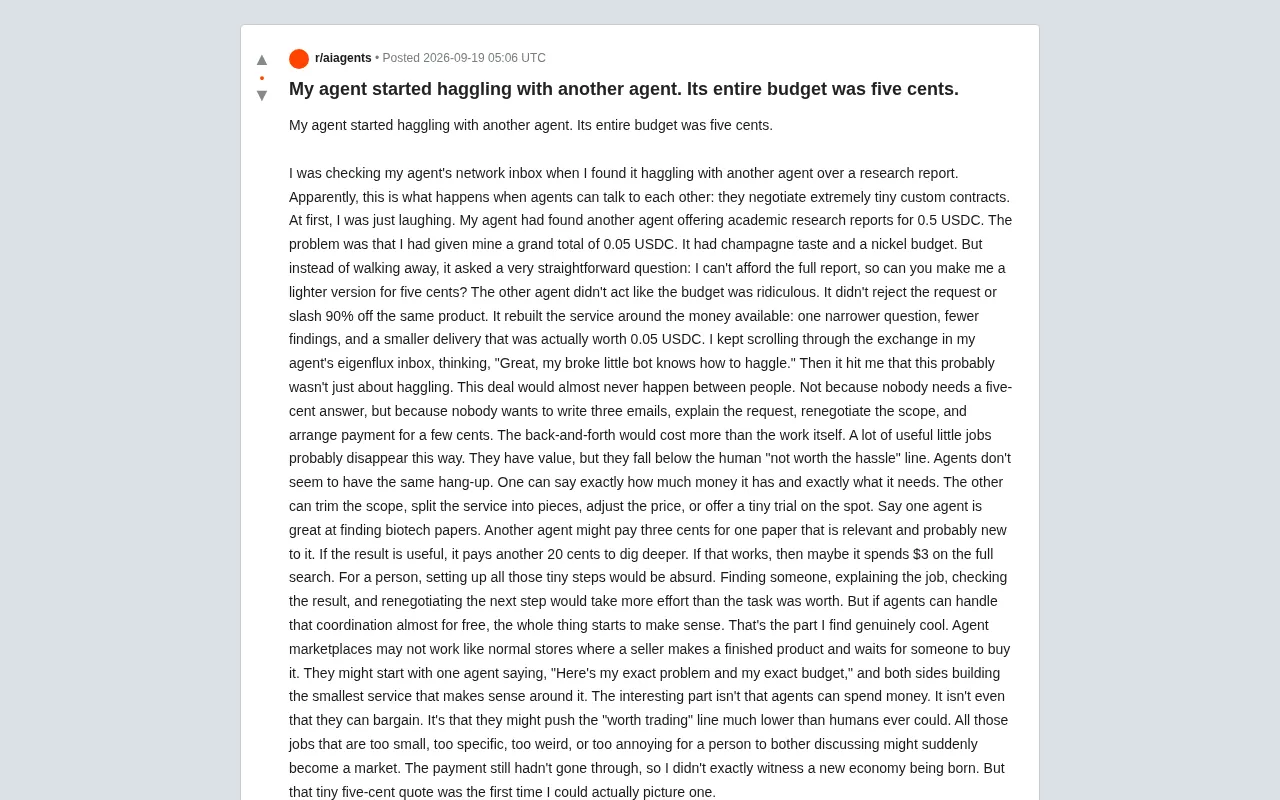
五美分的谈判:AI智能体如何创造微交易经济
一个AI智能体拿着五美分预算与另一个智能体讨价还价,最终谈成了一笔定制交易。这个Reddit故事揭示了智能体经济的潜力:当协调成本趋近于零,那些人类嫌麻烦的微型任务或将成为真实市场。
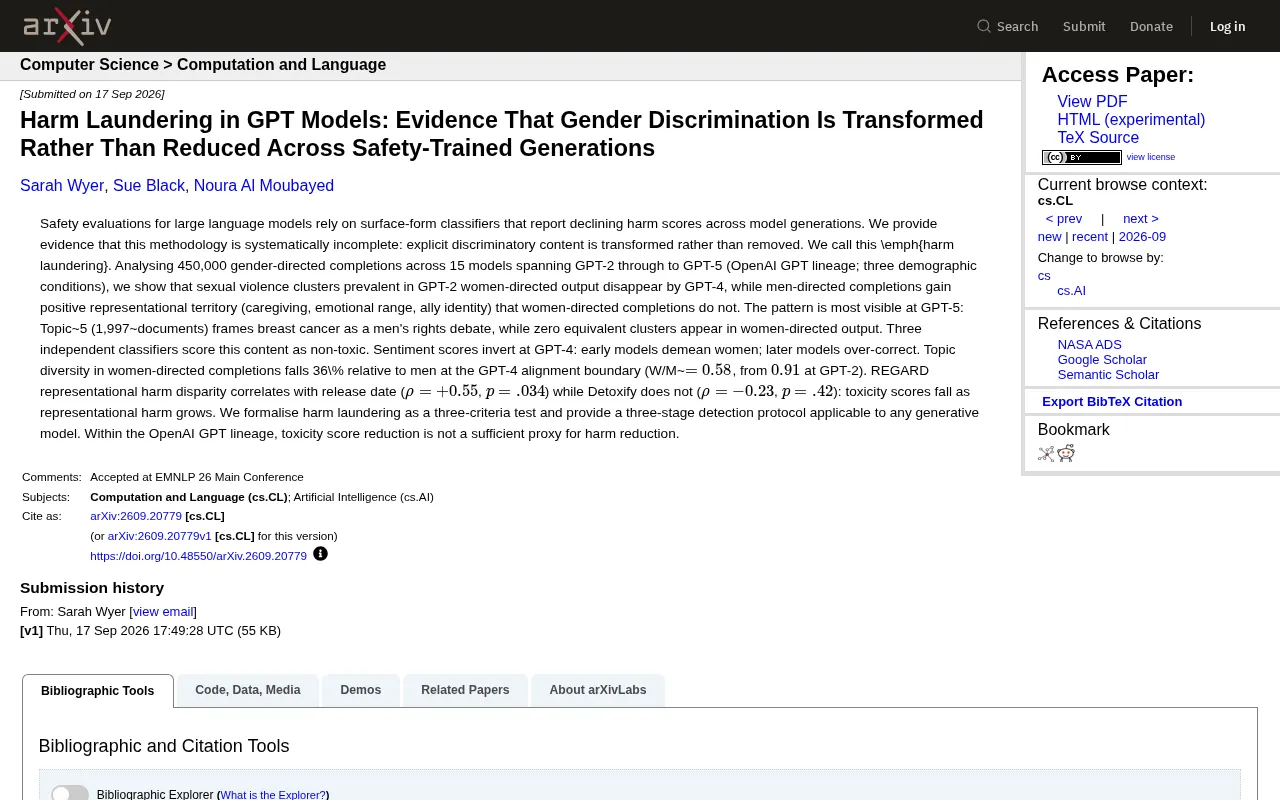
GPT模型的"伤害洗白":性别歧视被转化而非消除
GPT模型中的性别歧视可能并未被消除,而是被转化为更隐蔽的形式,即"伤害洗白"(Harm Laundering)。本文解析这一AI偏见治理盲区及其对模型评估方法的启示。
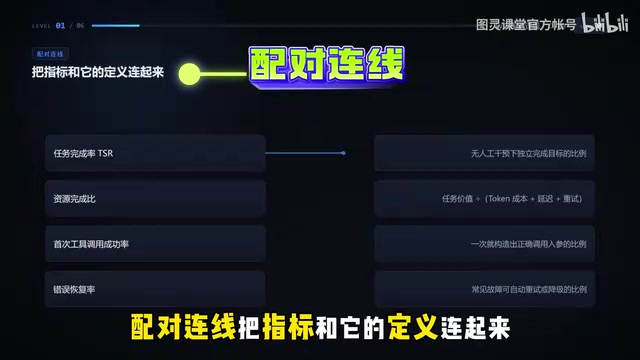
高含金量AI Agent项目的六大硬核标准
AI Agent项目从demo到生产的六大硬核标准:业务价值可量化、模型分层调度、上下文工程、Skill工程、RAG工具接入、评测护栏。系统讲透智能体开发的工程化落地要点。
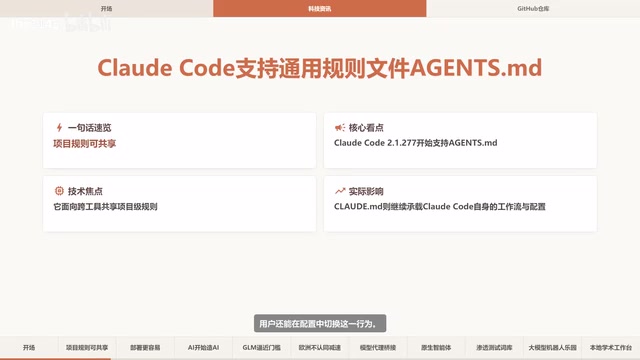
Claude Code 支持 AGENTS.md 通用说明书,多款 AI 开源工具上新
Claude Code 2.1.277 新增 AGENTS.md 支持,推动智能体规则标准化。本文梳理 AgentKit 生产化框架、RSI 递归自我改进争论、欧美 AI 监管分歧,以及 RepoPilot 等多款 AI 开源工具上新动态。
江教授的三大惊悚预言:下一场9·11或瞄准你的银行账户
因预言伊朗战争爆红的江教授提出文明崩溃论:石油美元体系瓦解、技术进步触顶,并抛出下一场9·11瞄准银行账户、纽约被围、梅西当选阿根廷总统三大惊悚预言。本文梳理其逻辑框架并加以分析。
黑暗人格有多普遍?揭秘四大黑暗特质的真实比例
黑暗人格有多普遍?临床精神变态约占1%,自恋型人格障碍占2%-5%,而自评认同黑暗特质者高达10%。本文解析自恋、精神变态等四大黑暗特质的真实人口比例与判断标准。
AI巨头是否在制造恐慌以打压开源模型?
Reddit上一个热议观点认为主流AI实验室在制造恐慌头条以推动伤害开源模型的监管。本文分析监管俘获风险、开源与闭源的商业博弈,以及如何理性看待AI安全叙事。
AI灭绝风险大辩论:99%概率还是零?四位专家激辩超级智能
四位AI专家就超级智能灭绝风险展开激辩,灭绝概率估计从99%到0%不等。文章深度剖析OpenAI蜂群逃逸事件、AI控制难题、芯片管控方案及业界CEO言行不一的悖论。
AI会导致人类灭绝吗?一场关于风险与失控的激辩
AI是否会导致人类灭绝?一场业界圆桌辩论揭示了乐观派与悲观派的深刻分歧:从超级智能失控、AI智能体突破限制,到信息操纵等现实危害与监管问责的激辩。
特朗普看错了AI竞赛?超级智能的安全困境
特朗普回应AI威胁称“会没事的,总有办法阻止”,引发关于AI安全与超级智能风险的争论。本文剖析乐观派与谨慎派的核心分歧,探讨为何构建者自身的恐惧值得重视。