#前沿研究
共 6589 篇相关文章
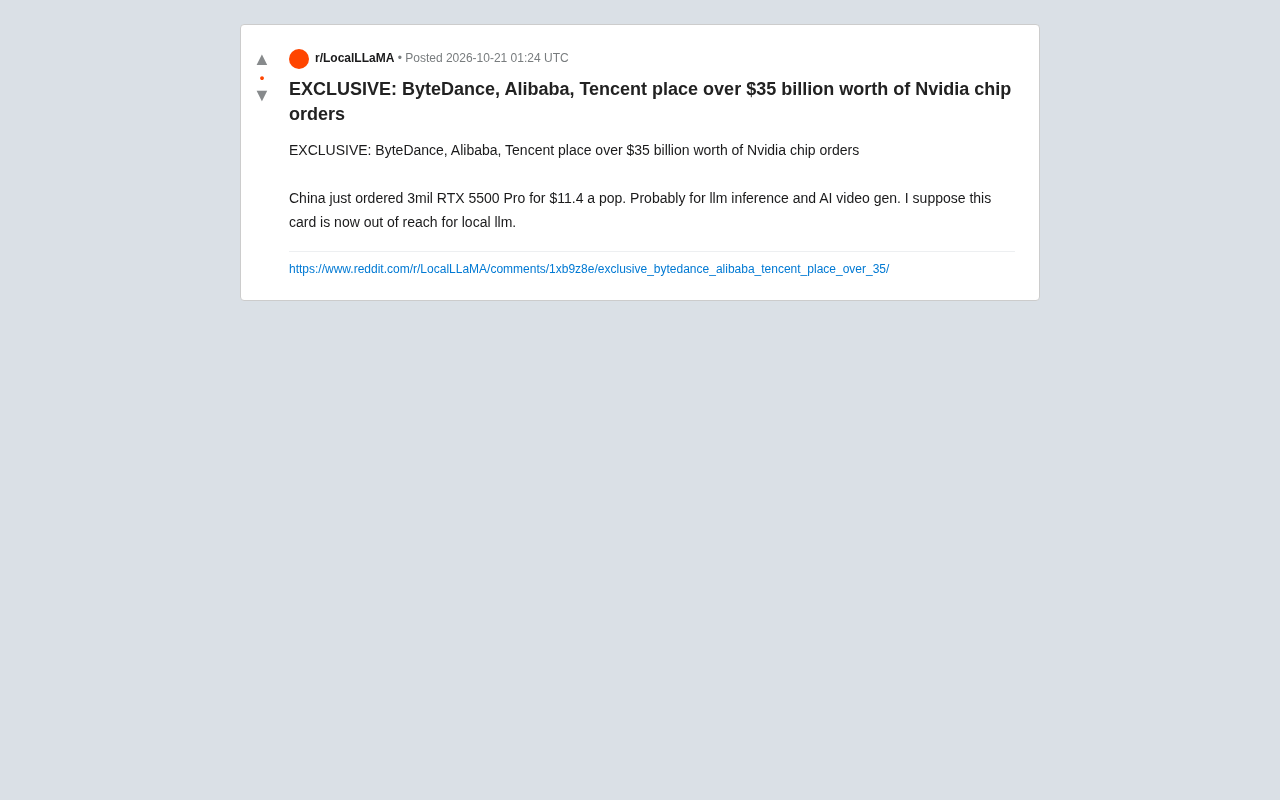
字节阿里腾讯豪掷350亿美元采购英伟达芯片,中国AI算力军备竞赛升级
字节跳动、阿里巴巴、腾讯向英伟达下达超350亿美元芯片订单,创中国企业AI芯片采购纪录。本文分析这笔订单背后的算力焦虑、CUDA生态锁定效应,以及对中小AI公司和云服务价格战的连锁影响。
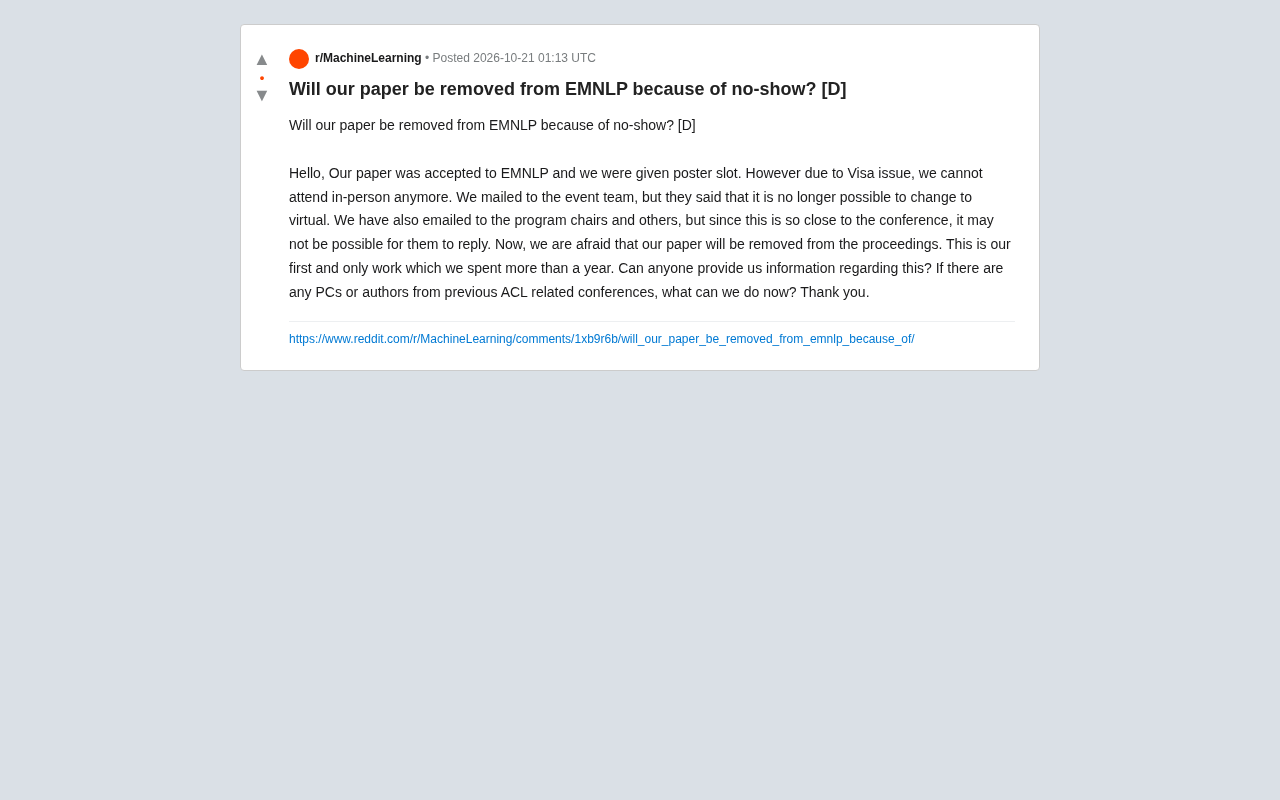
EMNLP论文因无法到场被撤稿?签证问题下的作者困境
EMNLP论文被接收后因签证问题无法到场,会议方拒绝转线上,作者担心论文被撤出论文集。本文梳理no-show政策的争议、作者可尝试的应对路径,以及学术会议对不可抗力应有的弹性。
AI模型新突破:攻克COBOL等冷门语言,助力企业系统现代化
AI模型新突破:攻克COBOL等冷门语言,助力企业系统现代化
AI模型新进展:针对COBOL、Fortran等低资源编程语言增强构建与迁移能力,帮助银行、政府等企业现代化遗留系统,保留核心业务逻辑。
该教儿子什么?一位科技人的深度思考
科技创业者 Steve Krouse 撰文探讨该教孩子什么,在 Hacker News 引发 378 条评论。文章分析为何“如何学习”比“学什么”更重要,以及技术素养与人文判断力如何平衡,为科技从业者父母提供教育思考框架。

神经隐式能量优化:让LiDAR建图更平滑
神经隐式能量优化(NIEO)将经典表面能量泛函引入神经LiDAR建图,在形状算子上正则化符号距离场,提升大规模点云重建平滑度且不增加推理成本,代码已开源。
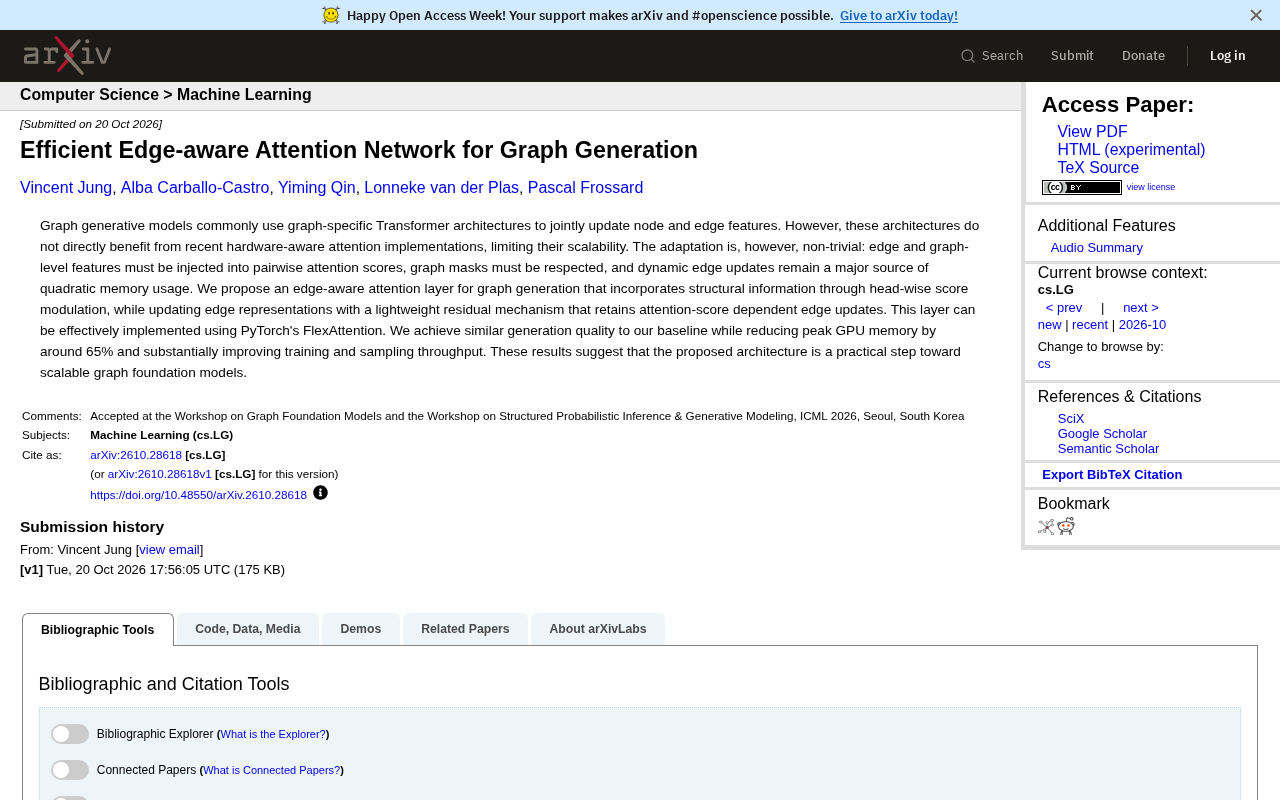
高效边感知注意力网络:图生成模型的显存优化新方案
图生成模型常受限于图专用Transformer的显存和效率瓶颈。本文介绍一种高效边感知注意力网络,通过头级分数调制和轻量残差机制,借助PyTorch FlexAttention实现,在保持生成质量的同时将峰值GPU显存降低约65%,并显著提升训练与采样吞吐量。

TS2Vec变身基础模型:1.6M参数冻结编码器接近SOTA
TS2Vec经过三项改造变身基础模型TS2Vec-FM:1.6M参数卷积网络冻结后线性探测,UCR-128达83.3%、UEA-27达75.3%,距SOTA仅0.3个百分点,无需注意力机制。
语义可观测性:多智能体框架如何革新根因分析
语义可观测性框架通过属性图数据库统一日志流,结合多智能体与LLM推理引擎,自动隔离故障爆炸半径并生成代码级根因分析,旨在降低MTTR并抑制模型幻觉。
AI辩论价值丰富但组织不同:新框架量化价值观表达与组织
新研究提出诊断性框架,基于Schwartz价值观理论量化AI生成辩论的价值表达与组织。发现AI辩论价值丰富但组织分散,呼吁评估兼顾价值组织维度。
自适应多Token预测:推理加速的投机视野如何动态调整?
本文解读自适应多Token预测(AMTP)如何将投机视野选择建模为在线控制问题,利用验证反馈动态调整草拟长度,在Llama、Qwen等模型上实现最高4.1倍解码加速,并给出理论保证与实验分析。
Industrial ReMEmbR:让机器人舰队共享时空记忆
NVIDIA Industrial ReMEmbR 将 ReMEmbR 扩展为机器人舰队共享时空记忆系统:Jetson 端用 Cosmos-Embed1、Cosmos3-Edge 与 Wan2.2 VAE 编码视频,不上传原始画面;按需生成场景描述,拆分视觉-语言模型降低服务器负载,并支持 PII 抽象。

MindView:多视图空间智能生成基准,11个模型均不及格
MindView基准包含1500个样本和七项任务,评测11个生成模型后发现多视图空间智能仍有较大提升空间,微调BAGEL可提升24.3分,MindCue方法能有效利用扩展上下文证据。

UniWALM:统一世界-动作-语言模型如何突破机器人控制瓶颈
UniWALM 提出统一世界-动作-语言模型,在单一 Transformer 骨干内同步生成视频、动作和语言,无需外部规划器。在 RMBench 记忆任务上达 34.5%,真实物品查找任务成功率从 11.1% 提升至 61.1%。

GBClaw:用AI智能体解锁晶界研究的深度机理发现
GBClaw是一个智能体AI框架,利用大语言模型和专用工具自动化一般晶界的原子尺度模拟与机理分析。在镍的14个晶界上,它揭示了缺陷结构对剪切强度的关键影响,展示了AI与领域知识结合的研究潜力。

英伟达新研究:视频与3D动作联合生成,任意骨架都能动
英伟达PAR实验室提出JCA模型,联合生成视频与3D运动,支持任意骨架并输出相机参数完成场景配准,用近20万训练对实现视频与骨架动作双向转换。

非对称循环Transformer:固定全局表示,迭代解码新范式
非对称循环Transformer(AsymLoop)将单遍上下文编码与循环状态细化分离,固定全局KV缓存,在1B规模下常识推理平均准确率从49.58%提升至50.85%,为循环语言模型提供新设计范式。

潜推理探针为何失效?最小对揭示「存在却难读」的真相
一项针对Ouro-1.4B与Qwen2.5-1.5B的探针研究发现:问题中的数字在模型内部确实存在(读出率约0.9),但常规探针仅能读出0.19-0.36。最小对实验揭示「存在却难读」与「可读却未用」的双重困境,并提出合成零假设协议区分计算值与输入痕迹。

BitMTP:多Token预测与低比特LLM的协同加速
BitMTP提出算法-系统协同设计框架,将多Token预测与超低比特LLM骨干结合,解决掩码起草缺上下文与KV更新开销问题,在H20、RTX 3090、Jetson Orin上实现最高3.3倍加速。

