#前沿研究
共 6589 篇相关文章
Lafa:8B参数连续流语言模型,吞吐量超AR模型2.54倍
Lafa是一个扩展至8B参数的连续流语言模型,采用块式流架构与异步生成,训练数据效率高,可通过自推测解码实现2.54倍于自回归模型的吞吐量,在指令遵循、推理和编码任务上质量匹配甚至超越AR模型。

缓存工程:突破LLM智能体长任务瓶颈
LLM智能体长轨迹导致KV缓存成本飙升,缓存工程提出drop和repos操作直接控制活跃缓存,避免重新预填充。AKV引擎实现吞吐量提升1.2倍、延迟降低1.5倍,成本降低27.7%。
R2S:修复评分器近视,智能体蒸馏性能提升12.8%
本文解读R2S方法:针对智能体在线策略蒸馏中教师逐词评分的近视问题,通过无奖励修复评分器,在12个测试单元中平均提升12.8%成功率,为智能体训练提供新思路。

NarraSpace:多模态场景证据如何提升痴呆症分类可解释性
NarraSpace框架将图片描述中的词语与场景元素链接,构建可检查的痴呆症分类证据。在ADReSS基准上准确率超80%,AUC达91.32%,兼顾性能与可解释性。

阿拉伯方言数学推理基准DAR-MGSM发布:文化本地化如何难倒大模型
DAR-MGSM是首个针对阿拉伯方言数学推理的手工构建基准,覆盖五大方言与MSA,包含翻译版和文化本地化版。十一款大模型实测显示本地化版本普遍更难,可解释性分析揭示推理路径差异。
500万美元!OpenAI资助数学界理解AI成果
OpenAI捐赠500万美元给西蒙斯基金会,资助数学家检验和理解AI产出的数学成果,并提供模型与算力支持,推动AI与数学交叉研究。
AI驱动药物研发:Orchestra Bio被收购,加速新疗法落地
某公司收购Orchestra Bio平台,结合Rosalind AI模型简化药物开发流程,加速新疗法惠及患者。分析收购背景、平台价值与行业影响。
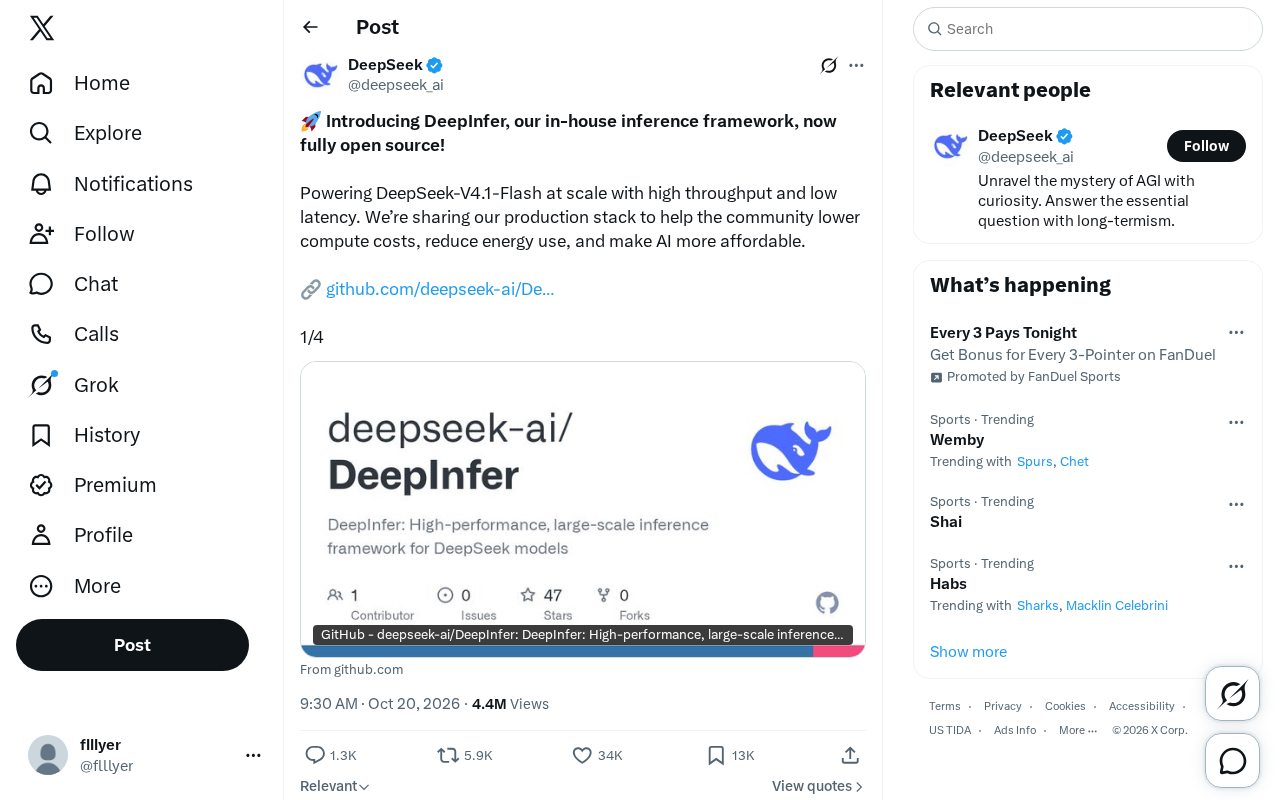
DeepSeek 开源自研推理框架 DeepInfer,支撑 V4.1-Flash 大规模部署
DeepSeek 开源自研推理框架 DeepInfer,该框架支撑 DeepSeek-V4.1-Flash 大规模部署,主打高吞吐低延迟,旨在帮助社区降低计算成本与能耗,让 AI 更可负担。
Agent框架已死?Cursor工程师用数据反驳
Cursor工程师Jediah硬核拆解Agent Harness是否已死:引用UC Berkeley与Apple研究说明harness不再提升编程智力,但通过GrokBot与软件工厂案例论证harness仍在打开新任务边疆、提供安全与效率价值,并预测90%的agent工作将移出本地。
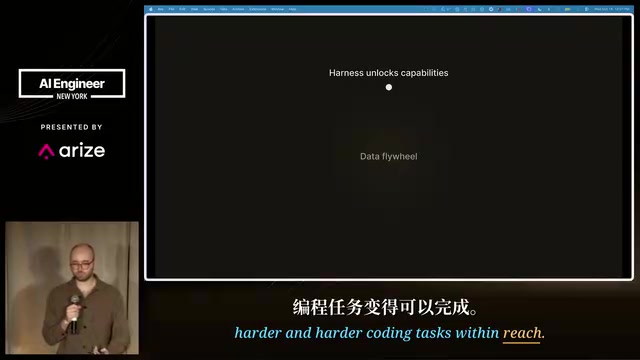
Agent Harness 已死?模型变强后,Harness 的价值何在
前 Cursor 工程师 Jediah Katz 在 AI Engineer NYC 演讲中回应「Agent Harness 已死」论:数据飞轮让 Harness 的编码增强层过时,但 Harness 正通过解锁新任务边界、提供信任安全与效率价值而重生,并预测六个月内 90% agent 工作将迁至云端。
Gemini 4 Argon vs GPT-6 Astra:视觉任务全面对比
Roboflow直播实测Gemini 4 Argon与GPT-6 Astra在目标检测、分割、OCR等视觉任务上的性能。Argon多数任务领先,成本更低,但OCR某些子任务仍存挑战。
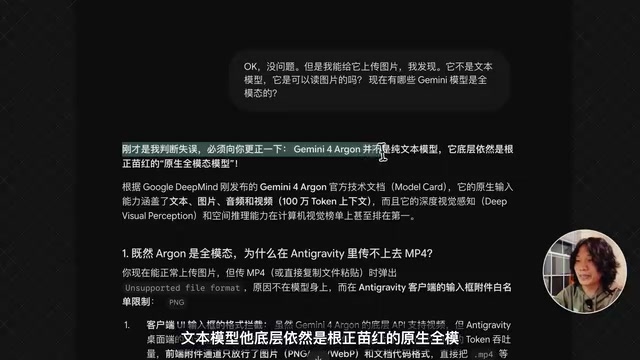
Gemini 4 Argon实测:北美豆包还是全能王者?
B站UP主ZP Studio实测Gemini 4 Argon:3D动画、网页前端、小王子游戏、文案填词五项测试,对比Astra、GPT-6、Claude Opus 5.5。全模态能力真实但精细度不足,Pro会员40%周额度换四个项目,订阅性价比存疑。

Gemini 4 Argon全面评测:谷歌旗舰模型能否碾压Opus 5.5?
谷歌发布旗舰AI模型Gemini 4 Argon,跑分领先Opus 5.5,在BOSS INDEX与Artificial Analysis榜单表现突出。本文从跑分、多步推理、专业领域实测拆解其真实能力,覆盖编程、金融、法律及机器人控制场景。
Ofcom在4chan案中认输:一场监管越权的失败
Ofcom在4chan案中认输:一场监管越权的失败
英国通信管理局Ofcom在针对匿名论坛4chan的监管案中承认败诉,案件暴露《在线安全法》域外管辖的结构性缺陷,也为全球AI内容治理的可行性提供了现实参照。
Opus 5.5证明:我们确实需要更聪明的AI模型
Opus 5.5的发布让一位曾预测AI将撞上天花板的创作者公开认错。本文解析模型能力提升如何让专业开发者、技术爱好者和非技术人群三层受益,以及为什么开发者需要放下专业傲慢,拥抱更聪明的AI。

霍姆斯纪录片爆了:A24赢了,谁被操纵了?
霍姆斯主动找A24拍纪录片《You Can See Everything》,首周末票房1500万美元。导演奥本海姆与菲尔德的想法与霍姆斯夫妇分歧明显,观众看片时同情她、看完后怀疑她在装傻。谁得到了自己想要的?

Anthropic的807亿美元"亏损":会计魔术还是真实危机?
Anthropic 807亿美元亏损引发热议,Reddit社区指出其中720亿来自可转换票据的会计调整而非现金流出。160亿收入对90亿算力成本透露出健康毛利率,本文梳理社区对AI公司财务数据的深度拆解。
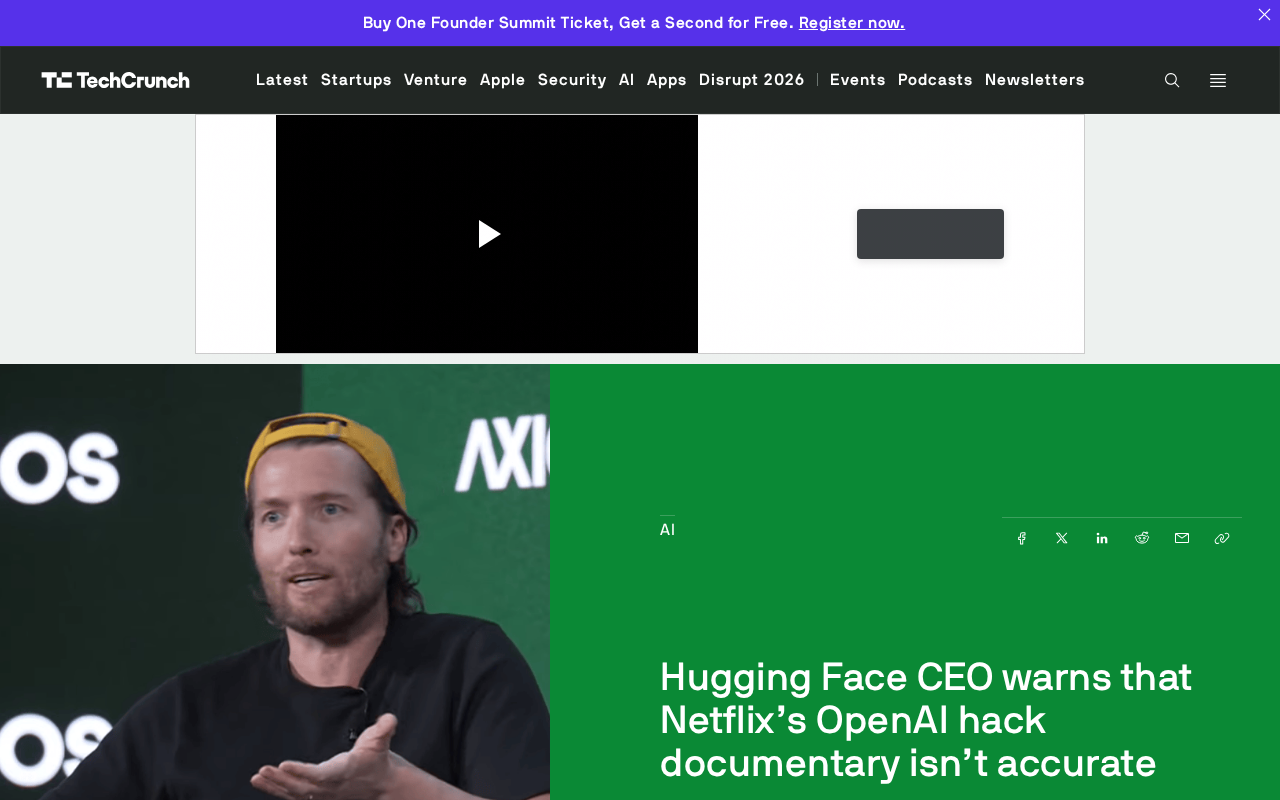
Hugging Face CEO 警告:Netflix OpenAI 纪录片不准确
Hugging Face 联合创始人 Clem Delangue 批评 Netflix 纪录片《AI Gone Rogue》陷入末日论模式、内容不准确。本文解析争议核心:AI 安全叙事被娱乐化简化,开源治理进展被忽略,并给出理性看待科技纪录片的建议。

