#前沿研究
共 8622 篇相关文章
 科技前沿
浏览器扩展成AI代理后门:Claude Dispatch被滥用执行任意代码
安全研究者演示恶意浏览器扩展如何滥用Claude Dispatch任务中继功能,在用户本地机器触发任意代码执行。文章分析AI代理攻击面扩张、指令来源校验缺失的结构性问题,以及企业环境在执行时约束代理行为的分层防御思路。
 科技前沿
Show HN: AI智能体从乐高图纸推断机构并动画演示
Hacker News上的Show HN项目展示AI智能体从乐高资料中推断机械机构并生成动画的能力,涉及零件识别、运动推理与动态可视化,是机械推理与AI结合的一次早期尝试。
 科技前沿
SketchAgentBench:用草图评测LLM三维空间推理能力
SketchAgentBench 是 Hacker News 上出现的 LLM 评测基准,通过草图任务考察模型的三维空间推理能力,填补现有基准在空间认知评测上的空白。
 科技前沿
小模型按需求助大模型:4倍降本的混合推理方案
Hacker News 讨论显示,小模型 Jev 在遇到难题时向 Opus 求助,可在达到相近准确率的同时将成本降至四分之一。本文解析求助式混合推理的架构原理、成本结构变化与落地时的权衡要点。
 科技前沿
AI正大幅加速AI研究:自我改进循环已开启?
从Hacker News一条讨论出发,解析AI加速AI研究的真实边界:哪些环节在提速、自我改进循环是否成立、以及评测瓶颈与同质化风险。
 科技前沿
Google新型线性注意力Muir:25MB状态容纳1000万token
Google Research提出Muir线性注意力模型,通过敏感度分配门控与匹配滤波读出,用约25MB状态存储1000万token上下文,本文解读其核心机制与社区反响。
 科技前沿
自博弈AI打分越高,对战人类越差?Minecraft剑术实验揭示负相关
Minecraft剑术自博弈AI实验发现:机器人对战判断力与人类对战判断力呈负相关(ρ=-0.73),对手模型的记忆增益实为基线伪影。价值头不迁移,专用玩家模型有效但记忆无益。
从Linux到维基百科:志愿者如何构建互联网
从Linux到维基百科:志愿者如何构建互联网
解读MIT Press文章《从Linux到维基百科:志愿者如何构建互联网》,分析志愿协作如何支撑开源基础设施,结合Hacker News讨论呈现支持与质疑两种视角,并探讨其对AI时代公共品治理的启示。
 科技前沿
数据稀少也能预测分子行为:CheMeleon方法解析
CheMeleon是一种机器学习方法,旨在用更少、更不详细的实验数据预测分子行为,从而降低新药和分子研发的数据门槛。本文解析其思路、潜在意义与尚待验证的局限。
 深度解读
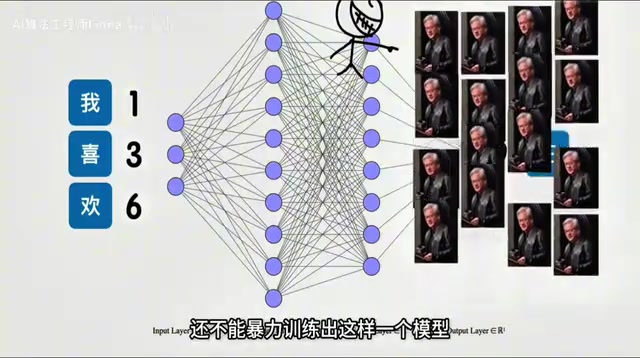
Transformer本质解析:一个被拆解的文字接龙函数
用文字接龙的视角理解Transformer本质。将复杂的语言生成任务拆解为Embedding、Transformer Block、概率输出三大模块,帮助深度学习初学者快速建立直觉。
 深度解读
MCP与A2A协议详解:智能体互联互通的USB时代
深入解析MCP(模型上下文协议)与A2A(智能体间协议)的架构原理、核心功能与协作关系,帮助开发者理解智能体如何通过通用协议实现即插即用的互联互通。
 科技前沿
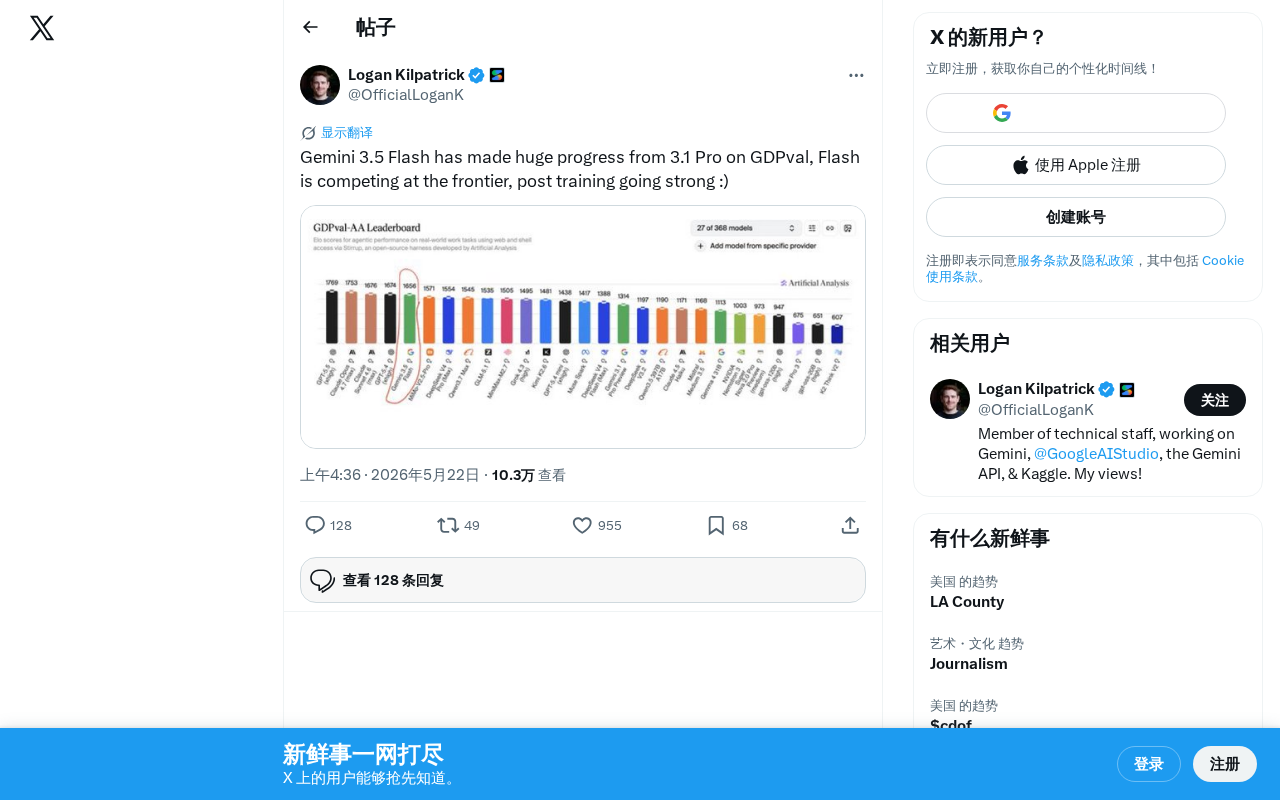
Gemini 3.5 Flash在GDPval基准上实现巨大飞跃
Google Gemini 3.5 Flash在GDPval基准测试中超越Gemini 3.1 Pro,轻量级Flash模型借助后训练技术逼近前沿水平,重新定义性能与成本的平衡点,为AI应用开发者带来重大利好。
 科技前沿
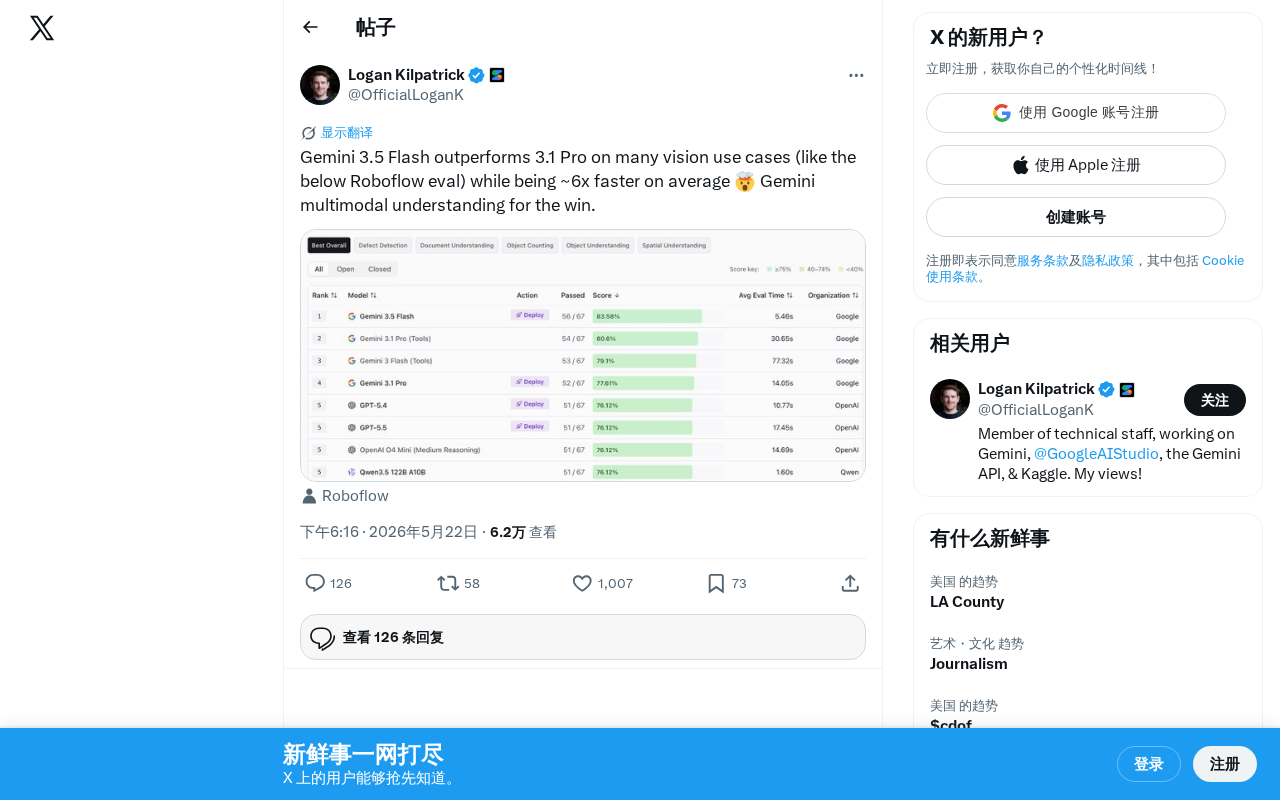
Gemini 3.5 Flash视觉能力超越Pro版,速度快6倍
Roboflow评测显示Google Gemini 3.5 Flash在多项视觉理解任务中超越Gemini 3.1 Pro旗舰模型,推理速度快约6倍。轻量级模型实现性能与速度双赢,为开发者提供高性价比的多模态AI方案。
 深度解读
AI幻觉:大模型为何必然会「胡说八道」及应对策略
深入解析AI幻觉的三大根因:训练目标缺陷、曝光偏差与概率生成机制,详解事实性幻觉与忠实性幻觉的分类体系,并提供RAG检索增强、评估层验证等务实应对框架。
 深度解读
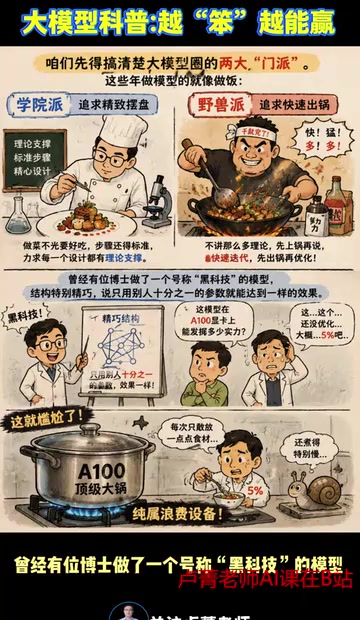
大模型设计的"差就好"哲学:简单粗暴为何胜过精致复杂
解析大模型架构设计中的"差就好"哲学:为什么DeepSeek V4弃用N-gram?为什么Transformer统治AI领域?从硬件对齐、快速迭代、统一架构三条铁律,揭示简单高效的模型设计为何总能胜过精致复杂的方案。
 科技前沿
Claude驱动NASA火星车规划路线,Windsurf推出IDE模型竞技场
Claude为NASA毅力号火星车规划行驶路线,Windsurf推出Arena Mode实现IDE内模型对比,商汤开源多模态推理模型,Anthropic研究揭示AI辅助学习的利弊。汇总AI领域最新动态。
 深度解读
大模型训练全流程解析:预训练、SFT微调与偏好对齐通俗详解
详解大模型训练三大核心阶段:预训练、有监督微调(SFT)、偏好对齐(DPO/PPO),涵盖LoRA、模型蒸馏量化剪枝等关键技术,帮助开发者理解从Base Model到Chat Model的完整流程。
 观点碰撞
新教工作伦理如何被劫持:从保护工人到压迫工人的演变
哲学家Elizabeth Anderson揭示新教工作伦理如何从保护工人的理想被扭曲为压迫工具。从清教徒的公平商业伦理到新自由主义的复活,深度解析工作伦理的历史演变及其对AI时代劳动关系的启示。