SketchAgentBench:用草图评测LLM三维空间推理能力

SketchAgentBench以草图任务评测LLM三维空间推理能力,填补基准空白。
文章介绍了Hacker News上出现的SketchAgentBench,这是一个以草图任务为核心、专门评估大语言模型三维空间推理能力的基准测试集。文章指出,现有基准多聚焦语言或二维视觉任务,对“从草图到三维结构”的认知过程缺乏系统考察。SketchAgentBench利用草图天然携带的视角、遮挡、比例等空间线索,试图区分模型是真正理解几何关系还是仅靠语言模式匹配。文章推断其评测可能涉及二维到三维推断、空间关系判断与草图生成修改等维度,并强调空间推理对具身智能、机器人导航的基础意义。同时提醒,该基准的具体任务设计与评分标准尚未公开,结论需谨慎解读。
为什么需要专门评测LLM的3D空间推理?
大语言模型在文本理解、代码生成等任务上表现亮眼,但涉及三维空间想象和推理时,能力边界仍不清晰。现有基准多聚焦语言或二维视觉任务,缺少对“从草图到三维结构”这一认知过程的系统考察。
Hacker News 上出现的 SketchAgentBench 正是瞄准这一空白:它通过草图任务来评估 LLM 的三维空间推理水平,为研究者提供一个可复现的评测视角。
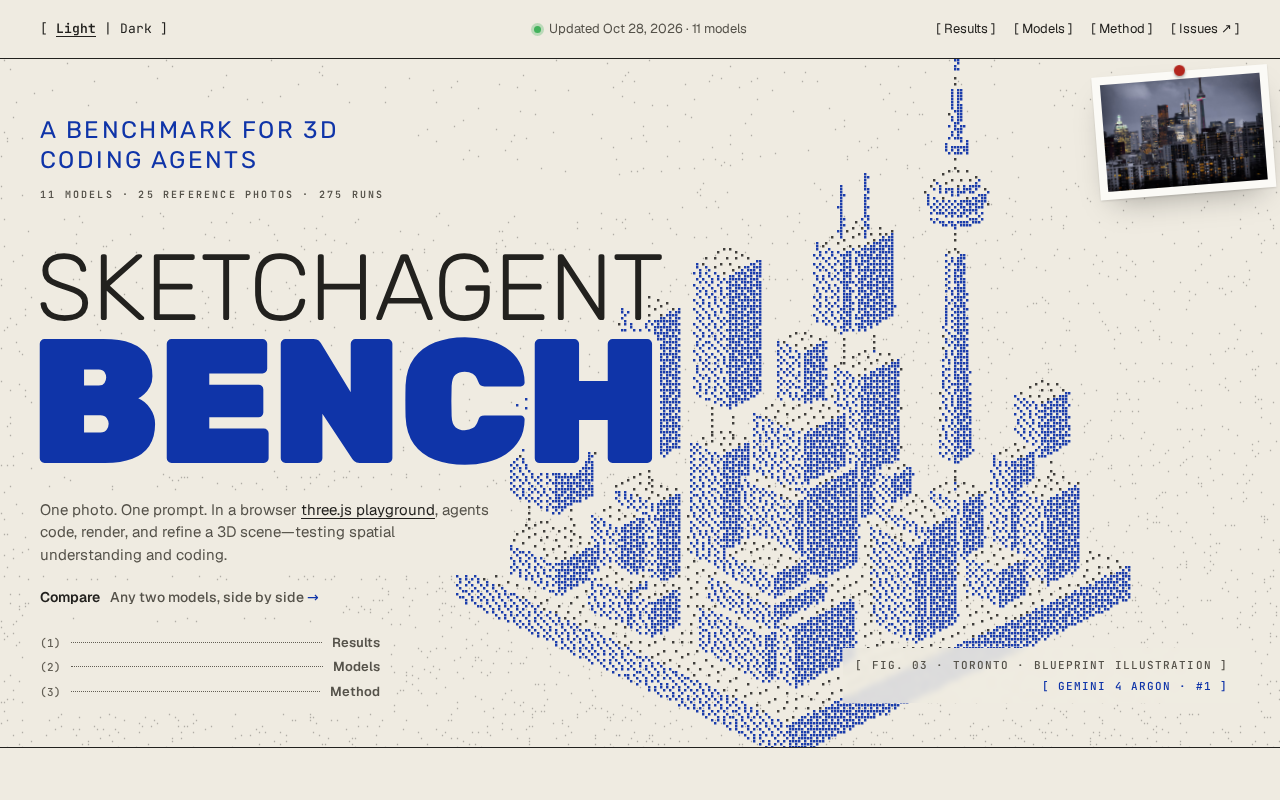
SketchAgentBench 是什么?
根据项目名称与发布信息,SketchAgentBench 是一个面向 LLM 的基准测试集,核心思路是让模型处理与草图相关的空间任务,从而检验其是否真正理解三维几何关系,而非仅靠语言模式匹配。
草图作为一种低门槛、高信息密度的表达形式,天然包含视角、遮挡、比例等空间线索。要求模型基于草图进行推理,能够暴露其在空间表征上的短板。
可能的评测维度
虽然原始素材未展开具体任务设计,但从“3D spatial reasoning”这一关键词可以推断,评测可能涉及:从二维草图推断三维结构、判断物体间的空间关系、以及根据描述生成或修改草图等方向。这些任务共同指向一个目标——区分“看起来懂”和“真的懂”。
空间推理基准的常见评测范式
在3D空间推理基准中,任务设计通常围绕几个经典范式展开。其一是心理旋转任务(mental rotation),即判断一个三维物体旋转后与哪个选项匹配,考验模型对几何变换的心象操作能力。其二是空间关系判断,要求模型回答“A在B的左侧/上方/后方”这类方位问题,常涉及参考系的选择与转换。其三是遮挡与可见性推理,即从特定视角判断哪些部分可见、哪些被遮挡,这需要模型构建视角依赖的场景表征。其四是从二维到三维的映射,例如从多视图草图或单张线稿推断物体的三维结构。这些范式共同构成了空间认知能力的多维度评估框架,也解释了为何草图适合作为测试媒介——草图天然携带视角与比例信息,能够以低成本激发上述各类推理。
对AI研究社区的意义
空间推理是具身智能、机器人导航、三维内容生成等应用的基础能力。一个专注于此的基准,有助于研究者横向比较不同模型,也能推动模型在空间理解上的针对性改进。
Hacker News 上的讨论虽然热度尚在早期(Points: 5),但这类基准的出现本身释放了信号:社区开始重视 LLM 在非语言维度上的能力评测。
具身智能与空间推理的关系
具身智能(embodied AI)强调智能体通过与物理环境的交互来学习和决策,其核心挑战之一就是空间理解。机器人需要在三维空间中定位自身、规划路径、估计物体距离与可操作性,这些能力都建立在稳健的空间推理之上。当前主流的大语言模型本质上是符号与文本模式的处理器,缺乏对物理空间的直接感知与操作经验。因此,用基准测试来量化LLM在空间任务上的表现,实际上是在探测“语言智能”向“具身智能”迁移的可行性边界。如果模型仅靠语言先验就能在草图上做出正确的空间判断,说明其内部可能形成了某种可迁移的空间表征;反之,则提示需要引入专门的3D感知模块或多模态训练。这类基准因此成为连接纯语言模型研究与具身应用之间的重要诊断工具。
局限与待观察之处
目前公开信息有限,基准的具体任务数量、评分标准、参与评测的模型列表等细节尚未披露。这意味着对其结论的解读需要保持谨慎。后续值得关注的点包括:任务是否覆盖不同难度的空间关系、评测结果是否与真实应用表现相关、以及基准是否开源可复现。
基准评测的可复现性与效度问题
对于一个新发布的基准,除了任务数量与评分标准,还需关注两个方法论层面的问题。其一是可复现性:基准是否开源、评测脚本是否公开、随机种子与数据划分是否明确,这些决定了其他研究者能否独立验证结论。其二是构念效度(construct validity):基准测出的分数是否真的对应“三维空间推理”这一目标能力,而非模型对任务格式或语言线索的过拟合。例如,若草图的文字描述本身已包含足够信息,模型可能绕过视觉空间推理而仅靠语言推理得分。此外,基准与真实应用表现之间的相关性也需要通过下游任务(如机器人导航成功率)来交叉验证。在细节披露之前,对任何单一基准的结论都应保持审慎态度。
结语
SketchAgentBench 把“草图”作为探针,切入 LLM 三维空间推理这一相对空白的评测领域。它的价值不在于给出最终答案,而在于提出一个值得跟进的问题:语言模型离真正的空间智能还有多远。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。