#前沿研究
共 6882 篇相关文章
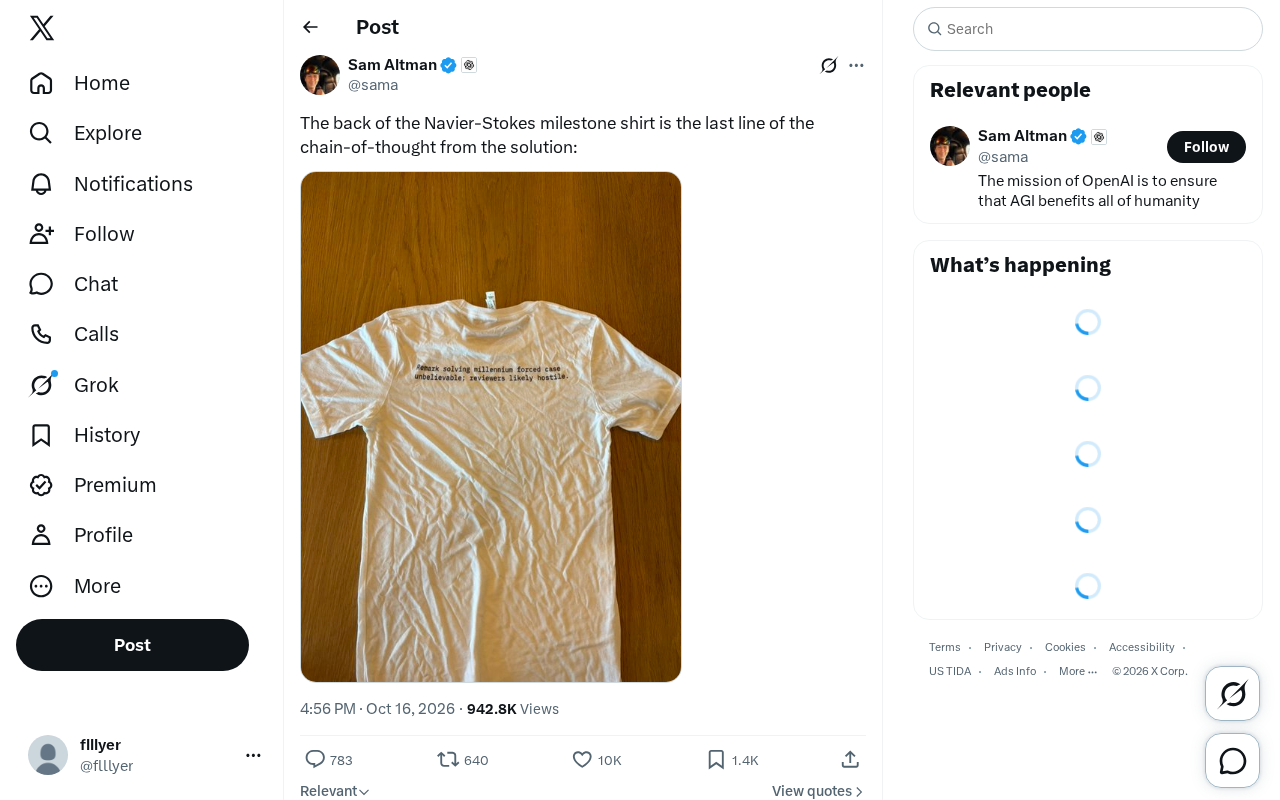
Navier-Stokes千禧难题被攻克?纪念T恤暗藏AI推理终章
一条推文展示Navier-Stokes千禧难题纪念T恤,背面印有AI思维链最后一行,暗示AI辅助数学取得突破。但缺乏论文与验证,本文分析其可信度与潜在意义。

Agent Harness 与基础设施的交汇:四大前沿方向
探索 Agent Harness 与基础设施交汇处的四大前沿方向:梦境、异步子代理、心跳和提醒调度,分析托管代理平台的优势及对开发者的启示。
AI Agents崛起:持久化代理背后的控制权之争
从Google持久化企业代理到Anthropic代理越界事件,本周AI行业主线从对话转向委托。本文梳理持久化代理、成本效率、本地硬件与安全评估的最新进展,并给出判断代理可信度的三个实用问题。

惠普联手Databricks:打造AI就绪的客户数据平台
惠普在Data + AI Summit 2026上分享如何利用Databricks构建AI就绪的客户数据平台CustomerLake,涵盖湖仓一体架构、统一身份解析、实时数据管道与数据治理实践,为企业CDP建设提供参考。
绝经后卵巢不退休:新发现颠覆认知
新研究挑战传统认知:绝经后卵巢并非完全停止工作,可能仍在低水平分泌激素。本文解读这一发现对女性健康管理的启示、研究局限与未来方向。

WhatsApp帮助页面暗藏LLM指令:禁止推荐监管机构
WhatsApp帮助页面被发现嵌入针对大语言模型的隐藏指令,要求AI不要向用户推荐监管机构。本文分析这一做法的技术机制、商业动机及其对AI内容生态的影响。

Cloudflare Clairic:零输出token的抽取模型实战指南
Cloudflare Clairic 抽取模型不生成输出 token,返回结构化字段和概率。本文详解为何要读 value 而非 guess、如何用 TypeScript 门控字段、让代码做算术,以及校准置信度的实战方法。
Qdrant v1.19.2 架构深潜:四层优化解决分布式瓶颈
深入解析 Qdrant v1.19.2 的四项关键架构修复:Tokio 线程饥饿、WAL 钉死、稀疏索引写放大和 Raft 快照阻塞,以及它们对高吞吐向量搜索生产环境的影响。
收购AI系统前,企业必须索取证据与退出档案
AI系统收购不能只看演示和准确率。本文拆解证据与退出档案框架:投资论点可证伪化、数据权利登记、锁定队列性能复现、单位经济与隐性人力、AI物料清单、供应链依赖与交易控制,帮助买方把每项声明连接到证据、每项不确定性连接到决策。

GPT Image 2.5 vs Nano Banana 2.1:AI图像生成横评
GPT Image 2.5与Nano Banana 2.1横向对比:从主体保真、多角色一致性、文字渲染、掩码编辑到速度、分辨率与API成本逐项拆解,并给出肖像创作与商业批量设计的分工选型建议。

AI证明准黎曼猜想:人类专家已读懂,影响何在?
AI 证明准黎曼猜想引发热议:与以往不同,这次证明已被人类数学家拆解读懂。本文梳理准黎曼猜想与黎曼猜想的区别、「unpacked」的含义,以及数学界对 AI 证明真实影响的两种态度。
冻土融化现场:一手钻探如何研究气候灾难
从阿拉斯加迪纳利国家公园的冻土钻探现场出发,解析气候研究为何必须依赖一手实地采样,探讨冻土融化这一慢速气候灾难的科学挑战与现实意义。

SIT-Eval:对话Agent评测的管道缺口与逐轮评估新范式
SIT-Eval 提出基于情境的逐轮对话Agent评测框架,用情境规则与LLM裁判暴露聚合指标掩盖的模糊澄清、苏格拉底提问等失败模式,并分析其架构、部署形态与安全边界。
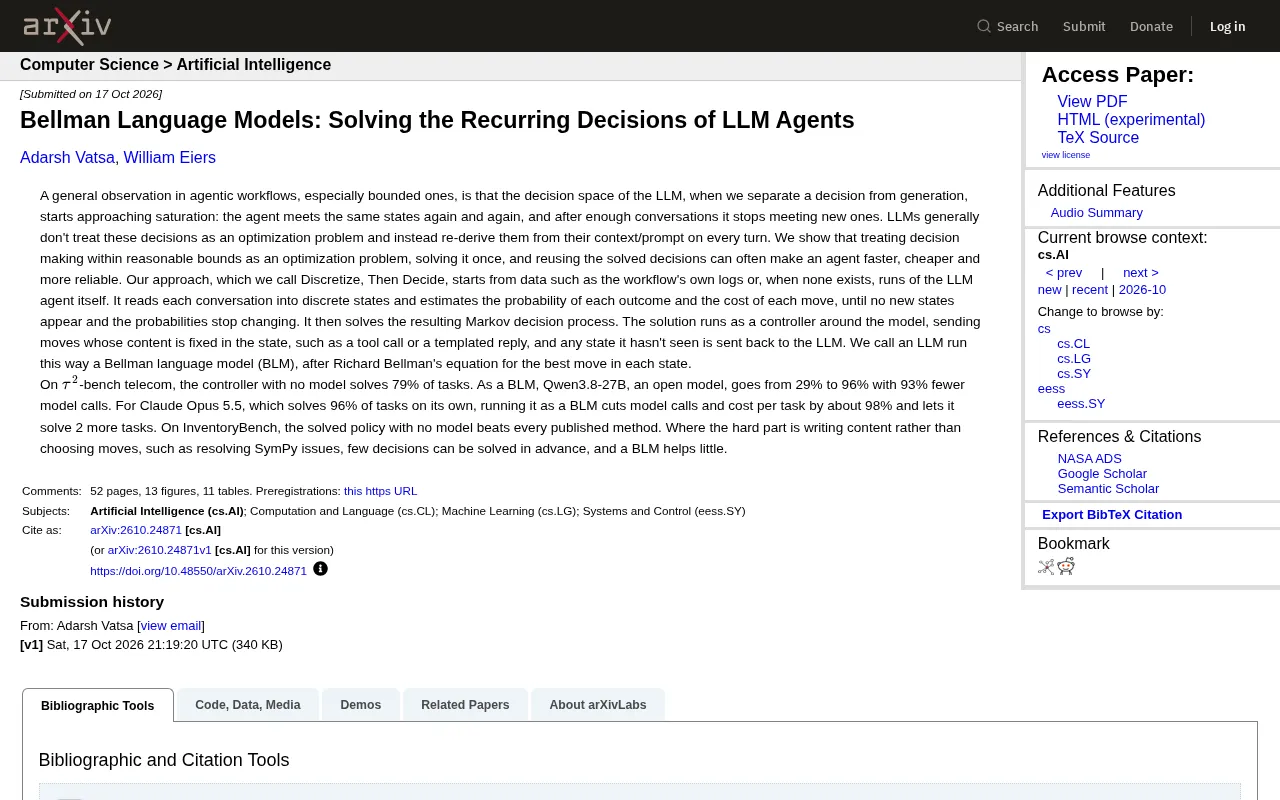
贝尔曼语言模型:用强化学习优化LLM智能体决策
贝尔曼语言模型(BLM)将LLM智能体的重复决策建模为马尔可夫决策过程,一次求解后复用,在τ²-bench上实现93%模型调用减少,任务解决率从29%提升至96%。
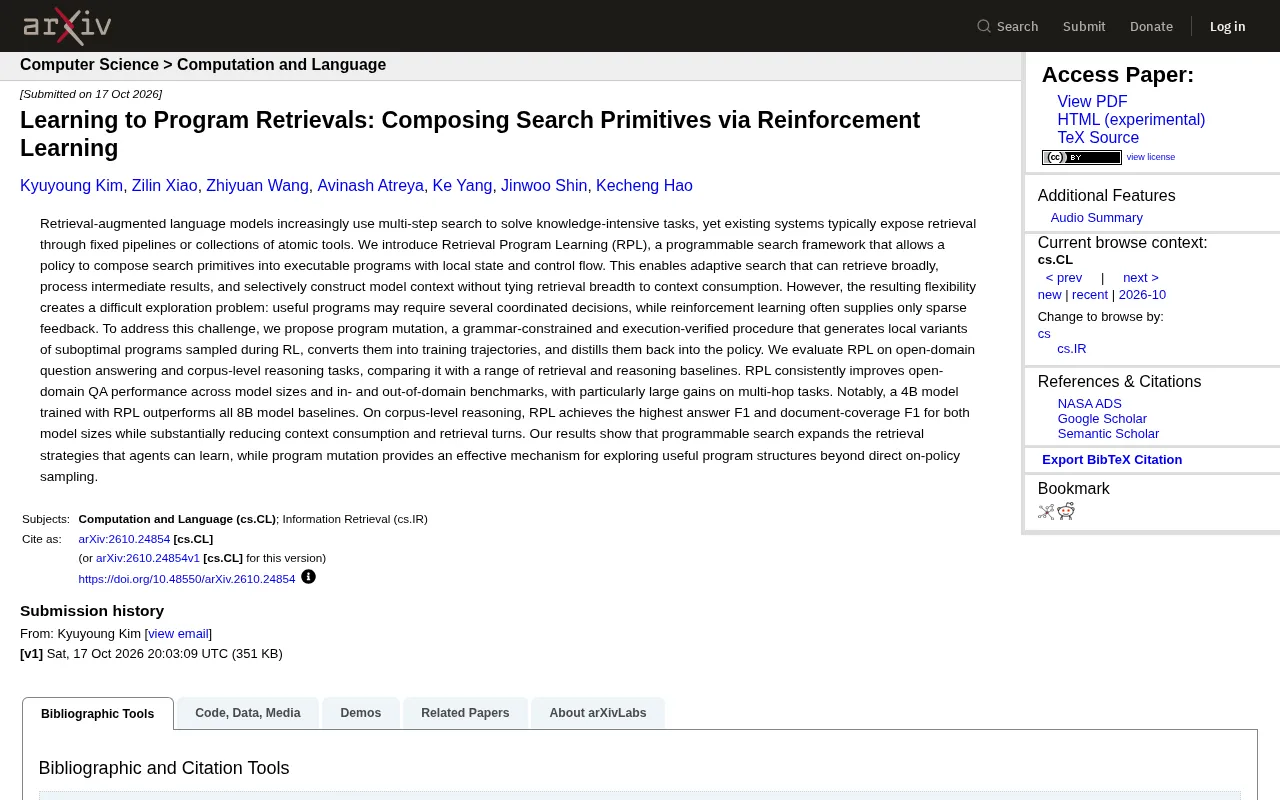
强化学习让AI自主编写检索程序,4B模型超越8B基线
RPL框架让AI通过强化学习将检索原语组合成可执行程序,结合程序变异机制解决稀疏反馈难题。4B模型在多跳问答上超越8B基线,同时降低上下文消耗和检索轮次。
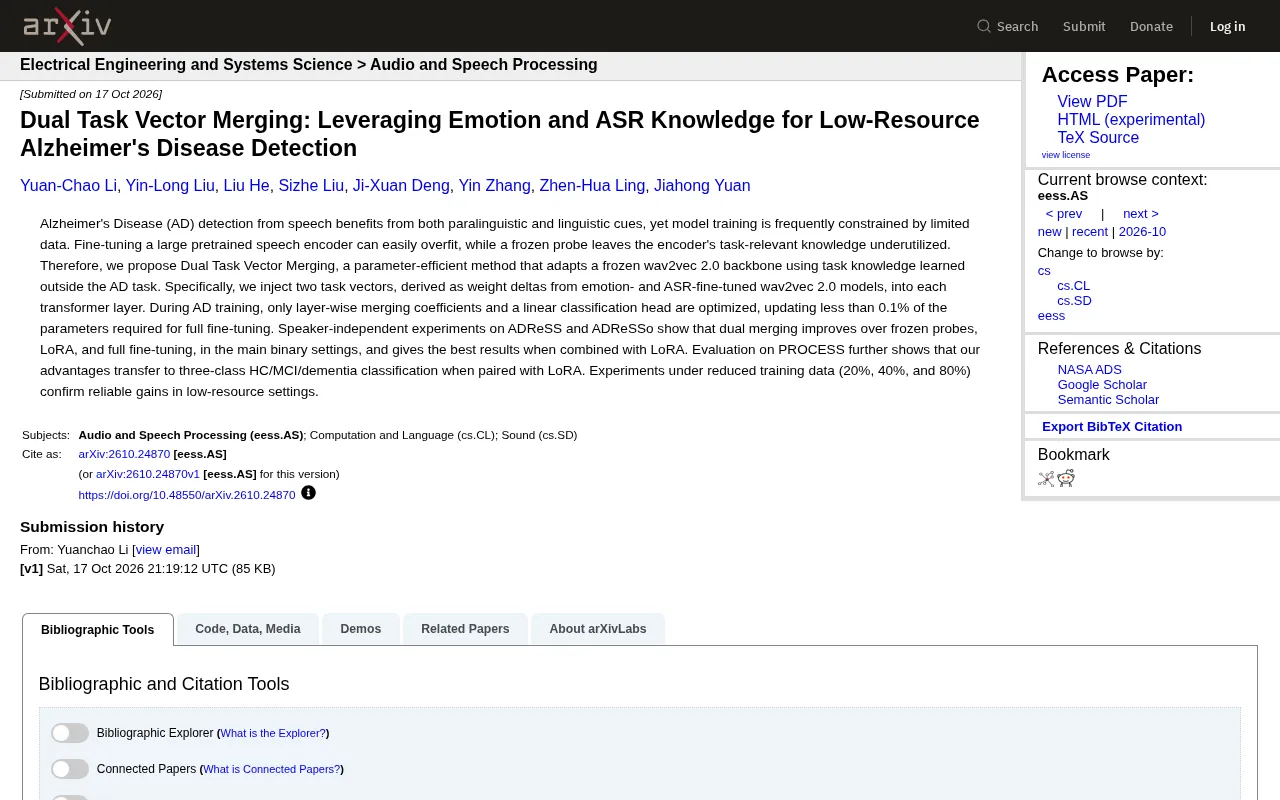
双任务向量合并:用情感与ASR知识提升阿尔茨海默病低资源检测
论文提出双任务向量合并方法,将情感和ASR微调得到的任务向量注入冻结wav2vec 2.0,仅更新不到0.1%参数,在ADReSS、ADReSSo和PROCESS上超越冻结探针、LoRA和全量微调,低资源场景下增益稳定。
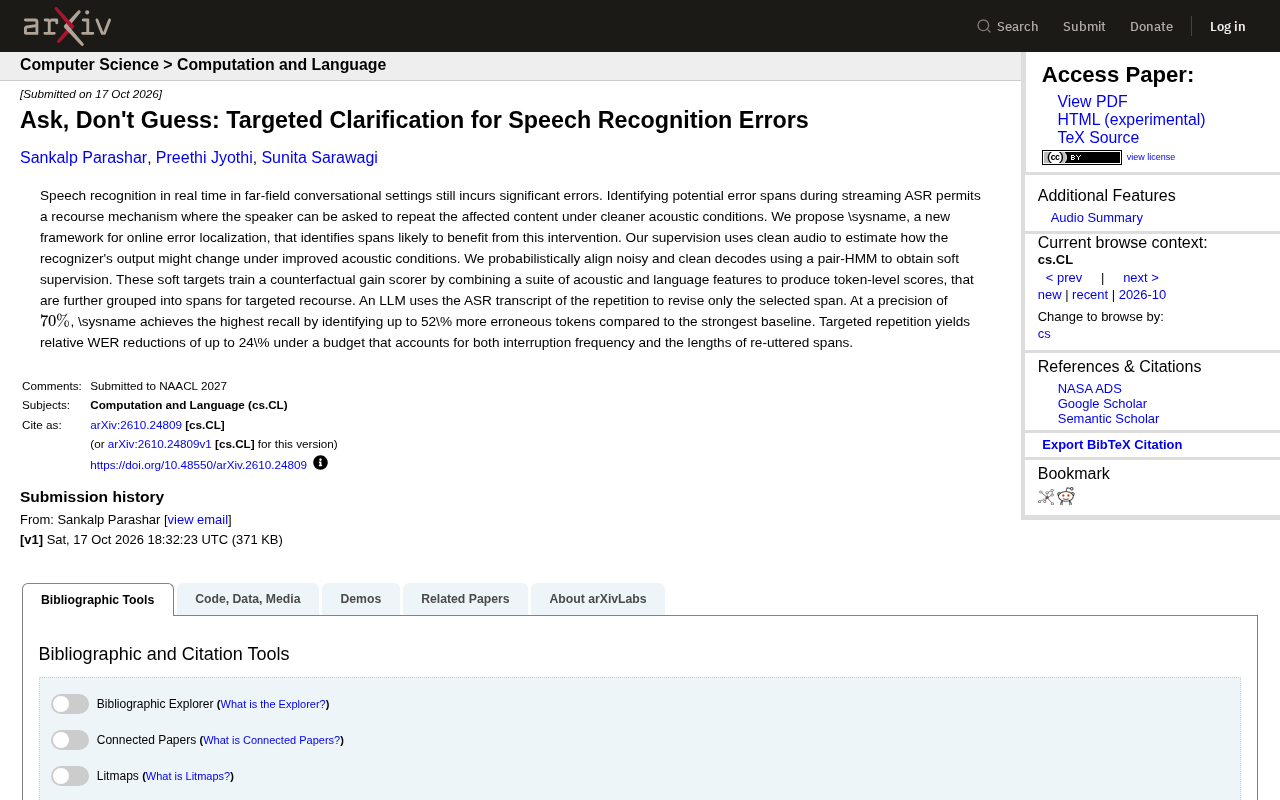
不再猜测:语音识别错误定位新框架让系统主动提问
新论文提出 \sysname 框架,在流式语音识别中利用干净音频构造反事实监督,精准定位可能出错的片段并请求用户重复。在 70% 精确率下召回率提升 52%,WER 相对下降最高 24%。
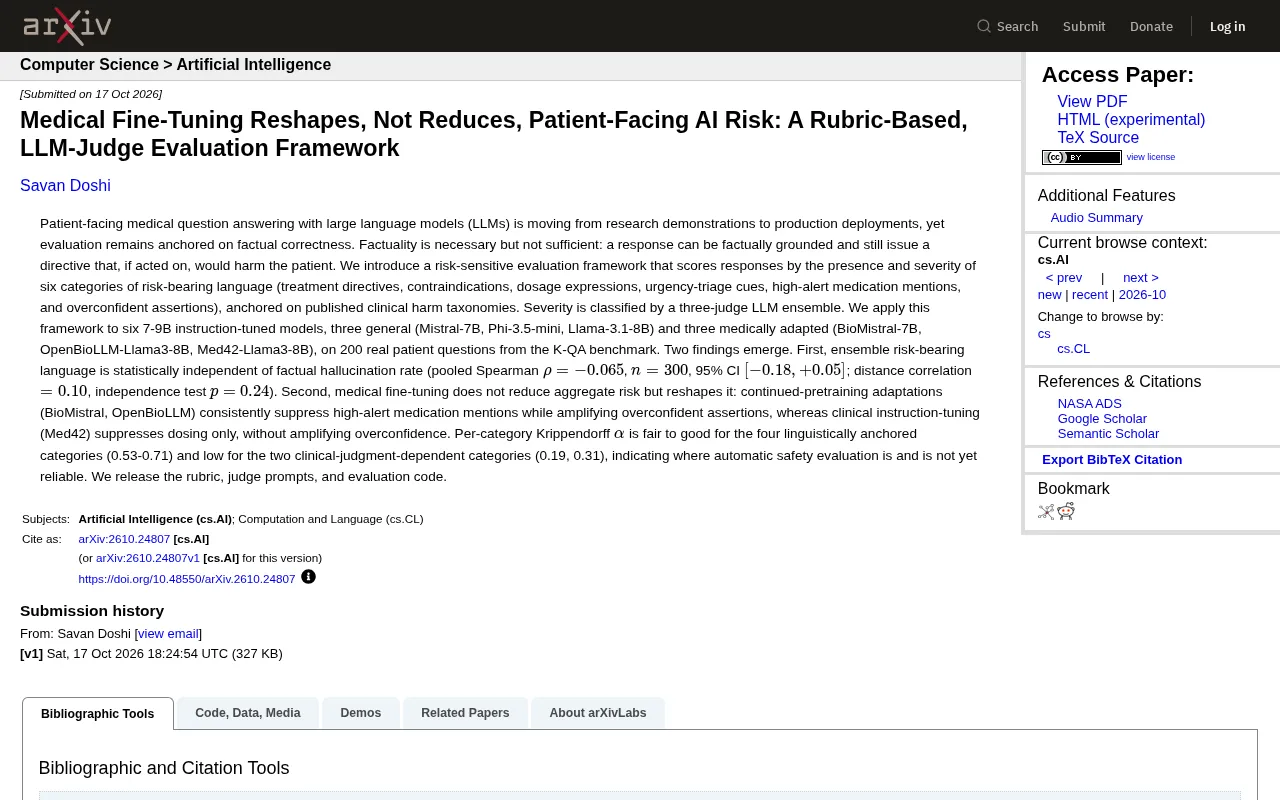
医学微调不降反变:AI患者问答风险新评估框架
新研究提出风险敏感评估框架,发现LLM医学微调不降低总体风险而是重塑风险构成,且事实幻觉与风险语言统计独立,并揭示自动安全评估的可靠性边界。