#前沿研究
共 6890 篇相关文章

SIT-Eval:对话Agent评测的管道缺口与逐轮评估新范式
SIT-Eval 提出基于情境的逐轮对话Agent评测框架,用情境规则与LLM裁判暴露聚合指标掩盖的模糊澄清、苏格拉底提问等失败模式,并分析其架构、部署形态与安全边界。
贝尔曼语言模型:用强化学习优化LLM智能体决策
贝尔曼语言模型(BLM)将LLM智能体的重复决策建模为马尔可夫决策过程,一次求解后复用,在τ²-bench上实现93%模型调用减少,任务解决率从29%提升至96%。
强化学习让AI自主编写检索程序,4B模型超越8B基线
RPL框架让AI通过强化学习将检索原语组合成可执行程序,结合程序变异机制解决稀疏反馈难题。4B模型在多跳问答上超越8B基线,同时降低上下文消耗和检索轮次。
双任务向量合并:用情感与ASR知识提升阿尔茨海默病低资源检测
论文提出双任务向量合并方法,将情感和ASR微调得到的任务向量注入冻结wav2vec 2.0,仅更新不到0.1%参数,在ADReSS、ADReSSo和PROCESS上超越冻结探针、LoRA和全量微调,低资源场景下增益稳定。
不再猜测:语音识别错误定位新框架让系统主动提问
新论文提出 \sysname 框架,在流式语音识别中利用干净音频构造反事实监督,精准定位可能出错的片段并请求用户重复。在 70% 精确率下召回率提升 52%,WER 相对下降最高 24%。
医学微调不降反变:AI患者问答风险新评估框架
新研究提出风险敏感评估框架,发现LLM医学微调不降低总体风险而是重塑风险构成,且事实幻觉与风险语言统计独立,并揭示自动安全评估的可靠性边界。
目标图像是控制指令:空间接地目标图像合成如何重塑机器人操作
论文揭示目标图像编辑质量与机器人策略成功率脱钩:操作依从性才是关键。SGE-Goal 通过空间接地分解编辑,让开源基座模型在 CALVIN 上超越闭源编辑器,长程任务成功率提升约七倍。
SpriteStage:渐进式场景编程实现长时动画生成
SpriteStage 提出渐进式场景编程框架,通过迭代演出、引擎重编排与冻结回放,解决长动画生成中的跨场景一致性问题,并成功生成约10-14分钟的完整动画。
让代码智能体学会提问却不泄露私有代码
研究提出效用验证抽象(UVA)方法,训练本地代码智能体在向云端模型提问时,用角色和类型描述私有实体,避免泄露源代码。实验显示问题解决率从25.3%提升至37.6%,私有实体披露减少3.7倍。

Pair-Aware优化:混合策略提升LLM智能体越狱攻击效果
研究提出Pair-Aware优化框架,系统比较一阶与零阶越狱攻击方法的组合效果,发现混合优化策略显著提升LLM智能体攻击成功率,优化顺序影响显著,并引入随机解码评估视角。
VTF900:900人可见光-热红外人脸识别基准发布
VTF900是包含900名受试者的可见光-热红外人脸识别数据集与基准,支持1:1验证与1:N识别的大规模评测。基准显示小规模高AUC无法转化为部署性能,ViT-B在正面条件达97.68%AUC,域自适应方法在非正面姿态更稳健。
SwitchSplat:从随手拍视频中学习物体离散状态,3DGS终于能"开关"了
SwitchSplat提出基座+槽位分解的3DGS表示,从随手拍摄视频中学习物体离散状态(开/关),支持推理时自由组合状态并渲染新视角,优于静态与动态基线。
Devin 提交 Cognition 89% 代码,公司年化收入达 10 亿美元
Cognition 的 Devin 代理已提交公司 89% 的代码,年化收入达 10 亿美元、估值 480 亿美元。本期还覆盖 Exa 3.0 搜索 API、Inception Mercury 3 扩散模型、企业 Agent 治理难题及本地部署硬件选型。

嵌入多样性度量基准EmbDivBench:图熵最优
论文提出21种嵌入多样性度量的分类体系和基准EmbDivBench,从多样性、平衡性、差异性三维度评估,发现图熵整体最优,平均成对距离并非最佳选择。

一句话攻破LLM智能体:隐式推理关系成认知攻击面
新研究提出单关系攻击ORA,通过一句话限定LLM智能体的隐式推理担保,在生物医学推断和漏洞检测中平均翻转54.9%专有模型与80.0%开放模型的正确回答,揭示隐式担保成为认知攻击面。

LLM评分器吞掉合规类:越狱成功率可差22倍
固定模型与提示词、只更换LLM评分器,越狱合规率可相差22至25倍。研究发现多个8B/9B评分器将合规响应坍缩进规避类,并提出零成本诊断方法与报告最低要求。
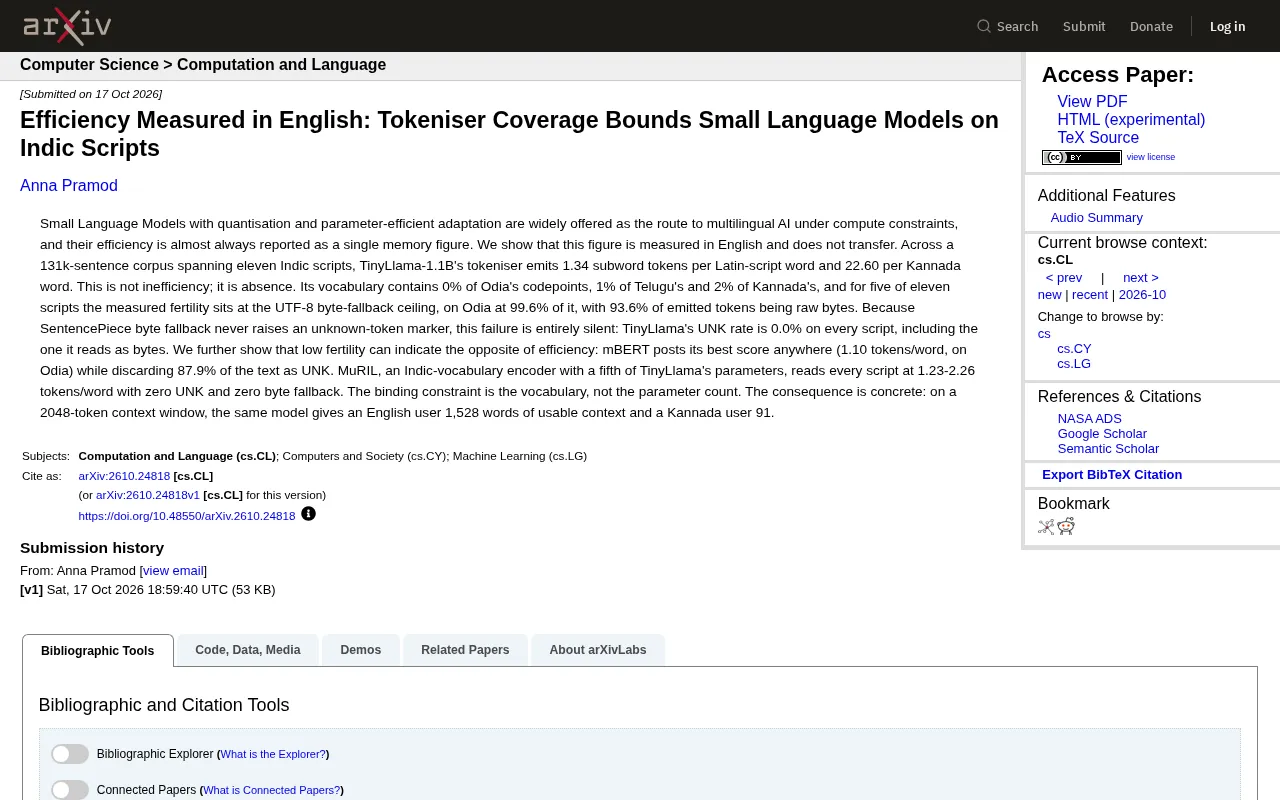
Tokeniser覆盖率:小语言模型在多语言场景下的隐形天花板
一项针对11种印度文字的研究揭示,小语言模型的效率度量以英语为中心,词汇表覆盖率而非参数量才是多语言场景的根本约束。TinyLlama在卡纳达语上每个单词产生22.6个token,上下文窗口缩水至91词。
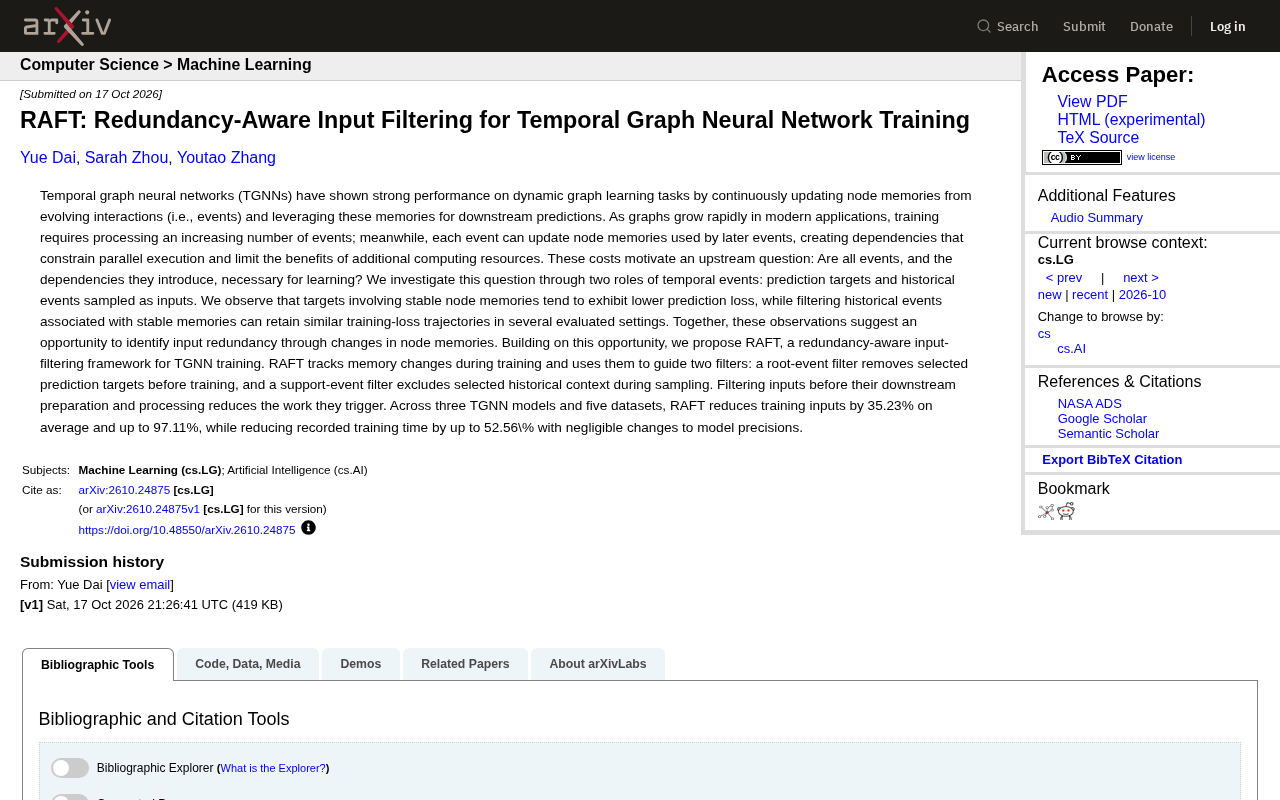
RAFT:冗余感知输入过滤加速时序图神经网络训练
RAFT框架通过冗余感知输入过滤,平均减少35.23%训练输入,训练时间最多降低52.56%,精度几乎无损,为时序图神经网络训练加速提供新方案。