#前沿研究
共 8764 篇相关文章

Google发布Gemini 4 Carbon:网络安全能力显著跃升
Google发布前沿模型Gemini 4 Carbon,官方称在编程、智能体任务与网络安全方面实现显著提升,并在Artificial Analysis Intelligence Index v5.0基准上登顶,Claude Opus 5.5与GPT-6 Astra紧随其后。

UEFI固件曝代码执行漏洞,波及全球多数服务器
Ars Technica报道UEFI固件存在代码执行漏洞,影响全球大多数服务器。本文解析固件层漏洞为何难以修复、服务器同质化带来的系统性风险,以及运维团队应如何把固件纳入安全基线管理。
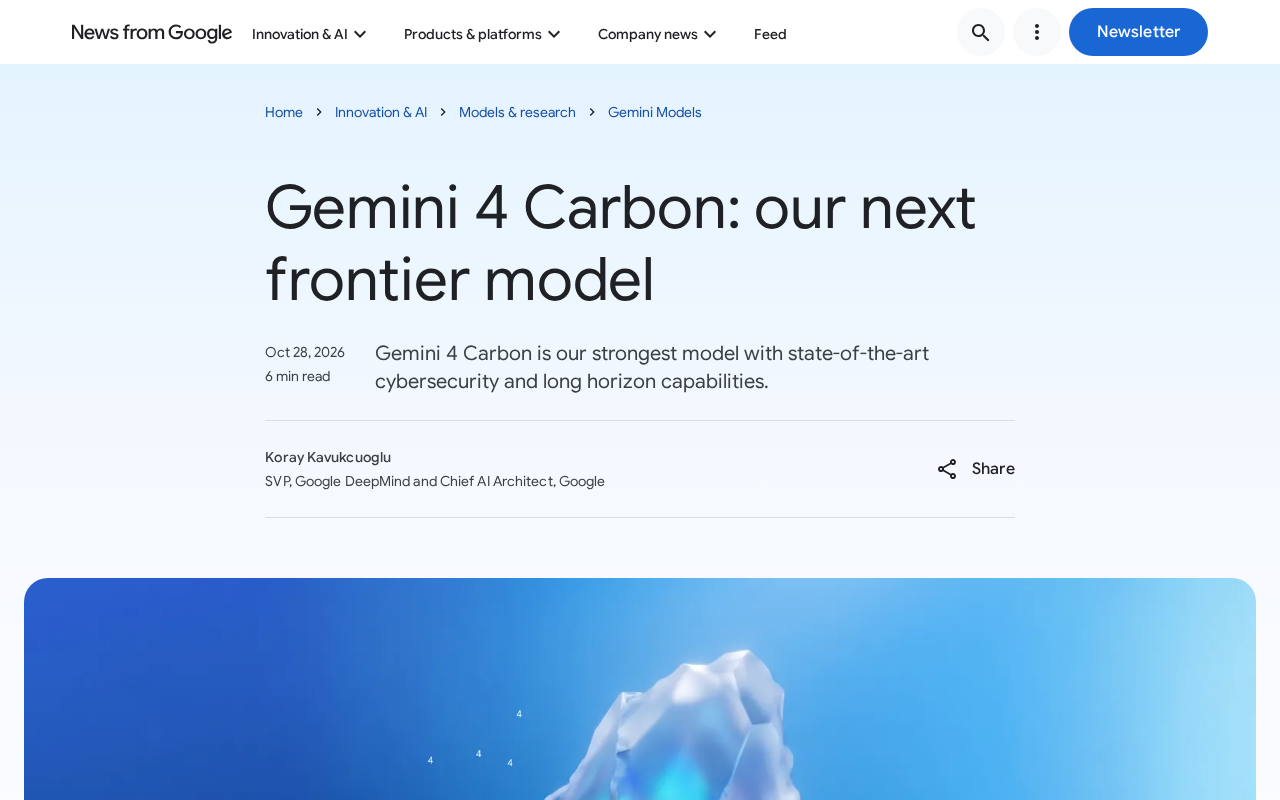
Gemini 4 Carbon 发布:谷歌新模型引发热议
谷歌发布 Gemini 4 Carbon 新模型,Hacker News 相关讨论获 467 分、394 条评论。本文梳理事件热度与社区反应,并提醒读者以官方博客原文为准,理性看待新模型发布。

苹果发布PROLED XDR屏MacBook Pro,触控来了
苹果发布搭载PROLED XDR显示屏并支持触控的MacBook Pro,Hacker News引发289点、457条评论热议。本文分析屏幕升级、触控交互变化及对专业用户的实际影响。

Oseberg Tapestry Fragments:数字复原维京织物
从Hacker News上一条关于Oseberg Tapestry Fragments的帖子出发,探讨维京织物碎片的数字化保存、多光谱成像与开放数据协作,分析文化遗产技术对开发者的启示。

Sleep框架:让大模型在持续学习中不忘本的睡眠机制
Sleep框架提出借鉴生物睡眠机制,让大模型在持续学习中巩固旧知识、缓解灾难性遗忘。本文解读其设计理念、与经验回放方法的关联及对AI应用开发的启示。

探索新加坡AI创作生态:技术如何激发创意灵感
探索新加坡如何成为AI创意热土,AI工具如何激发创作者灵感,以及新加坡的AI基础设施与政策支持。
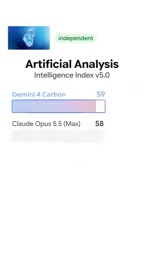
Gemini 4 Carbon发布:登顶智能指数,网络安全能力成亮点
Google发布Gemini 4 Carbon,登顶Artificial Analysis智能指数,覆盖从漏洞发现到补丁编写的网络安全防御工作流,Terminal Bench作弊率归零,Agent单任务成本低约72%,目前通过Fairwind计划优先供应网络安全防御者。
AI“邪恶神经元”被发现:激活它,模型就变坏?
Reddit 热议的 AI“邪恶神经元”是什么?本文解析神经元级操控研究,探讨激活有害神经元的风险与安全对齐挑战,理性看待模型内部的可解释性发现。
GRPO值函数近似:能否偏离均值?
Reddit社区讨论GRPO中值函数近似偏离组内均值的可能性,探讨数据规模、任务类型和模型规模对基线选择的影响,指出当前文献空白与潜在实验方向。

Wiz CTO警示:PHP2Shell漏洞或引爆“漏洞末日”
Wiz CTO针对PHP2Shell漏洞发出警告,认为其影响约70%网站的严重漏洞事件预示“漏洞末日”到来,企业需从被动修复转向安全韧性建设。

Wiz CTO警告:互联网老旧代码迎来“漏洞末日”
Wiz CTO警告互联网老旧代码正走向“漏洞末日”。PHP两个高危漏洞影响约70%网站、部分站点下线修复,暴露开源依赖集中与维护不足的结构性风险,企业需盘点老旧依赖并准备应急方案。

谷歌Xreal Aura眼镜发布:95克轻量设计,售价1099美元
谷歌与Xreal联合推出的Android XR眼镜Aura正式开售,售价1099美元,重量仅95克,采用分体式计算模块设计,支持多块虚拟屏幕,以轻量化和低于预期的定价切入XR市场。

新款MacBook Pro开启预售:OLED触控屏与发光Logo回归
苹果新款14英寸和16英寸MacBook Pro正式开启预售,搭载串联OLED显示屏并首次支持完整触控,机身减重且发光苹果Logo回归。本文梳理核心升级点、产品线变化与购买建议。

FCC拟允许监狱屏蔽手机信号,安全与通信权之争再起
FCC主席Brendan Carr宣布将于11月19日投票,拟允许监狱使用手机信号干扰器。本文分析这一政策转向的背景、技术挑战及安全与通信权利的平衡难题。
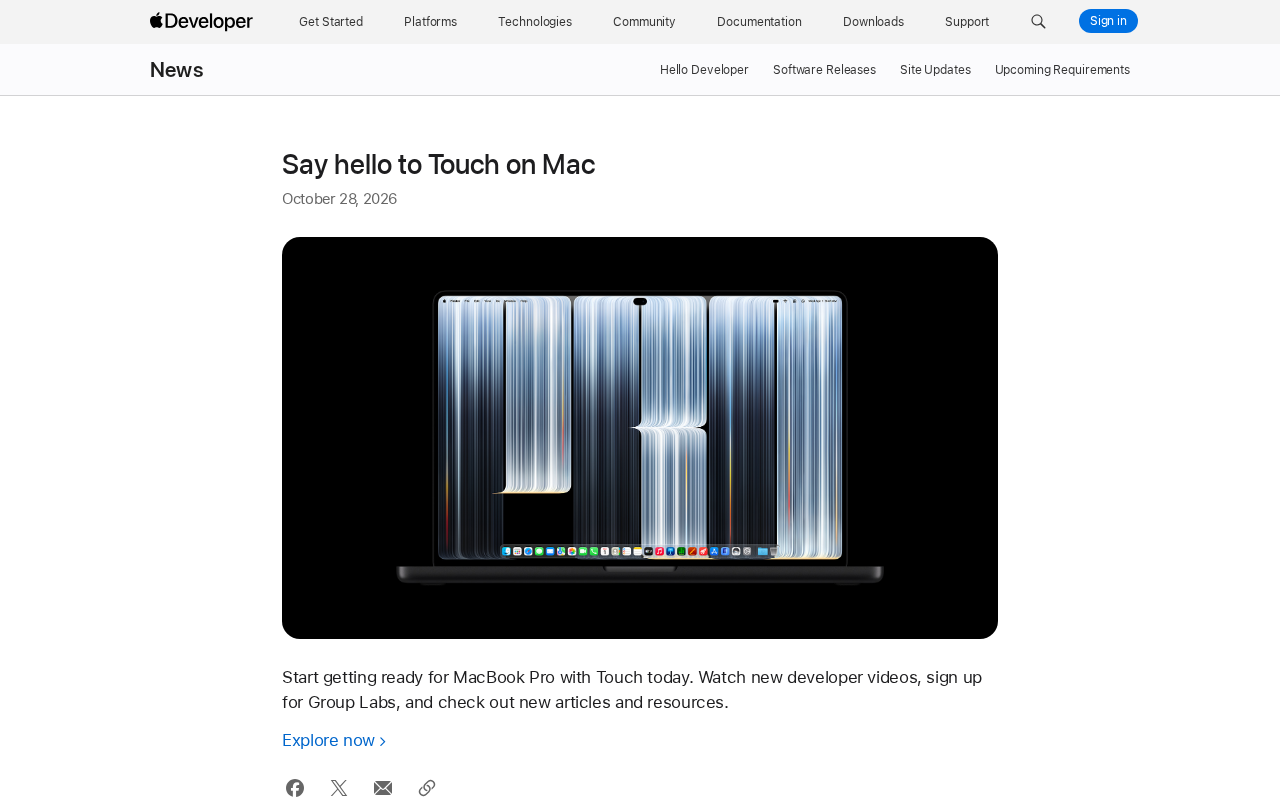
苹果Touch登陆Mac:开发者需提前准备的新交互
苹果开发者官网发布「Say hello to Touch on Mac」公告,呼吁开发者为MacBook Pro的Touch交互提前准备,提供开发者视频、Group Labs和文档资源。本文解读公告信号、适配要点与开发者的行动建议。

用了一周Xreal Aura,我改变了对AR的看法
Xreal Aura上手体验:分体式设计、Android XR生态与Gemini集成如何让AR眼镜真正可用。从游戏、地图到办公场景,分析这款空间计算设备的实际表现与局限。
哪个AI模型废话最多?我做了个"废话基准"实测
有人自建 Neural Yap 基准,从话术短语、排版符号、格式结构和回答长度四个维度量化AI模型的"废话程度"。结果显示GPT系列最简洁,Claude Opus 5.5最爱长篇大论,但真正决定体感的不是模型本身,而是使用框架与系统指令的服从度。