#本地部署
共 414 篇相关文章
英伟达发布Nemotron 3.5 Bolt:74B参数塞进24GB显存的本地VLM
英伟达发布 Nemotron 3.5 Bolt 74B-A9B 视觉语言模型,用原生 2-bit 量化将 74B 参数压进 24GB 显存,支持 256K 上下文与本地 agentic 任务,附 vLLM 部署与投机解码细节。
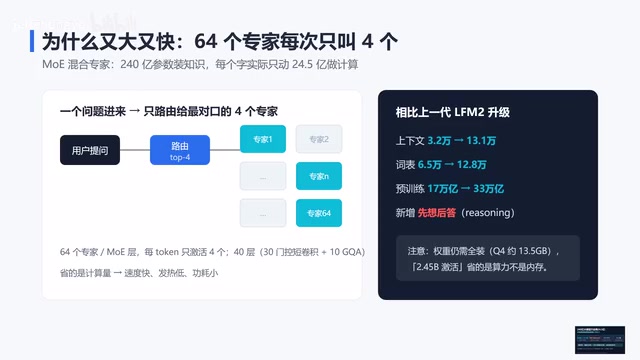
240亿只动24.5亿:32G笔记本本地跑AI智能体,快1.7倍还开源
议会开源模型2.5-24总参数240亿、每字仅激活24.5亿,靠混合专家架构让32G内存笔记本本地跑AI智能体,自动化跑分领先第二名3.2倍,权重免费开源、数据不出本机。

代码算事实、模型做解释:本地LLM处理瑞士行政信
一个本地LLM工具用正则和代码计算瑞士行政信件的法定期限,让模型只负责语言解释,不产出关键事实。本文拆解其设计原则、测试边界与尚未完成的部分。
Character.ai破产了?六周内导出聊天记录的自救指南
Character.ai申请Chapter 11破产,迪士尼出价2000万美元仅购部分IP授权,消费者应用前途未卜。本文提供官方数据导出与CAI Tools两种方案,并附SillyTavern+Ollama本地重建角色的完整步骤。
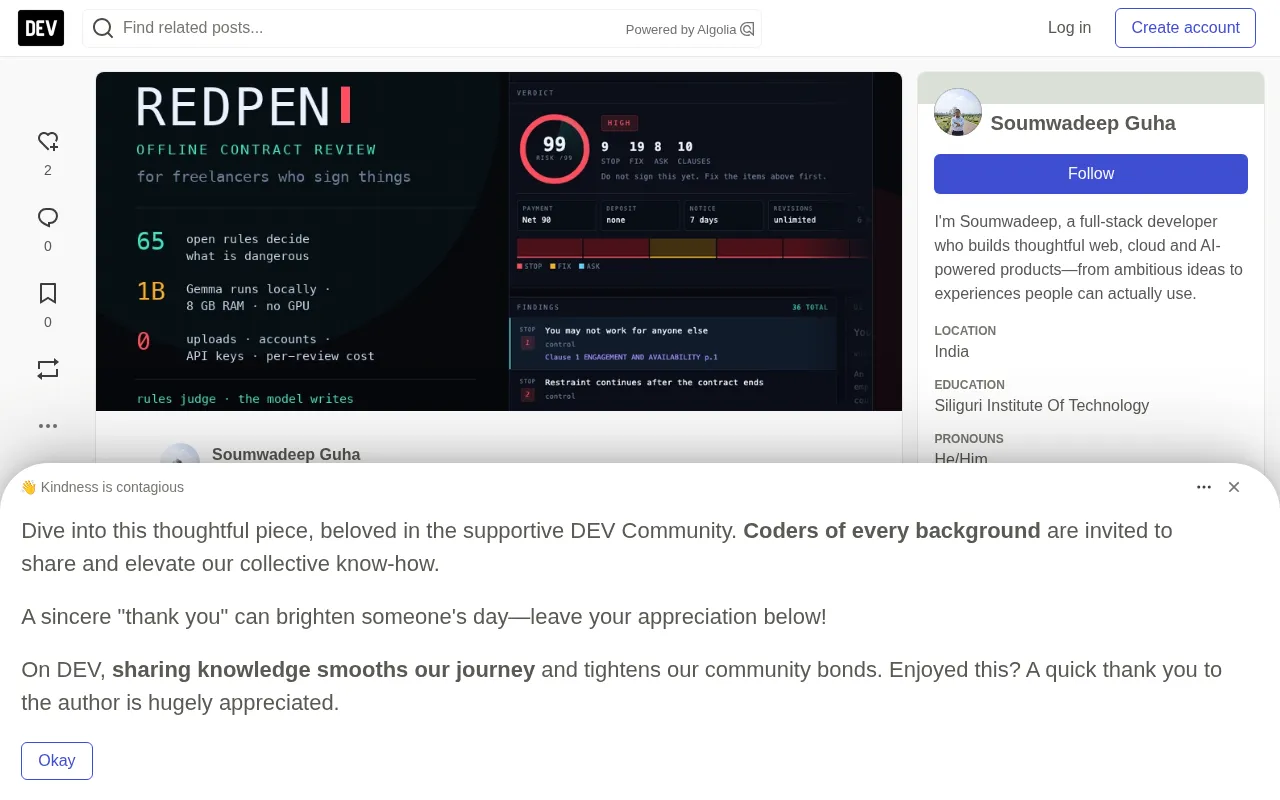
1B小模型读不了合同?RedPen用规则引擎+小模型重构合同审查
RedPen 是一款离线合同审查工具,用 65 条开源规则判断风险、本地 Gemma 3 1B 模型只负责措辞输出。模型从不判断条款危险性,8GB 内存即可运行,客户 NDA 永不离开笔记本。

Jira 单项目接入本地 LLM:LM Studio 实战踩坑
实测 Jira 单项目接入本地 LLM:用 CogniRunner + LM Studio + Tailscale 让某个项目走本地 qwen 模型,其他项目保持云端。16 次测试全部正确,但错误 token 会导致 fail-open 静默放行,日志留存与隐私边界同样值得关注。
Spark X2.5 下载突破200万,X2.6 即将开源
开源模型 Spark X2.5 累计下载突破200万次,官方渠道与社区衍生构建各贡献约一半,Spark-X2.6-4B 与 1.7B 即将开源。

ZY-S1 Preview发布:1.18B参数小模型探索本地化AI
ZYR AI发布实验性语言模型ZY-S1 Preview,参数约1.18B,基于HRM-Text-1B,聚焦编程、推理与本地可运行的小模型方向,探索无需昂贵订阅的实用AI方案。
Realist:开源商品列表审计工具,帮卖家提前发现描述矛盾
Realist是一款开源商品列表审计工具,用Python精确比对加本地视觉模型观察,帮eBay、Etsy卖家提前发现标题、规格与照片之间的矛盾,降低退货和差评风险。
Mac本地无审查AI:按内存选模型指南
Mac本地无审查AI模型选择指南:按统一内存大小匹配Llama、Qwen、Gemma等abliterated模型,16GB至48GB各档位推荐及安装步骤。
零成本本地发票分类:开源AI离线方案实操
自由职业者如何用开源AI在本地搭建零成本发票分类器?本文解析一个完全离线的Python方案,不调用云端API、不上传财务数据,自动将发票和收据解析为结构化JSON,兼顾隐私与零订阅费用。
本地部署法国AI:如何选择Ministral模型
Mistral AI以Apache 2.0发布Ministral 3系列权重,本文梳理3B与8B版本的选择逻辑、内存估算方法、法语能力与开发者国籍的区分,以及三个可复用的模型对比测试方案。

不想再拼凑本地RAG栈,我做了个100%离线企业级RAG脚手架
开发者将Ollama、FastAPI、LangChain与React整合为100%离线企业级RAG脚手架VaultRAG,解决本地RAG全栈搭建耗时问题,并分享Docker网络与分块调参的实战经验。

144.3M本地决策模型 vs 托管API:审批门选型指南
以 Phocinae-Largha-150M 为例,用三个问题判断审批门该选本地决策模型还是托管 API,附真实准确率、延迟数据和置信度升级门设计。
Mac mini本地AI实战:Ollama+Hermes Agent搭建个人智能系统
在Mac mini上用Ollama运行千问3.6-35B-A3B模型,配合Hermes Agent搭建本地AI自动化系统。详解MoE架构、内存需求、模型选型与分阶段落地方法。
REA开源工具:让AI自动逆向工程任意App
REA是一个开源逆向工程工具,将AI助手连接到真实逆向引擎,本地分析可执行文件并快速重建功能。告别通用AI胡编答案,几分钟看懂任何App的实现原理。
MoE大模型超内存运行实战:llama.cpp专家卸载与SSD流式加载
基于llama.cpp的MoE大模型超内存运行实战指南:通过mmap、--n-cpu-moe专家卸载和SSD流式加载,在有限硬件上运行100B+参数模型,包含内存估算脚本、配置参数与瓶颈诊断方法。
VQ Agent Core 三层 Agent 循环解析:让智能体可审计
VQ Agent Core 通过 THINK→ACT→DECIDE→THINK 三层循环拆分 Agent 职责,支持 Needle 2 语法约束路由、四种可插拔决策后端(Jev/Strands 2B/Laya/提示词 LLM)及完整 JSONL 审计轨迹,本地与云端可无缝切换。