#模型评估
共 32 篇相关文章

AI模型何时该说"我不知道"?一个Kaggle升级基准的实测结论
一个为期11天的Kaggle升级基准测试揭示:评估AI模型应看最差形态而非平均值。本地小模型会做题却不知自己不会,虚假自信率高达100%。本文解析该基准的设计、发现与工程落地方案。

谁来校准做决策的人?被忽视的"人类置信度"
我们苛刻地要求AI模型给出置信度曲线,却从未要求做决策、签字的人给出同样的"校准图"。本文提出用个人置信度台账与可靠性图,让人类判断像机器一样可被评分与检验。

重新审视口音分类:DistilHuBERT 的说话人隔离评估与跨语料泛化
一项基于 DistilHuBERT 的研究指出,口音分类的文件级评估会严重高估模型性能。通过说话人隔离评估与跨语料测试,揭示了模型泛化的真实挑战,并探讨均衡外部数据训练与伪标签方法的效果。

模型每周更新,如何判断哪款适合你的产品?Notion AI负责人谈自建评估
Notion AI负责人Sarah Sachs提出,面对每周发布的新模型与Agent,产品团队应构建自己的评估体系(evals),用数据驱动模型选型、监控线上质量,让AI能力真正转化为产品价值。

提示词敏感性:是模型问题还是评估方式的锅?
大模型对提示词高度敏感,究竟是模型能力缺陷还是评估方法设计不当?本文剖析提示词敏感性的两种来源,并给出区分模型问题与评估器噪声的实用方法。

评估LLM与Agent工作流为何这么难?现实场景中的基准测试困境
来自研究者社区的讨论揭示了现实LLM与Agent工作流评估的核心难点:多工具协作、过程正确性、评估环境成本等。本文梳理现有基准测试的盲区与跨行业需求,为AI工程实践者提供评估思路参考。

提示词扰动如何影响大模型的偏见与幻觉?
一篇 arXiv 研究评估了提示词扰动对大语言模型偏见与幻觉的影响,发现扰动有时反而能缓解问题,且 Claude 3 比 GPT-3.5 表现更稳定,为可信 AI 部署提供参考。

审计LLM裁判:文本转SQL流水线中的评估失效与修复
一项arXiv研究审计了生产级文本转SQL流水线中的LLM-as-judge裁判,发现gpt-4o-mini与人类一致性仅0.04,揭示GRADE-HALLUCINATION失效机制,并给出自托管Qwen模型、强裁判集成等修复方案。
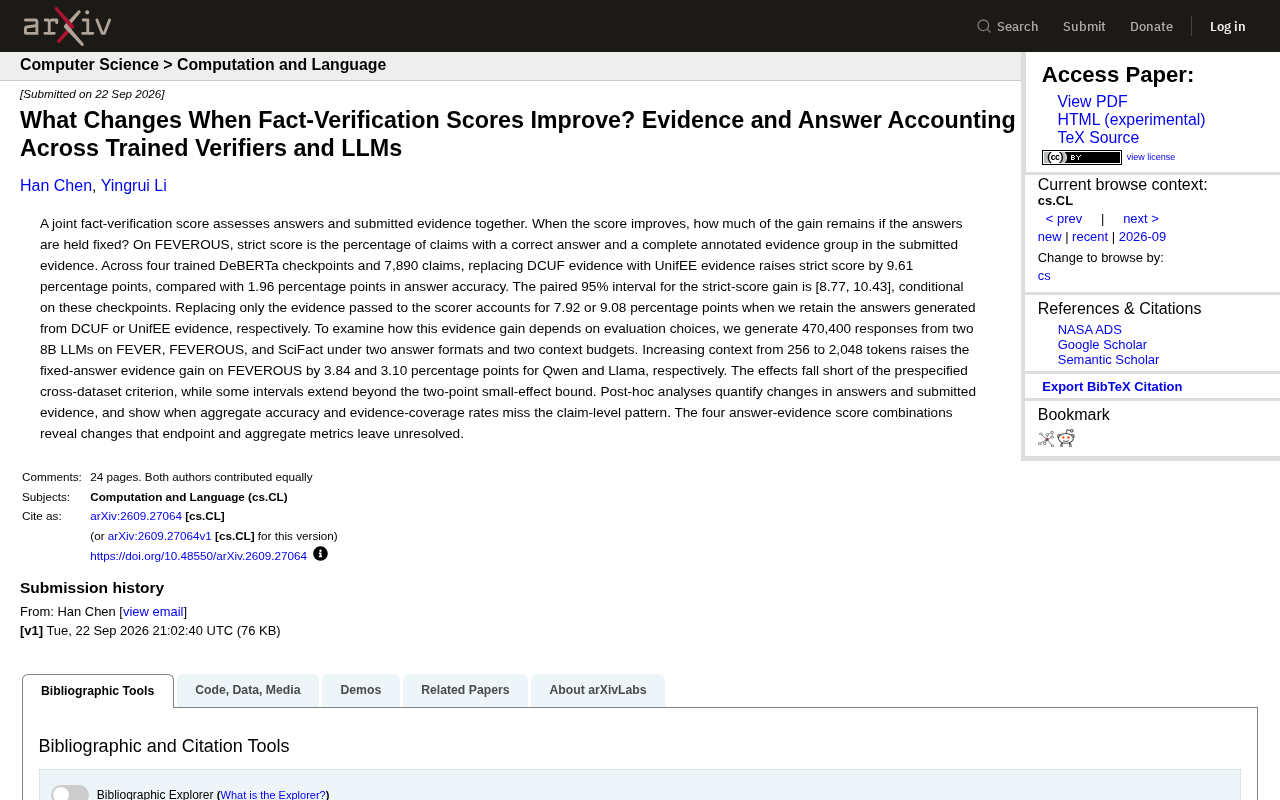
事实核查分数提升的真相:证据比答案更关键
一项arXiv研究拆解了事实核查联合分数的改善来源,发现证据替换带来9.61个百分点的严格分数提升,远超答案准确率的1.96个百分点,揭示了聚合指标掩盖声明层面变化的问题。
 科技前沿
Claude Mythos Preview基准测试成绩曝光:时间跨度超次优模型2倍
Anthropic最新模型Claude Mythos Preview在METR基准测试中表现惊人,80%成功率下时间跨度超过次优模型2倍以上,标志着AI Agent能力实现质的飞跃。本文深度解读METR评测指标及其对AI行业竞争格局的影响。
 产品体验
Roo Code Arena模式与Plan模式详解:AI编程助手新玩法
Roo Code推出Arena Mode竞技场模式和Plan Mode计划模式两大新功能。Arena模式支持AI模型盲测对决,Plan模式实现先规划后执行的编程工作流,全面提升AI辅助编程体验。
 科技前沿
英国AISI评估报告:GPT-5.5网络安全能力与公开可用性引发治理关注
英国AI安全研究所(AISI)发布GPT-5.5网络安全能力评估报告,结果显示其漏洞发现能力与Claude Mythos相当,但因已向公众开放使用,引发AI安全治理新挑战。本文深入解读评估发现与行业影响。