#语音合成
共 27 篇相关文章
·3 分钟
ElevenLabs v4语音模型发布:90种语言与10秒克隆
ElevenLabs 发布全新 v4 语音合成模型,支持 90 种语言、更精细的表现力控制,并可通过 10 秒音频完成声音克隆。本文解析其核心升级与潜在风险。
阅读全文 →
·5 分钟
Gemini 3.8 TTS发布:定制角色语音与场景对话直达全线Google工具
谷歌发布Gemini 3.8 Flash TTS与Flash-Lite TTS两款文本转语音模型,支持定制角色语音和场景对话,全面接入Google AI Studio、Gemini API、Enterprise、Notebook和Vids。解析双模型定位与全线整合策略。
阅读全文 →
·3 分钟
Gemini 3.8 文本转语音功能引发关注
谷歌 Gemini 文本转语音(TTS)功能在 Hacker News 引发热议,本文梳理该话题背景、语音合成的行业意义以及评估 TTS 能力的关键维度,帮助读者理性看待多模态语音赛道竞争。
阅读全文 →
·5 分钟
DeepSeek语音玩出圈:中日混读的"大佐口音"从何而来
DeepSeek语音朗读中日文混读文本时出现"大佐口音"和中式日语,本文解析这种趣味现象背后的语音合成技术原理,探讨多语言TTS在语言切换与韵律建模上的挑战与进步。
阅读全文 →
·4 分钟
Voxtral TTS发布:开源权重语音合成新前沿
Mistral发布Voxtral TTS开源权重语音合成模型,支持9种语言与方言、情感表达自然、延迟极低,并可便捷适配新音色,为开发者提供可本地部署的高质量TTS选择。
阅读全文 →
 产品体验
·7 分钟
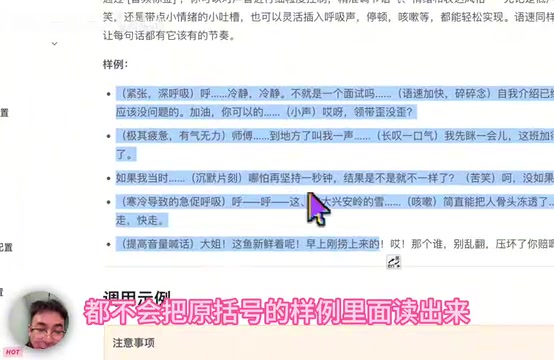
小米mimo-v2-tts踩坑实录:文档矛盾、标签误读、音频串流三大BUG
深度复盘小米mimo-v2-tts语音合成模型的实际使用体验,揭示文档中括号与圆括号标注矛盾、音频标签内容被错误朗读、后端请求串流返回无关音频三大严重问题,并给出开发者避坑建议。
阅读全文 →
