#AI编程
共 9316 篇相关文章

IQ:团队AI使用监控仪表盘,让成本与权限一目了然
IQ 是一款团队 AI 使用仪表盘,集中展示用量、花费与每次请求,支持独立密钥、限额、预算告警和审计日志,内置路由优化成本,并提供 Claude Code 插件。
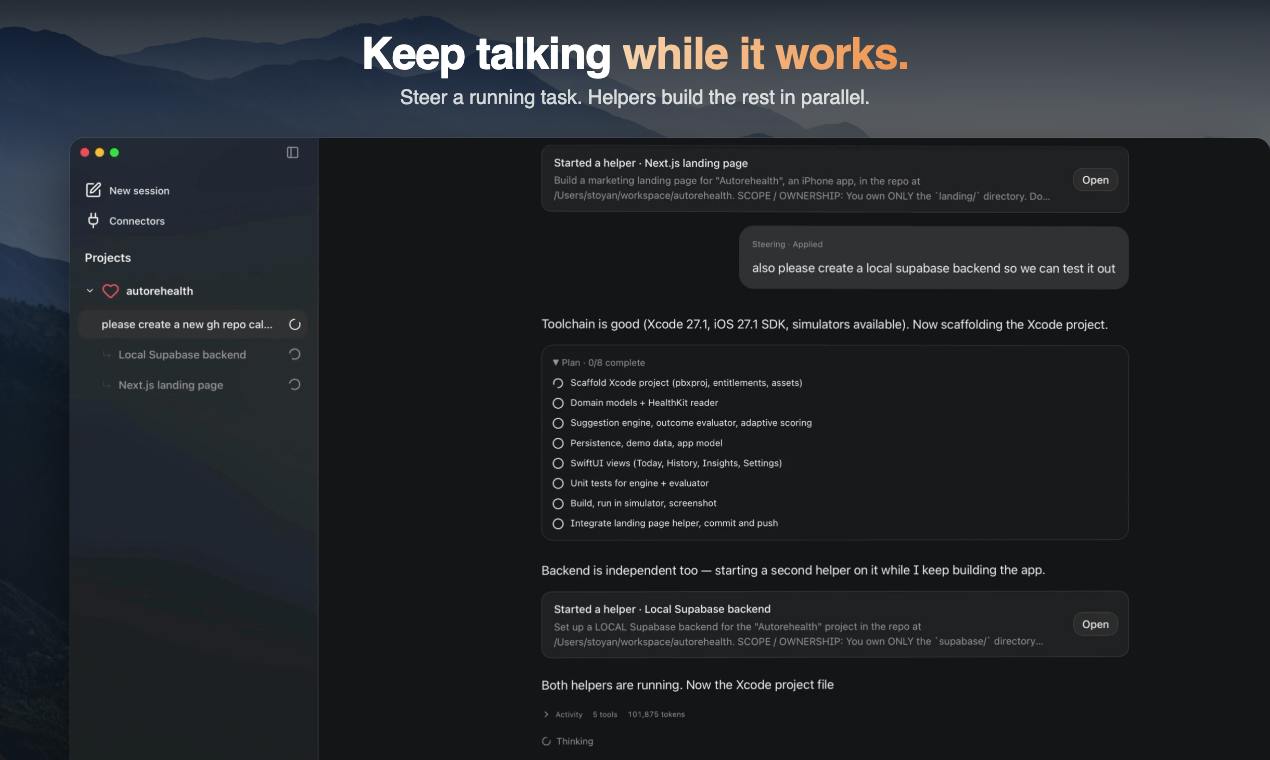
Wavefunction:Mac上的极简开源编程代理
Wavefunction 是一款专为 Mac 打造的极简开源编程代理,支持多任务并行与持续对话,可接入 ChatGPT 订阅、Anthropic、Google、OpenRouter 或本地模型,computer use 运行在独立桌面,免费开源。
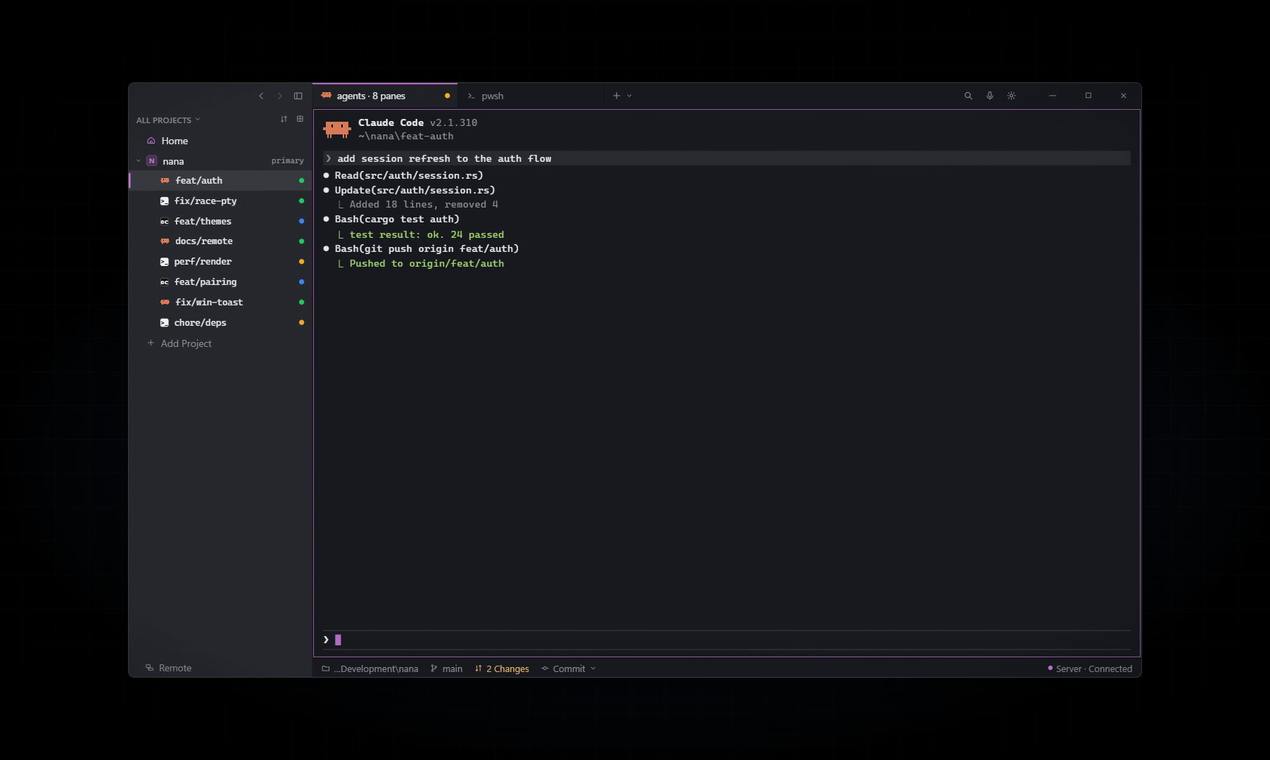
nana:Windows上的多AI编程代理终端管理器
nana是一款Windows原生的终端复用器,支持同时运行Claude Code、Codex、OpenCode等多个AI编程代理,每个代理独立git worktree,提供状态面板、diff审阅和后台持久运行能力,免费beta中。
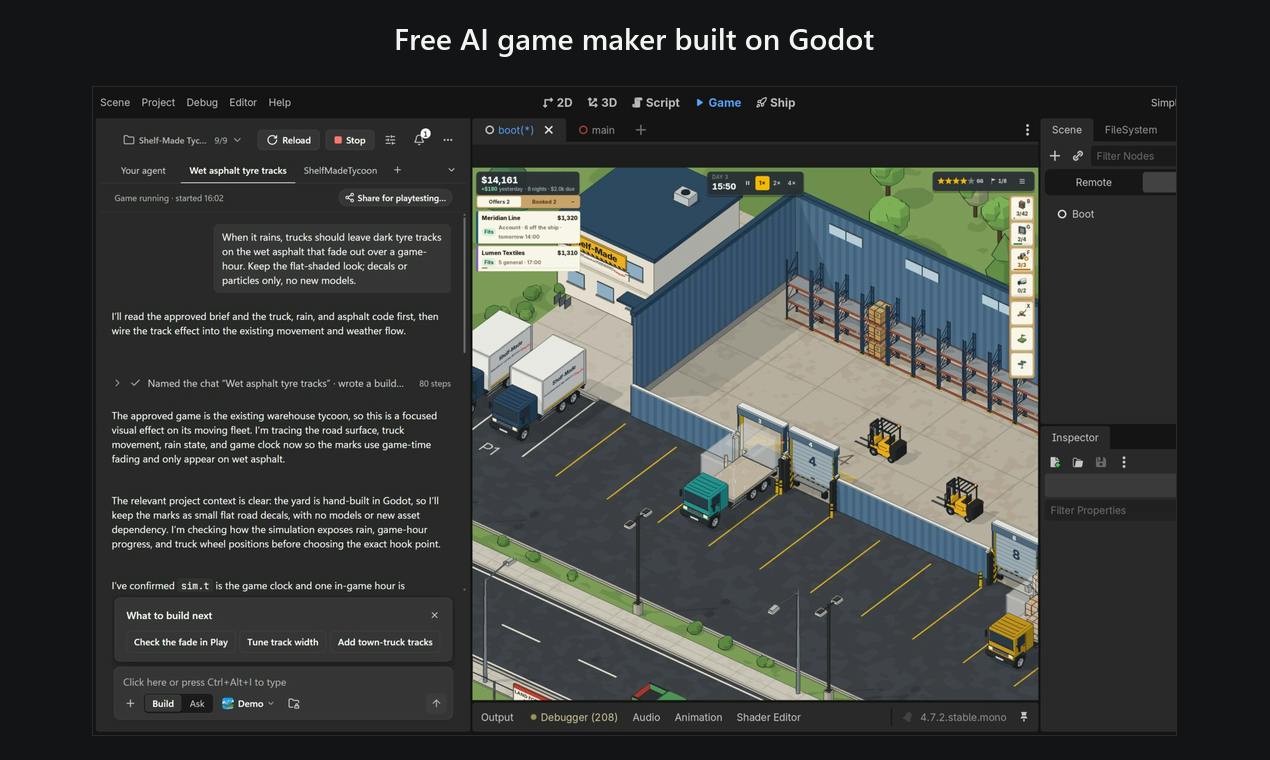
Flockbay:免费AI游戏制作器,基于Godot的智能体编辑器
Flockbay 是一款基于 Godot 引擎的免费 AI 游戏制作器,智能体直接嵌入官方编辑器,能编写 GDScript 和场景并自动 playtest。支持免费托管 AI、自带 Claude Code/ChatGPT/API key/MCP agent 或本地模型,项目保持纯 Godot 4 结构,付费版增加 Steam 页面草稿、预告片和开发日志生成。

One Roof:多AI代理协作的指挥中心,免费开源
One Roof 是 Product Hunt 上的开源开发者工具,将 Claude Code、Codex、Gemini CLI、Kimi 等多个编码代理的真实终端会话集中管理,提供统一收件箱和夜间晨报,让你在多代理协作中保持控制权。

ChatGPT 12月起合并用量额度:企业团队该如何应对?
OpenAI 宣布 12 月起 ChatGPT 与 Codex 在 Plus、Pro、Business 计划中共享同一用量池,按 token 计费,Instant 模式不计入额度。小团队共用账号将面临额度互相挤占,本文梳理变更细节与三项应对建议。
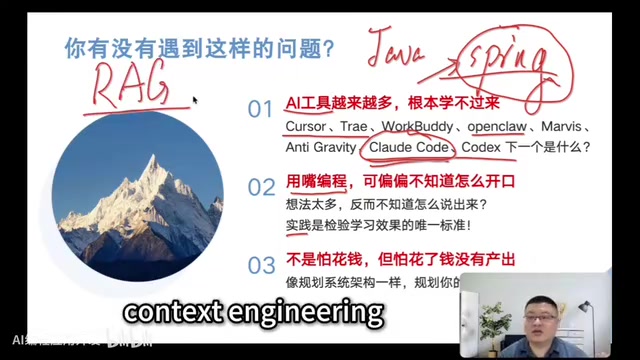
LangChain 1.3系统教程:架构入门与RAG/Agent/MCP/LangGraph全项目落地
LangChain 1.3系统教程梳理:从架构入门到RAG、Agent、MCP、LangGraph多智能体项目实战。课程强调重体系、重实战、重思想,覆盖时间回溯、Deep Agents、本地大模型部署等关键能力,帮助开发者建立底层框架认知,摆脱工具依赖。

Simon Willison十月赞助者通讯:AI开发者的月度洞察
Simon Willison发布十月赞助者专属通讯,涵盖氛围游戏开发拐点、漏洞趋势、LLM发布、API额度及个人工具推荐,订阅费10美元/月可提前一月阅读。

KAPPO:用@k优化控制LLM后训练中的锐化效应
解析LLM后训练中的锐化效应:通过KL正则化pass@k与max@k的闭式解,揭示@k优化按难度重新分配学习压力。KAPPO方法可将现有@1优化器无缝适配到@k,并以单次补全训练实现同等效果。

状态空间模型的对角等价:检索秩与选择性扩展新解
深入解读状态空间模型的对角等价分类,分析 MIMO 检索秩设计、HybridMamba 混合架构、H100 GPU 内核训练加速与内存权衡,以及召回实验与语言模型损失的落差。

DepthGraft:分层KV重建如何成为深度模型的结构正则化利器
DepthGraft提出分层KV共享架构,通过跨层KV重建实现结构正则化,缓解深度模型信息稀释。在16B MoE模型上MMLU-Pro提升7.0%,KV缓存减少约三分之一。
从零实现XGBoost回归:5天手写代码,精度媲美sklearn
开发者用5天时间从零实现XGBoost回归算法,精度与sklearn几乎相同但速度稍慢。本文分析实现难点、精度对比及对机器学习学习者的启示。
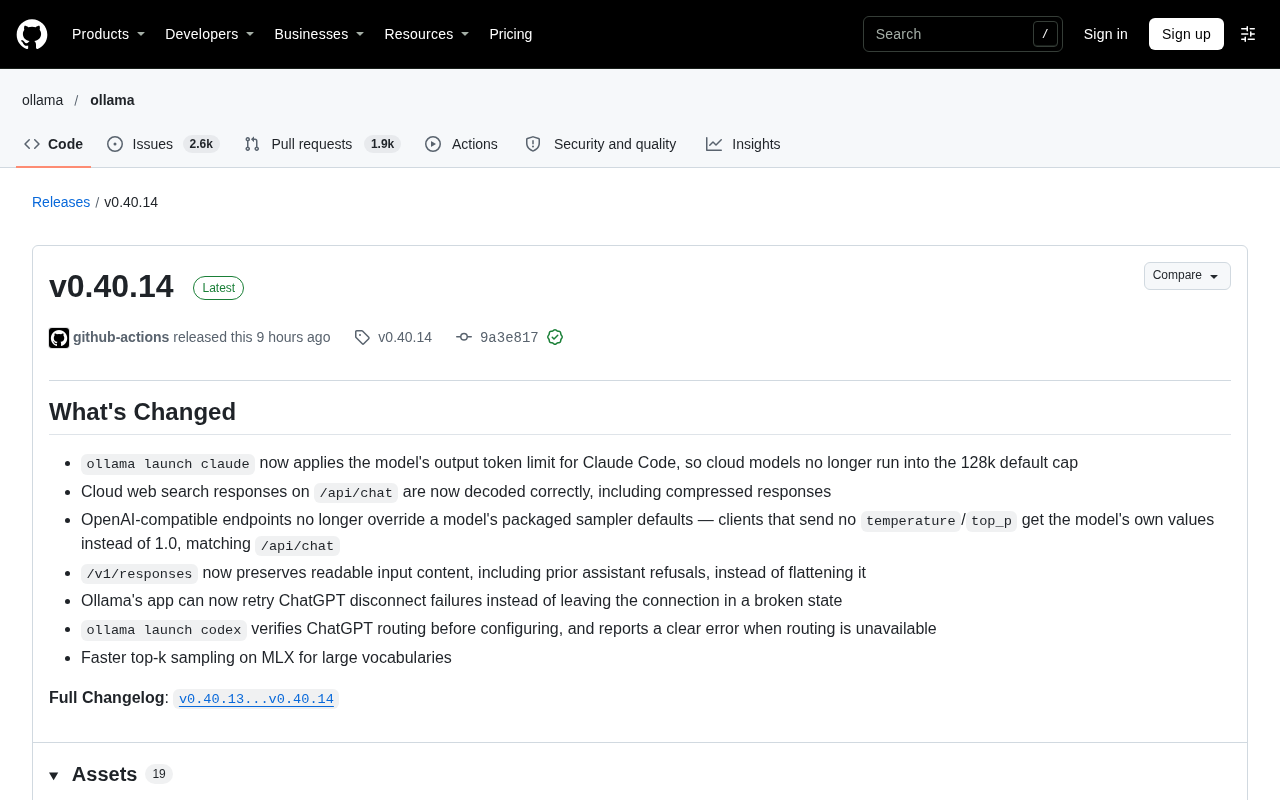
Ollama v0.40.14 更新:修复云模型输出限制与采样默认值
Ollama v0.40.14 发布,修复云模型在 Claude Code 中的 128k 输出上限问题,OpenAI 兼容接口不再覆盖模型采样默认值,并改进 /v1/responses 输入保留与 ChatGPT 连接重试。
LangGraph 集成 VLM:让图像回答更精准的实战思路
介绍如何用 LangGraph 编排 VLM 视觉语言模型处理图像问答,拆解输入解析、视觉提取、生成与校验节点,分析提示词设计、状态管理与重试策略,帮助开发者从图像中获得更稳定准确的回答。

OpenAI自研Pando:Git后端推送延迟降80%
OpenAI 自研 Git 兼容后端 Pando,通过分支独立处理与跨 fetch 复用 packfile,将中位推送延迟降低近 80%,每日承载近 PB 级 Git 数据,为超大型单体仓库的版本控制提供新思路。
预训练数据规模逆转:Muon微调优势为何被AdamW反超
新研究发现预训练数据规模足够大时,AdamW在微调后反超Muon。边际-散布比理论解释这一逆转,为优化器选择提供新视角。

RLVR泛化困境:推理策略为何在OOD下失效
研究揭示RLVR在分布外任务上推理策略崩溃的现象:模型放弃推导退化为暴力枚举,而协同训练双射反转任务能意外恢复OOD准确率,为LLM推理泛化提供新思路。

FADE:解耦能力与难度的在线RLVR调度新方法
FADE提出双线性状态空间滤波,解耦模型能力与提示难度,提升在线RLVR调度效率。在五个推理基准上验证,每步开销低于0.6毫秒,显著改善准确率与校准度。