#Agent评测
共 5 篇相关文章
·8 分钟
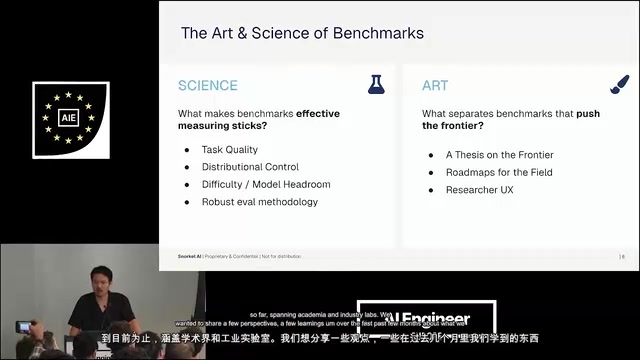
Agent落地卡在评测:Snorkel AI拆解有效基准的六条法则
Snorkel AI联合创始人Vincent拆解Agent评测鸿沟:从任务质量、分布多样性、模型余量到评测方法论,解析有效基准的科学与艺术,并展望环境复杂度、自主时长等下一代基准方向。
阅读全文 →
·4 分钟
工具调用准确率测试的盲区:缺失的“无工具”用例
OpenRouter 指南揭示工具调用评测的盲区:模型调用不该调用的函数仍会产生 tool call,仅检查是否包含调用毫无意义。本文解析工具选择、参数结构与取值之外缺失的第三个维度——调用必要性,并给出轻量日志方案。
阅读全文 →

·7 分钟
空转Agent竟能通过"禁止调用"测试?Agent评测陷阱
AI Agent安全测试存在隐蔽陷阱:空转Agent能通过所有"禁止调用"测试。本文用三个真实用例揭示评分机制缺陷,分析文本检查的必要性及过度调用与沉默两类失败的差异化修复策略。
阅读全文 →
·5 分钟
AI Agent组织自建基准,测评自己也测评同行
Nautilus构建了一个由AI Agent组成的组织来独立评审编码Agent,标准SHA预注册、评审与实现分离、分数附带复现命令,L1评测永久免费,负面结果也公开在排行榜上。
阅读全文 →
 产品体验
·9 分钟
Crafta-Bench:Cursor后台Agent基准测试工具深度解析
深度解析crafta-bench开源项目,一款专为Cursor Background Agents设计的基准测试工具。了解AI编程Agent评测的核心维度、行业趋势及对开发者的实际意义。
阅读全文 →