#Agent
共 134 篇相关文章

Vibe Coding到AI自动化科研:Agent如何重塑科研流程
从Vibe Coding到Coding Agent再到AI自动化科研,解析Agent如何介入文献调研、数据分析与实验执行,以及人机分工中研究者不可替代的判断环节。
Needle:用Claude/ChatGPT/Grok提示词驱动的Agent原生外呼引擎
Needle 是一款 Agent 原生的外呼引擎,支持通过 Claude、ChatGPT、Grok 的提示词在 LinkedIn、Instagram 和邮件上寻找理想客户并触达。本文分析其产品定位、agent-native 设计逻辑与发布信息中缺失的关键细节。
Coze 3.0智能体核心能力拆解:三个月从小白到AI人才
拆解Coze 3.0智能体核心能力,梳理从提示词工程、RAG知识库到多Agent实战的三步学习路线,分析企业AI人才的真实能力要求,理性看待三个月就业承诺。
多开Agent不等于多产出:真正决定效率的是验证环节
多开几个Agent就能多做出几样东西吗?B站视频指出,Agent放大的只是改动量,真正决定产出质量的是验证环节。本文结合AlphaCode案例,分析为什么候选再多也需要筛子,以及测试本身会漏时该如何把验证做小做准。
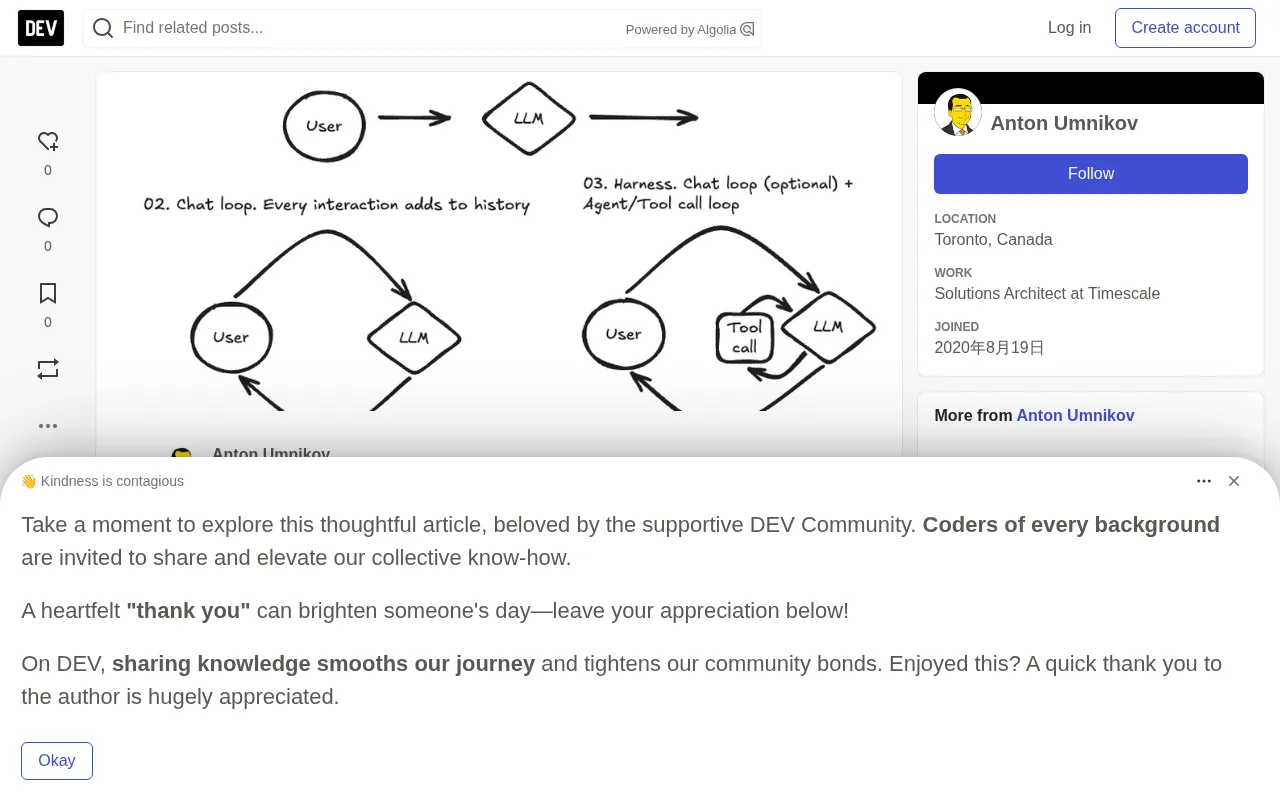
62行Bash手搓AI Agent:极简Harness实现原理
用62行Bash脚本从零构建AI Agent:从单次LLM调用到聊天循环,再到带bash工具调用的编码Agent。详解无状态LLM、上下文维护与工具调用的核心原理,并实测让Agent自动写出可运行的俄罗斯方块游戏。
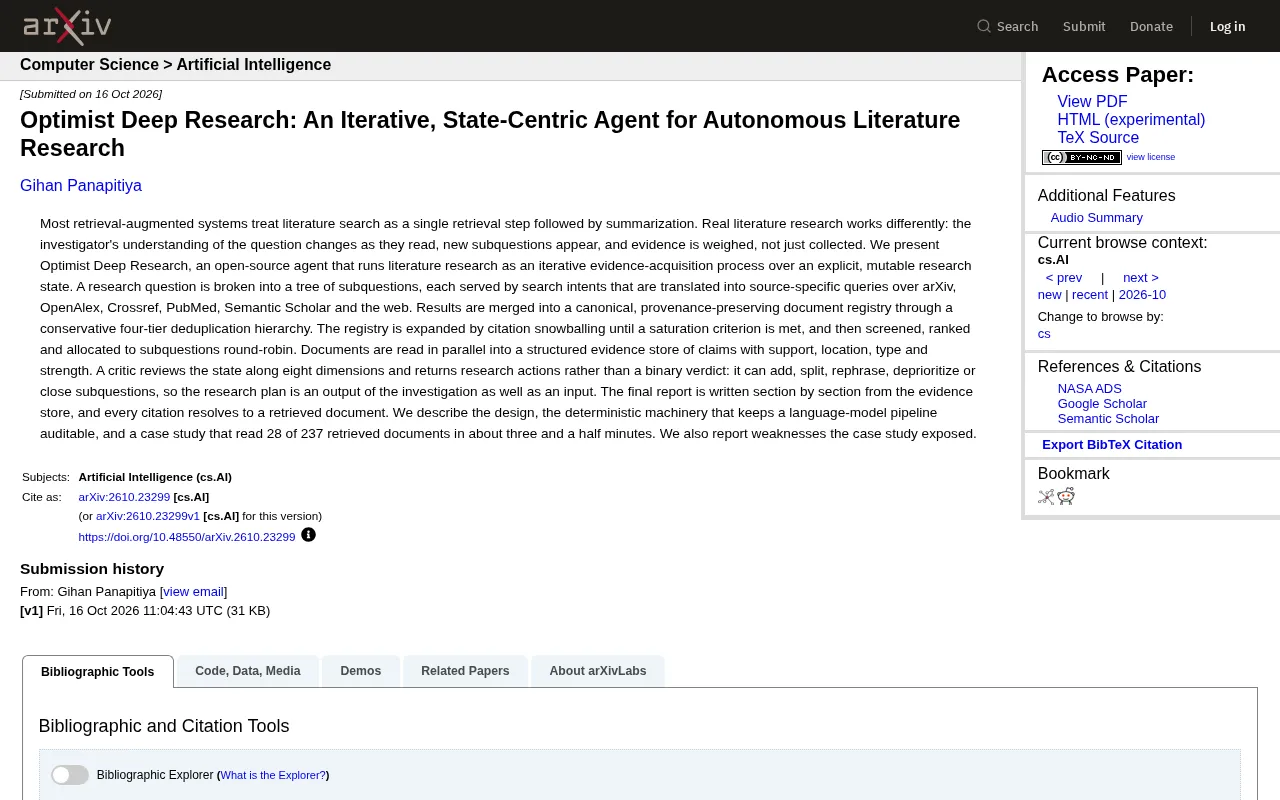
Optimist Deep Research:以状态为中心的迭代式文献研究Agent
Optimist Deep Research 是一个开源文献研究Agent,将文献搜索重构为以可变研究状态为中心的迭代式证据获取过程,支持子问题树拆解、四层去重、引文滚雪球与八维评审,最终报告引用可追溯。
OpenFlow:智能体编排的统一数据平面?
OpenFlow 在 Hacker News 提出「终极智能体编排」,试图把多 Agent 调度做成独立的数据平面。本文分析其解耦思路、可观测性与协议兼容价值,以及生态位与延迟方面的现实疑虑。

别再审计Agent了,审计计数器:AI编程工作流复盘
AI编程Agent工作流复盘:三层重试共用一个日志导致diff无法追溯,reviewer意见不能替代测试退出码,writer与reviewer必须目录隔离。附六步可回放循环与bash门禁脚本,避免五小时无效重跑。
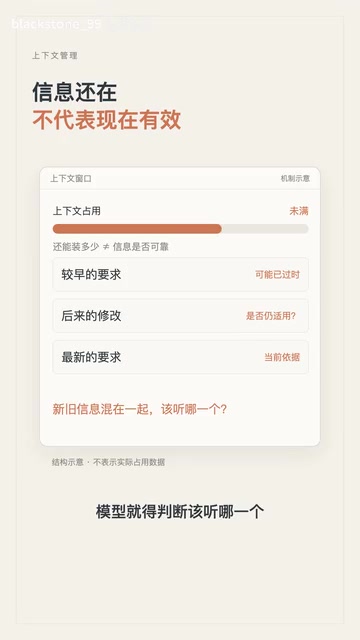
AI越聊越笨?Claude Code与Cursor的上下文管理解法
上下文越长AI越笨?本文解析模型在长对话中误用过时信息的根本原因,并介绍Claude Code与Cursor的应对方法:Agent状态栏、搜索验证、子Agent隔离、按任务压缩历史,帮你理解上下文管理的核心原则。
删掉安装步骤后,我们才发现它撑起了整个设计
CloudPal 团队删除了产品中的安装步骤,却意外发现这个看似微小的打包决策支撑着整个架构设计。本文深入剖析删除安装后暴露的服务器权威、幂等请求、产物身份、权限边界与配置界面等核心约束,并诚实列出本地速度、离线和私有上下文三项代价。
付费用户超20%:电商商家为何涌入千问办公
千问办公电商版上线两个多月,电商商家付费用户占比超20%。多平台数据汇总、价格巡检、素材批量生成等场景正在被AI Agent接手,商家经营效率差距可能被重新拉开。
Gemini 4 Argon 发布:百万输出Token与Agent自进化
Gemini 4 Argon 正式发布,带来行业领先的100万输出Token能力,Agent深度参与模型训练形成RSI飞轮,10万工程师内部测试,写作风格全面重塑。本文深度解析Argon的技术突破、内部测试细节与实用场景。
Agent Memory Without Contamination:多层级记忆架构设计指南
深入解析 Agent 记忆污染问题与多层级记忆架构设计:三层存储、写入闸门、读取排序策略、投毒测试套件、GDPR 合规删除与压缩防漂移,帮助开发者构建可信赖的 AI Agent 记忆系统。

Muse Wonder对比Claude Opus 5.5:同价不同命,任务分工才是关键
Muse Wonder与Claude Opus 5.5 API定价完全相同(4/20/0.2美元每百万token),但基准表现和适用场景截然不同。独立评测Opus智力指数58比52领先,Wonder在SWE-Marathon和法律任务反超,每任务成本4.52美元低于5.98美元。本文通过规格、基准、成本、生态和安全五个维度给出任务分配建议。
MCP工具调用安全:Agent工具面即攻击面
MCP让AI Agent能调用工具,但大多数团队忽视了谁决定调用这一关键问题。本文分析Agent工具调用的注入风险、信任边界判定方法,以及按工具授权、输入校验、审计日志三道缺失防线。

理解机器学习与GPT原理,才能写出更好的Prompt
从 Transformer 到 GPT 再到 Agent,理解大语言模型的统计本质与幻觉成因,帮你写出更精准的 Prompt、降低 Token 消耗、避免 Agent 越界与提示注入。
定义即内核:人与模型都换了,什么资产还能跑
从腾讯OK平台68%自动化率出发,追问AI开发流程里什么才是组织资产:定义即内核,换人换模型换供应商后仍能约束下一次运行的规则才值得保留,其余都是载体。
Stripe Projects让Agent自主开通WorkOS账号
Stripe 的 Rami Banna 在 WorkOS init() 活动中演示了 coding agent 通过 Stripe Projects 自主开通 WorkOS 账号与凭证,并展示 Provisioning API。本文解析这一 demo 对 AI 编程工作流的意义、Agent 权限边界的变化,以及凭证管理与安全方面需要关注的问题。

Drex v2.0 发布:不发散文只下判断的决策模型
Nace.AI 发布 Drex v2.0 决策模型,不发散文本而是直接输出带概率的判断,支持是否题、多选题和评分题,输出免费,与 TypeSafe Jev 共享 API 契约,决策模型正成为独立品类。

Claude架构师认证实战:CCAR-F考试全解析
一位开发者通过Anthropic官方Claude Certified Architect Foundations(CCAR-F)认证考试的完整经历:报考门槛、两小时监考流程、考题风格与备考策略全解析,涵盖Claude Code、Agent SDK、MCP等核心考点。