#MoE
共 35 篇相关文章

Ai2 Olmo-core 3:MoE训练吞吐量提升2.7倍的秘诀
Ai2 开源 Olmo-core 3 训练框架,用 DDP 替代 FSDP 消除 MoE 训练的容量税。专家池从 8 扩到 128 吞吐量仅降 5%,47B 模型吞吐量达旧实现 2.7 倍。

32GB笔记本跑80B大模型:纯C引擎把专家流式塞进SSD
纯C推理引擎Genus在32GB内存无显卡笔记本上跑80B大模型,靠MoE专家流式加载实现24 tokens/s,内置MCP服务器与OpenAI风格接口,可对接VS Code代码补全。
MoE大模型超内存运行实战:llama.cpp专家卸载与SSD流式加载
基于llama.cpp的MoE大模型超内存运行实战指南:通过mmap、--n-cpu-moe专家卸载和SSD流式加载,在有限硬件上运行100B+参数模型,包含内存估算脚本、配置参数与瓶颈诊断方法。

Reflection Beam:501B存、23B醒,自托管者必读
Reflection AI 发布 501B 参数 MoE 模型 Beam,Apache 2.0 开源,1M 上下文。本文从自托管视角拆解 501B 存储与 23B 激活的实际含义、基准表现与工程细节,帮开发者判断是否值得部署。
AMD MoRI + vLLM:面向MoE的宽专家并行与RDMA KV缓存传输
AMD工程师将在PyTorch Conference 2026展示MoRI与vLLM结合的MoE服务方案,涵盖宽专家并行与RDMA KV缓存传输,助力分离式混合专家模型在AMD平台上的高效推理部署。
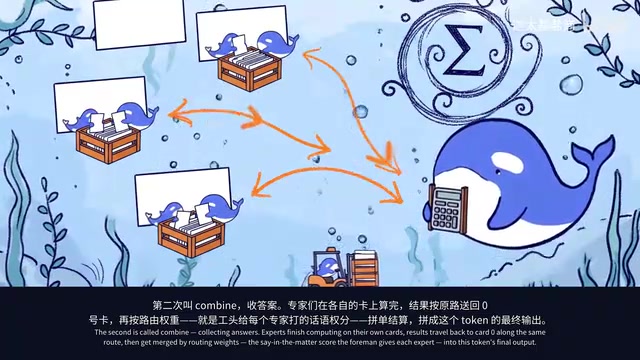
DeepEP Ascend 拆解:DeepSeek MoE 通信库搬上国产昇腾
DeepSeek 开源的 MoE 通信库 DeepEP 已移植到国产昇腾 NPU,本文拆解 DeepEP Ascend 的 Dispatch 派单、Combine 收答案机制、FP8 压缩与计算通信重叠,并解读 8 卡到 128 卡的实测带宽数据。
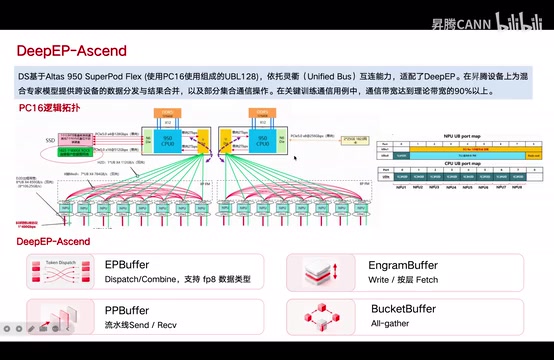
拆解DeepEP与DeepGEMM:MoE通信与大模型矩阵计算加速实战
深度拆解DeepSeek社区开源的DeepEP与DeepGEMM Ascend:前者解决MoE跨设备通信,带宽达理论极限90%以上;后者通过MegaMoE通算融合算子实现852 TFLOPS,训练提速1.5倍、Decode提速2.5倍。

MoE架构如何降本增效:生物基础模型的高效训练之道
NVIDIA分享如何用混合专家(MoE)架构高效训练生物基础模型,解决稠密Transformer扩展成本高的难题。解析MoE稀疏激活原理及其在DNA、蛋白质建模中的应用价值。
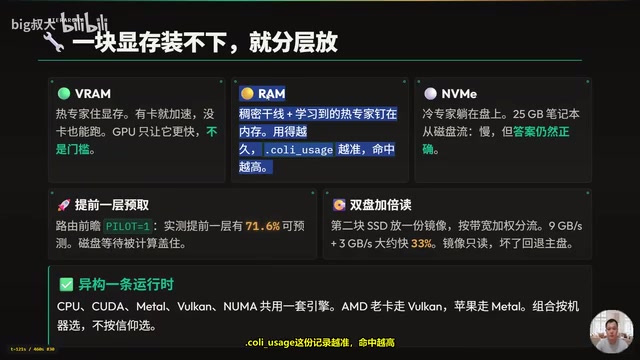
Colibri纯C引擎爆火:25GB内存跑744B大模型
开源项目Colibri(蜂鸟)纯C编写、零依赖,已获约3.6万星标,通过VRAM/内存/磁盘三级调度,让744B参数MoE大模型在25GB内存的消费级机器上流式运行,支持GLM、Kimi、DeepSeek等9大模型家族本地部署。

Dense还是MoE?如何选对AI模型架构
Dense稠密模型与MoE专家混合模型有何区别?本文解析两种AI架构在参数激活方式上的核心差异,并结合质量、延迟、显存与部署场景,帮你判断何时该选Dense、何时该选MoE。

稠密模型 vs MoE:激活参数、吞吐量与选型指南
深入解析稠密模型与 MoE 混合专家模型的核心区别:激活参数、总参数、吞吐量各有何差异?结合 NVIDIA Nemotron 3.5 Lightning 案例,给出实用的模型选型建议。

JAX中加速Dropless MoE训练:NVIDIA Transformer Engine解析
本文解析如何在 JAX 框架中借助 NVIDIA Transformer Engine 加速 Dropless MoE 训练,涵盖 MoE 架构原理、token 丢弃问题、FP8 低精度与分组 GEMM 优化等关键技术。

DeepSeek-V4.1-Flash登陆Fireworks:552B MoE剑指编程与Agent
DeepSeek-V4.1-Flash 正式登陆 Fireworks 平台,这是一款 552B 参数的 MoE 模型,专为编程、网络安全和智能体打造,官方称其在多项基准上以 1/40 成本超越 Opus 5 与 GPT-5.6。
 观点碰撞
Scaling Law再思考:参数不是唯一答案
深度解析Scaling Law从Kaplan到Chinchilla再到MoE时代的演进历程,探讨为什么盲目堆参数是误区,以及GLM-5.3如何通过后训练证明扩展存在多个旋钮。
 深度解读
微软Tutel:MoE模型加速库深度解析,支持FP4/FP8低精度计算
深度解析微软开源Tutel MoE优化库,支持FP8、NVFP4、MXFP4多精度计算,适配DeepSeek、Kimi-K2、Qwen3等主流MoE模型,解决All-to-All通信瓶颈与显存管理难题。