#vLLM
共 54 篇相关文章

vLLM v0.30.0 发布:修复 DeepGEMM CUDA 12.9 构建问题
vLLM v0.30.0 正式发布,核心修复 DeepGEMM 在 CUDA 12.9 环境下的发布构建问题(PR #57554)。本文解析该修复的背景、影响及对大模型推理部署用户的升级建议。

vLLM大会圆满落幕:开源推理引擎社区的爆发力
vLLM大会圆满落幕,现场演讲一票难求、排队入场,展现开源推理引擎社区的强大人气。会议录像已公开,本文解析vLLM为何成为大模型推理部署的热门选择。
vLLM v0.30.0rc2 发布:修复NIXL通知请求处理问题
vLLM 发布 v0.30.0rc2 候选版本,核心修复 NIXL 传输层对通知类请求的处理逻辑,避免冗余接收报告。本文解读该更新内容、NIXL 作用及对分离式推理部署的影响。

vLLM 部署 Kimi K3 吞吐量提升 2.2–2.8 倍:性能优化拆解
Kimi K3 在 vLLM 上的部署性能获得显著提升,B300 基准测试显示吞吐量较 v0.27.1 提升 2.2–2.8 倍。本文拆解调度、KDA 状态处理与 MoE 内核三大优化方向及其对推理成本的影响。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
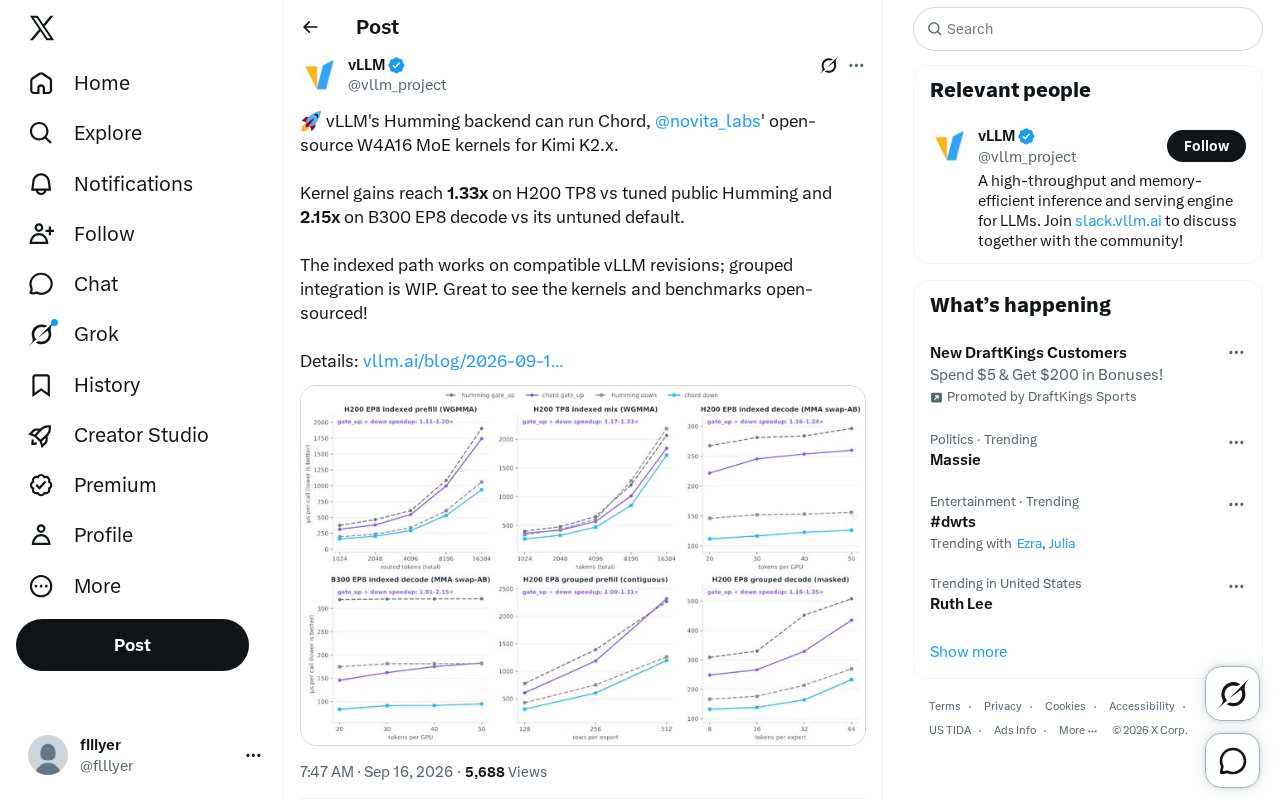
vLLM 集成 Chord 内核:Kimi K2.x 推理加速最高 2.15 倍
vLLM 的 Humming 后端现已支持 Novita Labs 开源的 Chord W4A16 MoE 内核,针对 Kimi K2.x 优化。H200 TP8 加速 1.33 倍,B300 EP8 解码加速最高 2.15 倍,indexed 路径已可用。

vLLM 发布 proto-v0.3.0:高性能推理框架再迭代
开源推理框架 vLLM 发布 proto-v0.3.0 版本,由维护者签名验证发布。本文解析该版本对协议层管理、分布式推理及供应链安全的意义。
vLLM 发布 proto-v0.2.0:内部协议模块迭代
vLLM 项目发布 proto-v0.2.0 标签(vllm-proto 0.2.0),经 verified signature 签名并通过 PR #56538 CI 验证。本文解读该组件级版本发布的工程意义与安全实践。
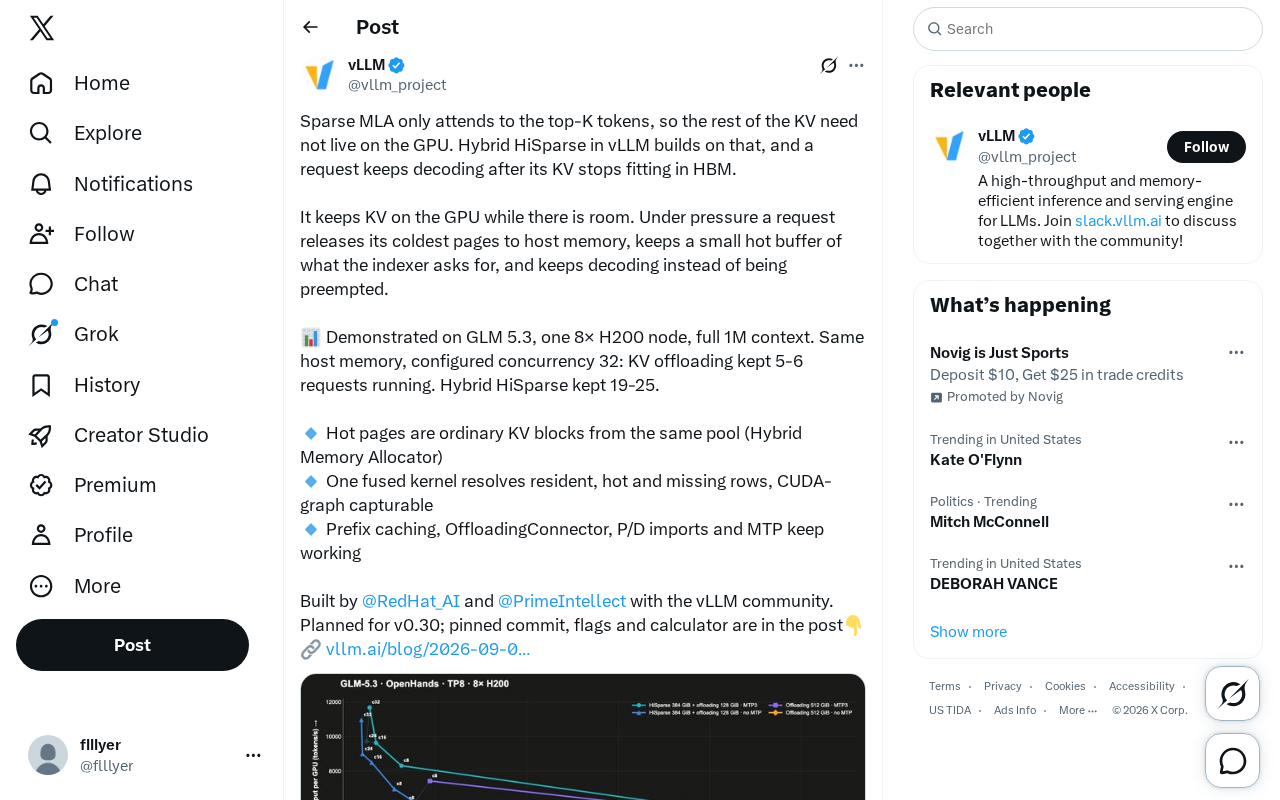
vLLM Hybrid HiSparse:稀疏MLA破解长上下文显存瓶颈
vLLM 社区推出 Hybrid HiSparse,基于稀疏 MLA 与分级内存调度,让长上下文请求在显存不足时持续解码。GLM 5.3 实测显示,8×H200 节点上并发请求数从 5-6 提升至 19-25,将集成于 vLLM v0.30。
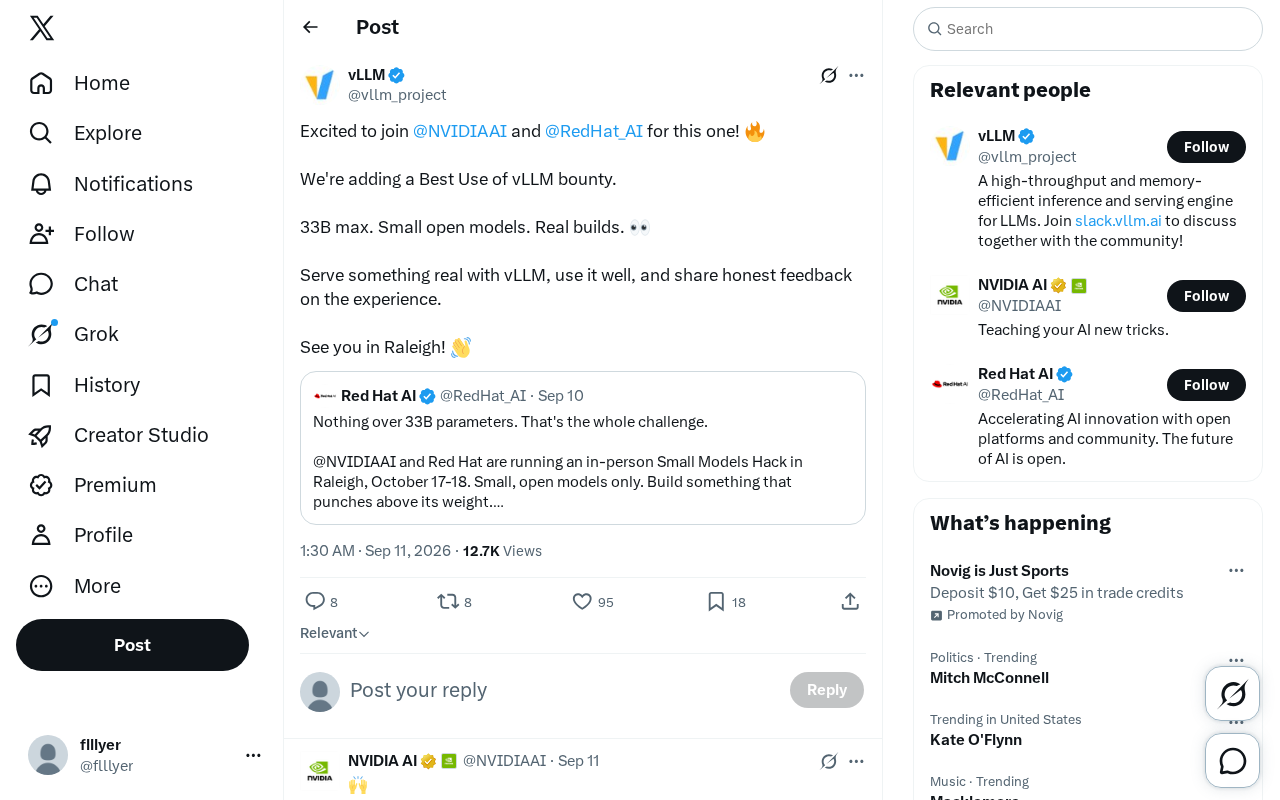
vLLM 黑客松赏金上线:33B 以下开源模型的实战部署较量
NVIDIA 与 Red Hat 联合为 vLLM 增设「最佳应用」赏金,聚焦 33B 以下小型开源模型的真实部署与推理优化。本文解读活动信号、参数上限逻辑及对开发者的实战参考价值。

DeepSeek-V4.1-Flash发布:552B MoE与Engram记忆架构解析
DeepSeek-V4.1-Flash正式发布,采用552B MoE主干、100万上下文与原生视觉,vLLM从首日起支持并验证NVIDIA与AMD GPU。深度解析Engram记忆架构与压缩KV共享两项核心创新。

vLLM v0.29.0发布:Model Runner V2成默认引擎,推理性能全面升级
vLLM v0.29.0正式发布,Model Runner V2成为所有模型的默认引擎。本次更新汇集277位贡献者的594次提交,涵盖Kimi、DeepSeek模型优化、Mamba前缀缓存、投机解码可观测性及RL权重P2P同步等关键升级。

vLLM Day-0支持之后:社区如何把MiniMax M3推理提速3-4倍
AMD与EmbeddedLLM发布博客,记录在Instinct MI355X上优化MiniMax M3的vLLM推理服务过程,通过“跟着瓶颈走”的方法实现3-4倍吞吐提升。解析day-0支持与社区调优范式。
 教程攻略
vLLM与SGLang本地部署教程:性能提升3-8倍的实战指南
详解vLLM和SGLang本地部署全流程,对比LM Studio性能差距,通过Docker+AI助手三步完成部署。涵盖SGLang与vLLM选型建议、5090显存优化、Qwen3模型推荐及Cherry Studio接入方法。