#vLLM
共 54 篇相关文章
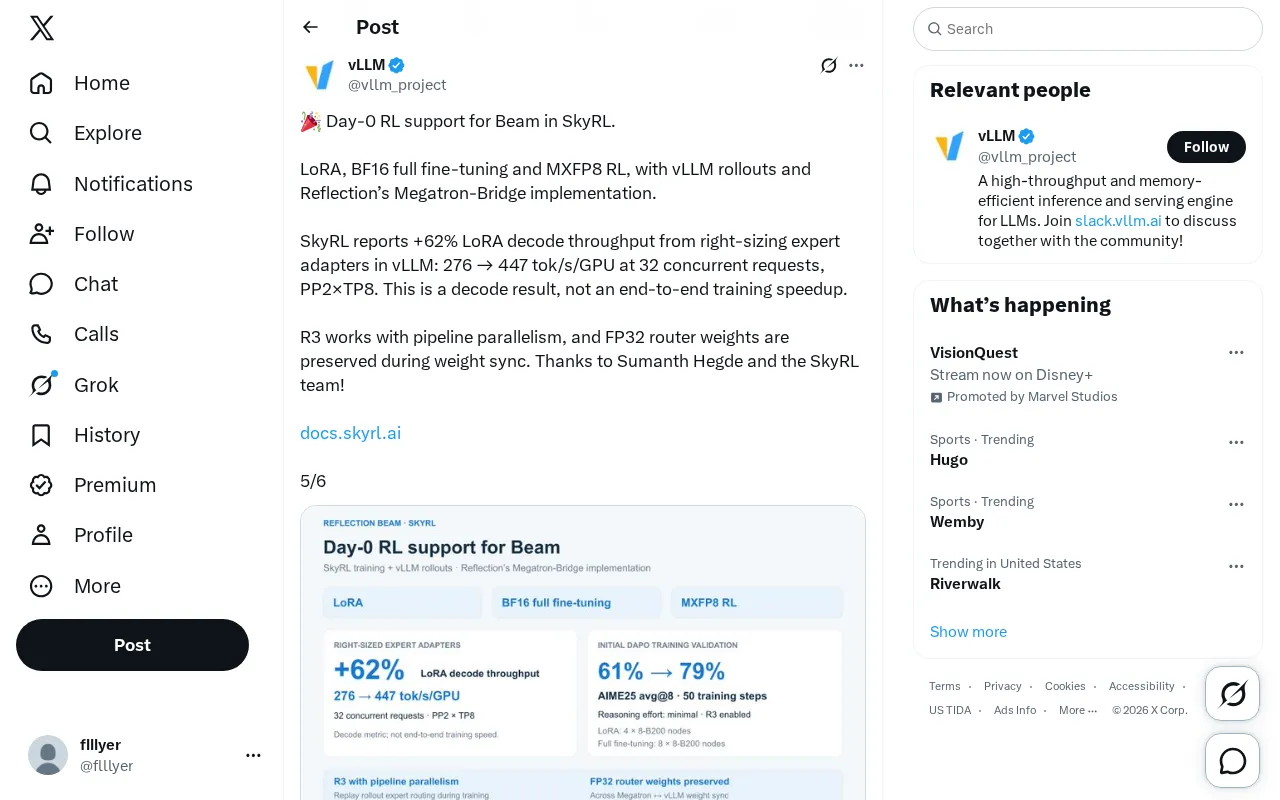
SkyRL实现Beam Day-0强化学习支持,LoRA解码吞吐提升62%
SkyRL 宣布对 Reflection 的 Beam 模型实现 Day-0 强化学习支持,覆盖 LoRA、BF16 全量微调与 MXFP8 RL,结合 vLLM rollout 和 Megatron-Bridge,LoRA 解码吞吐提升 62% 至 447 tok/s/GPU。

Muse Spark Open登陆vLLM:小模型的大故事
Muse Spark Open模型登陆vLLM推理引擎,集多模态理解、1M上下文、智能体规划、DSpark与跨平台支持于一体。本文解读其技术特性、vLLM集成意义及对开发者的实际影响。

vLLM发布v0.32.0rc2:DeepSeek-V4.1-Flash评测锁定FP8-Engram版本
vLLM 发布 v0.32.0rc2,CI 改动将 DeepSeek-V4.1-Flash-NVFP4 评测锁定到 FP8-Engram 版本。这一调整反映了推理框架对多精度格式评测可复现性的重视。

proto-v0.5.0 发布:GitHub 版本标签信息解读
GitHub 开发者 BugenZhao 发布 proto-v0.5.0(vllm-proto 0.5.0)版本标签,经过签名验证。本文解读该版本标签的签名可信度、工程意义及升级建议。

vLLM v0.31.1rc0发布:按缓存层级暴露缓存Prompt Token指标
vLLM 发布 v0.31.1rc0 候选版本,新增按缓存层级(cache tier)暴露缓存 prompt token 的指标功能(PR #56318),为大规模 LLM 推理服务的成本优化与性能监控提供更细粒度的可观测性数据。

vLLM 亮相 PyTorchCon:开源推理基础设施的集体发声
vLLM 核心维护者团队集体亮相 PyTorchCon 北美大会,Simon Mo 发表开源推理基础设施主题演讲,Red Hat AI 团队分享智能体推理与注意力机制,展现开源大模型推理栈的技术风向。

vLLM Semantic Router 发布 Decision 2.0:单次推理回答64个请求问题
vLLM Semantic Router 发布 Decision 2.0,提供 0.6B 到 27B 的开放模型,单次前向推理可回答 64 个请求问题,采用 Apache-2.0 许可并支持 Transformers 加载,为 LLM 服务的语义路由带来高效方案。

vLLM多伦多见面会官宣:Cohere、NVIDIA联合主办
vLLM官方宣布将于10月15日在多伦多举办线下技术见面会,由Cohere、NVIDIA AI与Inferact联合主办。活动免费开放,重点分享vLLM未来发展方向与团队交流。
vLLM 发布 v0.31.0:为 Transformers 版本设置上限约束
vLLM 发布 v0.31.0 版本,核心改动是在依赖项中为 Transformers 库添加版本上限约束,提升兼容性与部署稳定性。本文解析该改动的技术动机与对使用者的实际影响。

vLLM v0.31.0rc5 发布:为 Transformers 版本加上上限约束
vLLM 发布 v0.31.0rc5 候选版本,核心变更是为 transformers 库增加版本上限约束(PR #59614),提升推理框架在生产环境中的依赖稳定性与可预期性。

用 Helion 构建高性能可移植的 vLLM 线性后端
本文解析将 Helion 高层 kernel DSL 集成进 vLLM 线性后端的技术实践,探讨如何通过自动调优在提升 LLM 推理性能的同时,用单一通用 kernel 降低实现复杂度并增强跨硬件可移植性。

本地大模型部署入门:Ollama与vLLM部署qwen3实战解析
本地大模型部署入门教程:解析Ollama与vLLM两大部署工具的核心差异,梳理显存平衡、高并发、服务化等部署目标,并介绍如何用vLLM部署qwen3-0.6B模型。
vLLM v0.31.0rc4 发布:修复MTP在FULL图下的问题
vLLM 发布 v0.31.0rc4 候选版本,重点修复 MTP 多 token 预测在 FULL CUDA 图模式下的接受率崩溃问题。本文解读该版本的核心变更、技术背景及升级建议。

vLLM v0.31.0rc3发布:Model Runner V2引入随机化虚拟输入
vLLM 发布 v0.31.0rc3 候选版本,核心更新为 Model Runner V2 支持随机化虚拟输入,提升显存剖析与推理预热精度。本文解析该特性原理及对部署者的实际影响。

vLLM 发布 proto-v0.4.0:签名验证与协议层升级解读
vLLM 开源推理框架发布 proto-v0.4.0 版本,聚焦协议层组件更新并采用已验证签名机制。本文解读该版本的关键信息、vllm-proto 组件作用及对开发者集成部署的影响。

vLLM 发布 v0.31.0rc2 预览版:Mamba 稀疏采样修复
vLLM 发布候选版本 v0.31.0rc2,核心修复了 Mamba 架构在稀疏采样场景下的 prefill 检查点保留问题。本文解读该版本变更及其对状态空间模型推理正确性的影响。

vLLM v0.30.0 发布:混合注意力与推测解码全面升级
vLLM v0.30.0 正式发布,带来混合注意力热点路径优化、HiSparse 分层稀疏解码、Model Runner V2 推测解码增强、内容水印与 Fast Start 快速启动等多项更新,并新增多款模型支持。
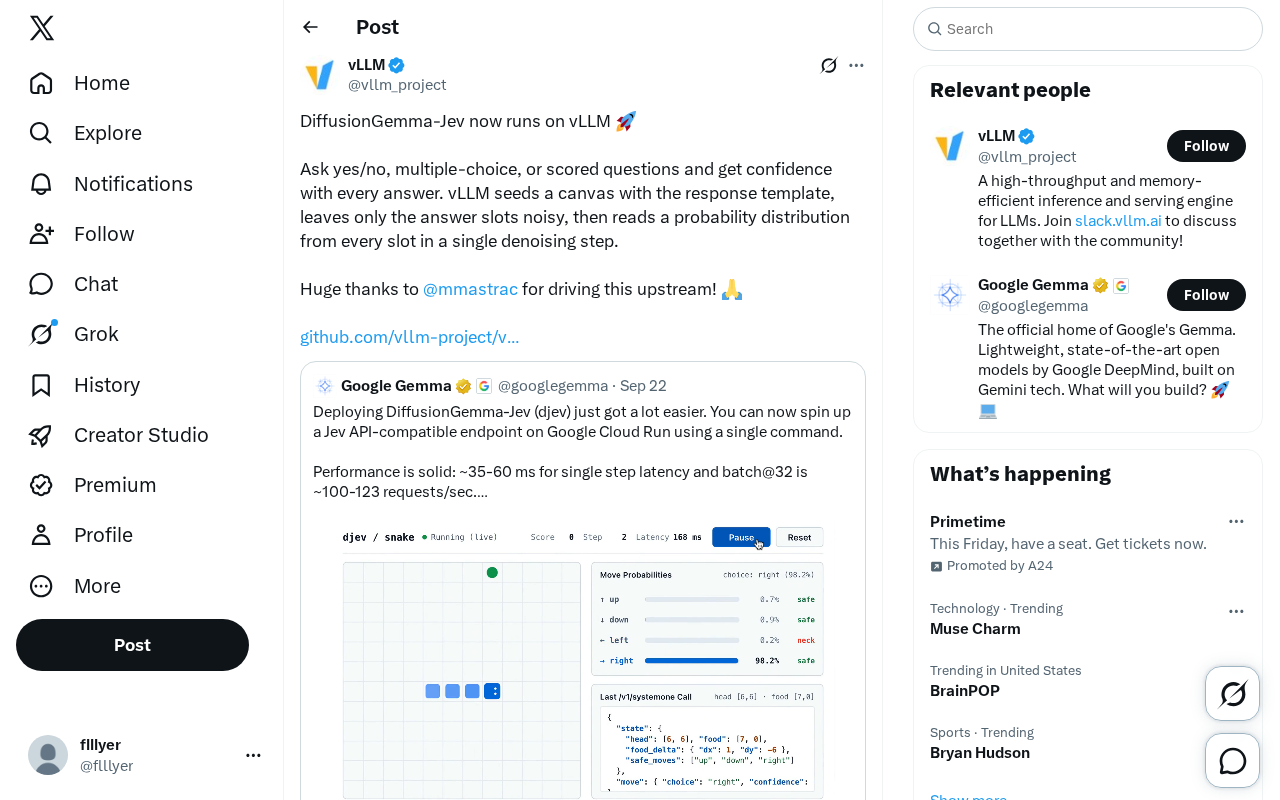
DiffusionGemma-Jev接入vLLM:让每个回答都带置信度
DiffusionGemma-Jev 现已支持 vLLM 运行,可对是非题、选择题和打分题输出带置信度的答案。通过单步去噪读取每个答案槽位的概率分布,扩散语言模型迈向生产化部署。

