AdaptiveSpec:免训练推测解码方案提速56%的技术解析

LLM推理加速的新思路:推测解码为何重要
大语言模型(LLM)的推理速度一直是制约其大规模落地的核心瓶颈。LLM采用自回归(autoregressive)方式生成文本,即每次只产出一个token,且下一个token的生成必须等待前一个token完成。这意味着生成一段包含N个token的文本,就需要N次串行的前向传播(forward pass)。由于现代GPU在推理场景中往往受限于内存带宽(memory-bandwidth bound)而非纯算力,单次前向传播的延迟难以通过简单堆叠硬件来线性降低,这使得逐token生成成为一个本质性的性能瓶颈。
LLM推理之所以受限于内存带宽而非计算能力,根源在于自回归解码阶段的算术强度(arithmetic intensity)极低。在生成每个token时,模型需要将全部参数(通常数十GB)从GPU的HBM(高带宽内存)加载到计算单元,但每次加载只执行一个token的矩阵-向量乘法运算。以一个70B参数的模型为例,即使采用FP16精度,每次前向传播需要搬运约140GB的权重数据,但实际执行的浮点运算量仅约140 GFLOP——这意味着每搬运1字节数据只做了约1次浮点运算,远低于现代GPU数百FLOP/Byte的算力带宽比。这就是所谓的"memory-bandwidth bound"状态,即GPU的计算核心大部分时间在等待数据搬运完成。这也解释了为何简单地使用更强的GPU(更多的计算核心)无法线性降低延迟——瓶颈不在算力,而在数据搬运速度。
推测解码(Speculative Decoding)正是针对这一瓶颈而生的加速技术。其基本思路是:先用一个轻量的"草稿模型"(drafter)快速生成候选token,再由目标大模型并行验证,从而在一次前向传播中确认多个token,显著降低逐token生成的延迟。核心洞察在于——既然大模型单次前向传播的耗时相对固定,那么让它在一次计算中同时评估多个候选位置,就能"批量确认"输出,将有效生成速度提升数倍。
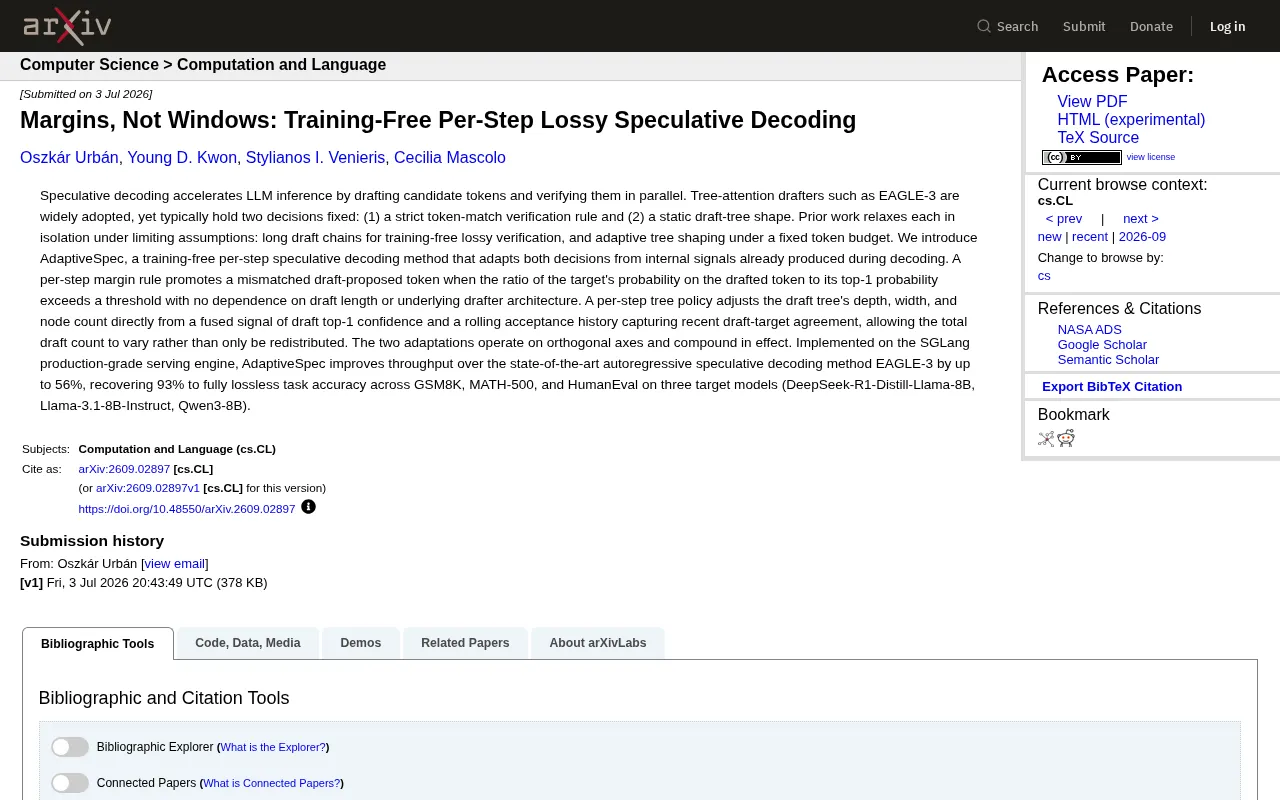
然而,主流的树注意力(Tree-attention)草稿方案,如广泛采用的 EAGLE-3,通常固化了两个关键决策:一是严格的token匹配验证规则,二是静态的草稿树结构。一篇发表于 arXiv 的论文《Margins, Not Windows: Training-Free Per-Step Lossy Speculative Decoding》提出了名为 AdaptiveSpec 的方法,试图同时打破这两个限制,且无需任何额外训练。
现有推测解码方案的两大局限
在理解 AdaptiveSpec 的创新之前,有必要厘清现有推测解码方案面临的两个关键痛点。
严格的token匹配验证机制
传统推测解码采用严格的验证规则:只有当草稿模型提出的token与目标模型的采样结果完全一致时,才会被接受。这种机制的理论基础是一种基于拒绝采样(rejection sampling)的验证协议——当草稿token的概率不低于目标模型分配的概率时直接接受,否则以一定概率拒绝并从修正分布中重新采样。
具体而言,这一验证方法由Leviathan等人和Chen等人在2023年独立提出。其数学原理如下:设草稿模型在某位置的概率分布为q(x),目标模型为p(x),对于草稿提出的token x,以min(1, p(x)/q(x))的概率接受。如果被拒绝,则从修正分布norm(max(0, p(x)-q(x)))中重新采样。可以严格证明,这一过程产生的token分布与直接从目标模型p(x)采样完全一致。这种"lossless"保证是推测解码被广泛接受的重要原因——它在加速推理的同时不改变模型的输出分布。然而这也是一把双刃剑:严格等价意味着即使两个token在语义上完全等价,只要它们在两个模型中的概率比不满足条件,就会被拒绝。
这种数学上的严格等价性保证了输出与原模型完全一致(lossless),但也导致大量语义上高度接近、实际差异微乎其微的候选被拒绝。例如,"cannot"与"can not"、"1,000"与"1000"这类在语义上几乎等价的token对,只要概率分布存在细微差异就可能触发拒绝,白白浪费了草稿计算资源。
静态的草稿树结构问题
第二个问题在于草稿树的形状是预先固定的。树注意力(Tree Attention)是推测解码中的一种高效验证策略——与简单的单链草稿不同,它将草稿组织成一棵树结构,每个内部节点可以有多个子节点,代表不同的候选延续路径。在验证阶段,目标模型通过特殊设计的注意力掩码(attention mask),在一次前向传播中同时评估树上所有路径的合理性,然后沿概率最高的路径贪心地接受尽可能多的token。
EAGLE系列(EAGLE、EAGLE-2、EAGLE-3)是该方向的代表性工作。EAGLE(2024年初)的核心创新是训练一个轻量级的自回归头(autoregressive head),它以目标模型的隐藏状态(hidden states)作为输入特征来预测下一个token的特征表示,而非直接预测token本身。这种设计绕过了传统草稿模型需要独立编码上下文的开销。EAGLE-2在此基础上引入了动态草稿树构建,根据草稿模型的置信度分数来选择性扩展树节点。EAGLE-3则进一步优化了训练策略,引入了更高效的特征融合机制,并改进了树结构的剪枝策略。但即使是EAGLE-3,其树的总规模(深度×宽度的预算)在推理过程中仍是预先设定的固定值。这意味着在"容易预测"的场景下计算资源被浪费,而在"困难场景"下又可能因草稿不足而错失加速机会。
此前的研究虽然尝试过放松这两个约束,但往往是孤立进行,且带有较强的前提假设——例如免训练的有损验证依赖较长的草稿链,或自适应树塑形被限制在固定的token预算之内。AdaptiveSpec 的价值在于同时、动态地优化这两个维度。
AdaptiveSpec的核心技术创新
AdaptiveSpec 是一种免训练、逐步自适应的推测解码方法。它的巧妙之处在于,所有决策所需的信号都已经在正常解码过程中天然产生,无需额外的模型或训练开销。
逐步Margin规则:用边际比取代窗口
论文标题中的"Margins, Not Windows"点明了第一个核心思想。AdaptiveSpec 引入了一个逐步边际规则(per-step margin rule):当目标模型在草稿提出token上的概率,与其top-1 token概率之比超过某个阈值时,即便二者不完全匹配,也接受该草稿token。
这个规则可以直观地理解为一种"相对置信度"判断。举例来说,假设目标模型在某个位置的top-1 token是"excellent"(概率0.35),而草稿提出的token是"great"(目标模型赋予的概率为0.30),二者的概率比为0.30/0.35≈0.86。如果预设阈值为0.8,则该草稿token会被接受。背后的语义直觉是:当目标模型认为草稿token"几乎和最佳选择一样好"时,二者之间的差异大概率不会影响最终输出质量。
有损推测解码之所以在实践中可行,本质上是因为现代LLM的输出分布在许多位置具有高度的不确定性——模型自身在多个候选token之间并无强烈偏好。研究表明,在自然语言生成中,大量位置的top-1 token概率低于0.5,意味着模型本身就"拿不准"该选哪个词。在这些位置上,接受一个概率略低于top-1的候选,其对下游生成质量的影响微乎其微。但在关键决策点——如数学推理中的运算符选择、代码生成中的变量名引用——模型的概率分布往往高度集中在少数几个token上,此时margin规则的高阈值要求会自然地趋向严格匹配,从而保护这些关键位置的准确性。这种"自适应严格度"正是margin规则在高精度任务上仍能保持93%以上准确率的深层原因。
这个规则具备三个关键优势:
- 不依赖草稿长度:无论草稿链多长都适用,每一步独立决策
- 不依赖草稿架构:对底层drafter的类型没有要求,具有即插即用的通用性
- 有损但可控:通过阈值调节,在速度与精度之间灵活平衡
与此前某些方法使用的"滑动窗口"机制不同——后者需要在一段连续的草稿链上累积统计信息才能做出判断——margin规则在每一步独立决策,因此具有更强的通用性。
逐步树策略:动态调整草稿树规模
第二个创新是逐步树策略(per-step tree policy)。AdaptiveSpec 融合两个内部信号来动态调整草稿树的深度、宽度和节点数:
- 草稿top-1置信度:反映草稿模型对当前预测的确信程度
- 滚动接受历史(rolling acceptance history):捕捉近期草稿与目标模型的一致性趋势
与以往方法在固定token预算内"重新分配"节点不同,AdaptiveSpec 允许草稿总数本身发生变化。当近期接受率高、置信度充足时,系统会扩大草稿树以争取更大加速;反之则收缩草稿树,避免无效计算开销。这种"弹性伸缩"的策略使得计算资源的分配与实际解码难度动态匹配。
正交叠加:两种自适应机制的协同效应
论文特别指出,这两种自适应机制作用于正交的维度——Margin规则优化"验证决策"(即对已生成的草稿如何判定接受或拒绝),树策略优化"生成决策"(即在下一步应该生成多少、怎样结构的草稿),二者互不干扰。因此它们的效果能够叠加复合(compound),而非相互抵消。这种设计上的解耦,正是 AdaptiveSpec 能够取得显著整体收益的关键所在。
实验结果:56%吞吐量提升与精度保持
AdaptiveSpec 并非停留在理论层面。研究团队直接将其实现在了生产级服务引擎 SGLang 之上,使实验结果更具工程参考价值。SGLang是由UC Berkeley等机构开发的开源LLM推理和服务框架,专为高吞吐、低延迟的生产级部署而设计,其核心技术包括RadixAttention(一种高效的KV缓存复用机制)和连续批处理(continuous batching)。
SGLang的核心技术创新RadixAttention将KV缓存组织为一棵前缀树(radix tree),使得具有相同前缀的多个请求可以共享KV缓存,避免重复计算。这对推测解码尤为关键:树形草稿结构中不同分支共享前缀的特性与RadixAttention天然契合。SGLang还实现了连续批处理(continuous batching),即不等一个batch中所有请求都完成就立即将新请求插入空位,最大化GPU利用率。在SGLang上实现AdaptiveSpec需要特别处理的工程挑战包括:动态变化的草稿树规模导致每步的注意力掩码形状不同,需要高效的掩码生成和内存管理;草稿树大小在不同请求间可能差异很大,对批处理中的padding策略带来额外复杂度。
相比于纯研究性质的推理脚本,在SGLang这样的引擎上实现和评测意味着必须处理真实的系统级挑战——包括多请求并发调度、GPU显存管理、KV缓存的动态分配与回收等——这使得实验结果更能反映实际部署场景中的收益。
在与当前最先进的自回归推测解码方法 EAGLE-3 的对比中,AdaptiveSpec 表现出色:
- 吞吐量提升最高达 56%
- 在 GSM8K、MATH-500 和 HumanEval 三大基准上,恢复了 93% 至完全无损 的任务准确率
- 覆盖三个主流目标模型:DeepSeek-R1-Distill-Llama-8B、Llama-3.1-8B-Instruct 和 Qwen3-8B
论文选用的这三个评测基准分别考察了不同维度的模型能力。GSM8K(Grade School Math 8K)包含约8000道小学数学应用题,主要评估多步算术推理能力;MATH-500是从MATH竞赛数学数据集中抽取的500道难题,涵盖代数、几何、数论等领域,对精确推理要求极高;HumanEval则是由OpenAI发布的代码生成基准,包含164个Python编程题,评估模型生成功能正确代码的能力。这三个基准的共同特点是都对输出的精确性有严格要求——数学题要求最终答案正确,代码题要求通过所有测试用例。
这组数据的含金量在于:56% 的吞吐量提升是在几乎不损失任务精度(最低93%、多数接近无损)的前提下取得的。有损推测并未以牺牲模型能力为代价,而是精准地"放行"了那些语义上无关紧要的差异。在这些对精确性要求极高的基准上仍能保持如此高的准确率恢复,有力地证明了margin规则的有损策略并未破坏模型的核心推理能力。
AdaptiveSpec的工程意义与未来展望
AdaptiveSpec 的价值不仅在于数字上的提升,更在于它揭示了一个重要方向:LLM推理加速的下一步突破口,可能不在于训练更好的草稿模型,而在于更聪明地利用解码过程中已有的内部信号。
"免训练"这一特性尤其值得关注。它意味着现有部署可以在不重新训练任何组件的情况下直接受益,大幅降低了工程落地的门槛。在实际的LLM服务中,训练或微调一个专用的草稿模型往往需要大量的计算资源和与目标模型配对的数据准备工作,而AdaptiveSpec完全绕过了这一步骤。同时,方法直接实现在生产级引擎 SGLang 上,也说明它并非实验室中的概念验证,而是具备实际部署潜力的工程方案。
当然,有损解码的"损失可接受度"仍取决于具体应用场景。对于代码生成、数学推理等对精度敏感的任务,93% 的准确率恢复是否满足需求,需要根据业务容忍度来权衡。但对于大量对延迟敏感、对细微差异不敏感的场景——如对话聊天、文本摘要、创意写作等——AdaptiveSpec 提供了一个颇具吸引力的"以微小精度换显著速度"的选项。
随着推测解码技术从静态走向自适应、从严格匹配走向边际容忍,LLM推理效率有望在未来迎来又一轮实质性突破。AdaptiveSpec所展示的"免训练+正交叠加"的设计哲学,也为后续工作提供了一个值得参考的技术范式:与其寻求单一维度的极致优化,不如识别出相互独立的优化轴,让它们的收益自然复合。
核心要点
核心要点
相关推荐
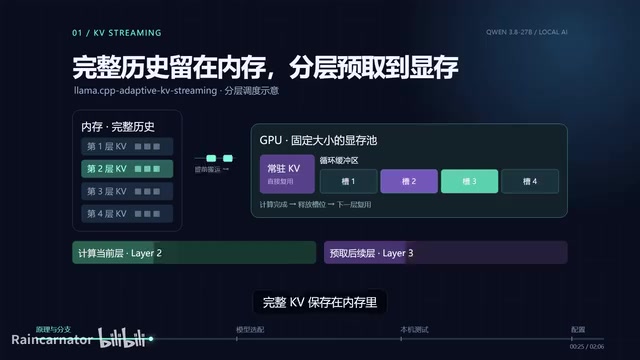
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。
用GPT和Grok搓出本地AI视频生成器,真能跑起来吗?
海外博主纯靠 GPT、Grok 和 Cursor,不写专业代码从零搭建本地 AI 视频生成应用,最终真的跑通了「威尔·史密斯吃意面」测试。本文拆解其构建全过程、14B 模型带来的质变,以及本地部署的现实门槛。