Agent读客户数据后,AI网关怎么选?

AI网关正从路由代理变为合规过滤器,四款方案选型需先验证PII剥离与审计颗粒度。
文章从一位开发者的Reddit求助帖出发,讨论当AI代理通过MCP读取客户数据时,AI网关如何承担PII剥离和工具调用审计两项法务硬性要求。作者分析了NeuralTrust TrustGate、Composio、TrueFoundry和LiteLLM四个候选方案的定位差异:TrustGate偏安全策略执行,Composio偏工具连接,TrueFoundry偏LLMOps平台复用,LiteLLM偏开源灵活但需自行实现脱敏与审计。核心分歧在于审计日志颗粒度能否满足取证要求,以及PII检测是否需要额外集成NER模型。文章建议团队先明确法务验收标准,再用模拟工单验证PII剥离效果、审计日志完整性和故障默认阻断策略,而非只看功能列表。
当AI代理被赋予读取客户数据的权限时,AI网关(AI Gateway)的选择就从技术选型问题变成了合规与安全的核心环节。最近,一位开发者在Reddit上发帖求助:团队准备通过MCP(模型上下文协议)让客服代理访问Zendesk和客户数据库的只读副本,法务部门只给两个硬性条件——到达模型前必须剥离PII(个人身份信息),以及每次工具调用都要有完整记录。他列出了四个候选:NeuralTrust TrustGate、Composio、TrueFoundry 和 LiteLLM,希望社区给出实战建议。
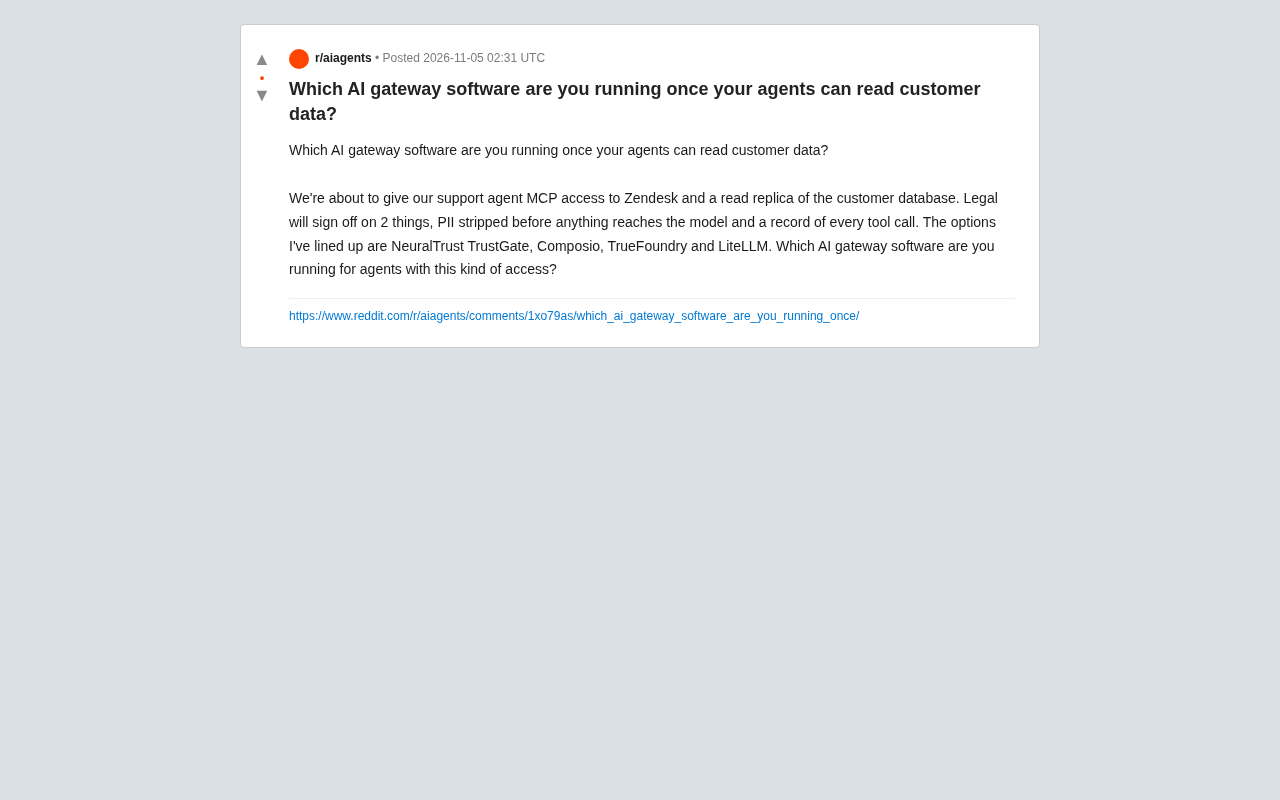
为什么AI网关成了刚需?
过去,AI网关多被看作模型调用的反向代理,负责路由、限流和成本统计。但当代理开始接触真实客户数据,网关的角色就变了:它必须成为数据出域前的最后一道过滤器和行为审计的黑匣子。法务的两个要求分别对应两个技术能力——PII检测与脱敏、工具调用的不可篡改日志。这意味着网关不能只是转发请求,还要在链路中执行策略、记录决策,并保证模型看到的已经是最小化后的数据。
发帖人的场景很典型:客服代理需要查询订单、读取用户信息来回答问题,但模型本身不应看到邮箱、电话、地址等敏感字段。如果在应用层做脱敏,容易遗漏或绕过;放在网关层,则能集中管控,对所有经过的MCP工具调用生效。
MCP(模型上下文协议) 是由 Anthropic 提出并开源的一种标准化协议,旨在让大语言模型以统一的方式连接外部工具和数据源。在 MCP 之前,每个 AI 应用要接入不同的 SaaS 工具(如 Zendesk、数据库、CRM)都需要编写定制的集成代码,导致重复劳动和安全策略难以统一。MCP 定义了客户端(AI 应用)与服务器(工具提供方)之间的通信规范,包括工具发现、调用参数、返回结果等。对本案例而言,MCP 使得客服代理能够以标准方式发起对 Zendesk 和客户数据库的调用,但也意味着所有工具调用都经过同一条链路——这正是网关可以集中执行 PII 脱敏和审计的位置。理解 MCP 是评估各候选网关是否原生支持该协议的前提。
四个候选方案各有侧重
从帖子里列出的选项来看,这四款产品覆盖了不同思路:
NeuralTrust TrustGate 定位是面向AI代理的安全网关,强调对代理行为的实时策略执行与可观测性,比较贴合“PII剥离+调用审计”的需求。
Composio 更偏向工具集成与代理连接层,提供大量预构建的工具连接器,MCP接入Zendesk这类场景可能是其强项,但PII治理能力需要额外确认。
TrueFoundry 是ML平台出身,网关能力偏向LLMOps,包括路由、监控、成本控制,适合已经使用其平台做模型部署的团队,合规策略可以复用平台能力。
LiteLLM 是开源代理网关,社区活跃、部署灵活,支持多种模型提供商和调用日志,但PII脱敏和细粒度审计需要自行配置或二次开发。
发帖人没有透露团队规模和技术栈,所以社区讨论集中在“谁真正在生产环境扛住了法务审查”上。
LLMOps(大语言模型运维) 是指围绕大模型应用全生命周期的一系列工程实践,涵盖模型部署、版本管理、提示词管理、路由与负载均衡、成本监控、质量评估和可观测性等。TrueFoundry 这类平台出身的网关,其优势在于将 AI 网关能力嵌入已有的 LLMOps 体系中,使合规策略可以与模型部署、监控面板复用同一套基础设施。但这也意味着选型时需评估团队是否已采用该平台——若仅为了网关功能而引入整套 LLMOps 平台,可能带来额外的运维负担和迁移成本。理解 LLMOps 的边界有助于判断“平台型网关”与“独立网关”的取舍。
自建还是采购?关键看审计颗粒度
从评论区(原帖信息有限)可以推断,这类选型的核心分歧在于:审计日志的颗粒度能否满足法务的取证要求。开源方案如LiteLLM的优势是数据完全可控,日志可以落到自己的存储里,但需要团队自己实现工具调用级别的结构化记录,并确保日志本身防篡改。商业网关如TrustGate和TrueFoundry通常开箱提供审计面板和策略模板,但数据要经过第三方,需要评估供应商的合规资质。
另一个隐性成本是PII检测的准确性。简单正则表达式不够用,真正可用的方案需要集成命名实体识别(NER)模型,并在网关层做低延迟推理。这会影响选型:如果网关本身不带PII检测,就要在架构里额外挂一个脱敏服务,链路变长、故障点增多。
命名实体识别(NER) 是自然语言处理中的一项基础任务,目标是从文本中定位并分类出人名、地名、机构名、邮箱、电话号码、地址等实体。在 PII 脱敏场景中,NER 模型需要在高吞吐、低延迟的网关链路中运行,对每条请求的文本进行实时扫描和替换。与正则表达式相比,NER 能识别出非结构化或变体形式的敏感信息(如“我的手机是幺三八…”),但也会带来误报和漏报的权衡。实际部署时通常采用“正则+NER”的混合策略:正则覆盖格式固定的字段(邮箱、身份证号),NER 处理自由文本中的姓名和地址。选择网关时需确认其 PII 检测是否内置 NER 能力、支持哪些语言、以及推理延迟是否在可接受范围内。
落地建议:先验证再绑定
对于同样面临“代理读客户数据”场景的团队,可以从三个维度做快速验证:
- PII剥离测试:用一批包含邮箱、电话、地址的模拟工单跑通整个链路,检查到达模型的请求中是否还残留敏感字段。
- 审计日志完整性:触发多次MCP工具调用,确认每次调用都有唯一ID、时间戳、工具名、入参摘要和调用结果,且日志不可被应用层修改。
- 故障降级策略:当PII检测服务不可用时,网关应当默认阻断还是放行?法务通常要求“默认阻断”,这需要在网关策略里明确配置。
发帖人的问题没有标准答案,但选型逻辑很清晰:先明确法务的验收标准,再用最小可行链路去测试每个候选方案,而不是只看功能列表。AI网关正在从“成本优化工具”演变为“合规基础设施”,这个转变值得每个让代理接触生产数据的团队认真对待。
(注:原帖未提供评论区具体反馈,本文基于帖子描述和产品公开定位分析,具体选型请以实际测试为准。)
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。