AI Agent到底学什么?先搭一张普通人的认知地图

用「四层认知地图」帮普通人理清AI Agent各类术语的真实位置与用途。
本文针对AI Agent学习者普遍面临的「名词堆积、不知从何下手」困境,提出应先建立认知地图而非死记术语。文章将提示词、RAG、知识库、记忆、插件、MCP、工作流、多智能体等概念,按「输入与指令、知识与记忆、能力与工具、编排与协作」四个层次重新归位,让每个名词都对应一个具体问题。同时强调,Agent落地前必须先自问能否交给它、如何验收、成本几何、数据是否安全,这些判断比技术本身更决定成败。文章面向非工程师读者,目标是让普通人能参与实际决策,而非立刻动手写代码。
刷到「大模型」「智能体」这些词之后,很多人卡住的第一个问题往往不是「哪个模型最强」,而是——AI Agent 到底要学什么?
提示词、RAG、工作流、插件、MCP、多智能体、记忆、知识库……这些词单独看每个都眼熟,合在一起却像散落在桌上的零件,认识却不知道机器怎么转,更不知道自己该从哪颗螺丝开始拧。这篇内容不比拼模型强弱,也不推荐平台,只解决一件事:帮一个普通人先搭好理解 Agent 的第一张地图。
为什么先要一张「认知地图」,而不是技术架构图
很多教程一上来就抛出术语表和架构图,结果学习者背了一堆名词,却依然不知道这些概念在解决什么问题。原始素材里给出的思路很清醒:这张地图不是技术架构图,也不是工程师的术语表,而是一张给普通人用的认知地图。
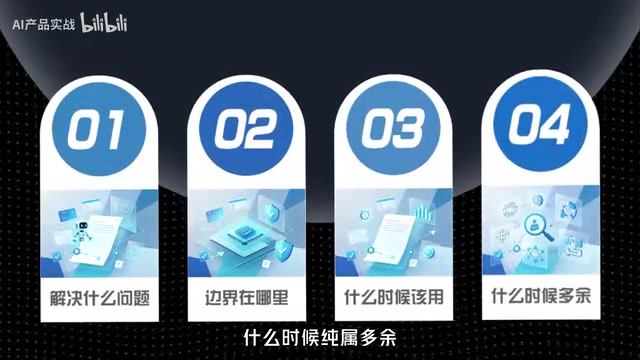
它的目的不是让你背名词,而是让你搞清楚三件事:每个概念背后到底在解决什么问题、它的边界在哪里、什么时候该用、什么时候纯属多余。换句话说,先建立「问题—工具」的对应关系,再去看具体技术,学习效率会完全不同。
这也解释了为什么很多人学 Agent 越学越乱:他们收集的是零件清单,而不是装配说明。零件再全,没有装配逻辑,机器依然转不起来。
地图的落点:回到真实工作场景
有意思的是,这张地图的目标并不是让你听完立刻去做一个 AI 产品,而是让你回到现实工作里,能看懂那些每天都会碰到的选择题。
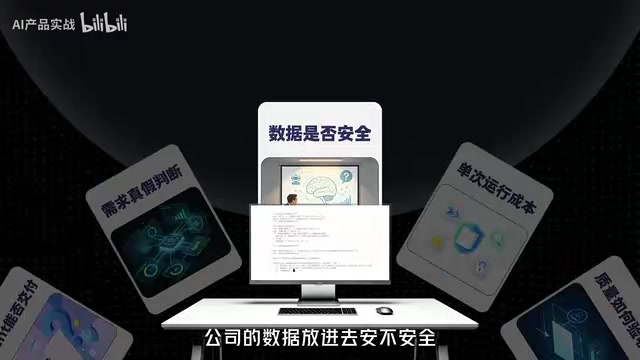
素材里列出了几个非常接地气的判断题,值得每一个想用 Agent 的人反复自问:
- 这个活到底能不能交给 Agent?
- 交给它以后,我怎么验收质量?
- 跑一次的成本是多少?
- 公司的数据放进去安不安全?
- 老板说的「搞个智能体」,到底是真需求还是喊口号?
这几个问题看似朴素,却恰恰是 Agent 落地时最容易翻车的地方。技术能不能做是一回事,值不值得做、可控不可控是另一回事。一张好的认知地图,应该能帮你在这几个维度上快速做出判断。
把散落的名词,重新安放到各自的「楼层」
地图搭好之后,再回头看那些吓人的术语,会发现它们其实各自站在不同的层级,解决不同的问题。
可以粗略地把这些概念理解为几个层次:
输入与指令层
提示词(Prompt) 决定你怎么和模型对话、如何把任务讲清楚。这是最基础、也最容易被低估的一层——很多「Agent 不好用」其实是指令没写清楚。
知识与记忆层
RAG、知识库、记忆 解决的是「模型不知道你的私有信息」和「模型记不住上下文」的问题。RAG 让模型能检索外部资料回答,知识库是这些资料的存放地,记忆则让 Agent 在多轮交互中保持连续性。
RAG(Retrieval-Augmented Generation,检索增强生成)的核心机制是:在模型生成回答之前,先从外部文档库中检索与问题相关的片段,再将这些片段作为上下文一并送入模型,让模型基于真实资料而非训练时记住的知识来回答。这解决了大模型两个根本局限:训练数据有截止日期,以及无法直接访问企业私有文档。知识库本质上是经过向量化处理的文档集合——文本被转换成高维数字向量存入向量数据库,检索时通过计算语义相似度而非关键词匹配来找到最相关内容。记忆机制则有短期与长期之分:短期记忆通常是把历史对话直接塞回上下文窗口,长期记忆则类似RAG,把重要信息存储后按需检索回来。理解这三者的区别,有助于判断一个Agent「记不住事情」时,问题到底出在哪一环。
能力与工具层
插件、MCP 解决的是「让模型能调用外部工具、真正动手干活」的问题。模型本身只会生成文字,插件和协议让它能查天气、调数据库、发邮件。
MCP(Model Context Protocol)是由Anthropic于2024年底提出的开放协议,目标是为大模型调用外部工具提供统一标准接口,类似于USB接口对硬件外设的意义——工具开发者只需按协议实现一次,所有支持MCP的模型客户端都能直接调用,无需为每个模型单独适配。在MCP出现之前,不同平台的插件生态各自为政(如OpenAI的Function Calling、各类RPA集成),开发者需要反复重写适配层。MCP试图打破这种碎片化局面,让工具调用变得像网页访问HTTP一样通用。对普通用户而言,MCP意味着Agent能接入的工具种类会越来越丰富,而开发者的重复劳动会显著减少;对企业而言,也意味着内部系统暴露给AI调用时需要评估相应的安全边界。
编排与协作层
工作流、多智能体 解决的是「复杂任务如何拆解、多个环节如何协同」的问题。工作流是把任务编排成固定流程,多智能体则是让多个角色分工合作。
当你能把每个名词对应到某一层、某一个具体问题上时,它们就不再是几十个互不相干的名字,而是一套有装配逻辑的系统。你也会更清楚:坑从哪里来,普通人又应该学到哪一步。
工作流与多智能体的核心区别在于「确定性」与「自主性」的权衡。工作流(Workflow)将任务拆解成固定的节点和流转规则,每一步做什么、结果传给谁都在设计阶段确定,执行时可预测、可审计,适合流程稳定、对准确性要求高的场景,比如合同审核、报告生成。多智能体(Multi-Agent)则是让多个各有专长的Agent动态分工协作,由一个「编排者」Agent根据任务情况临时决定调用哪个子Agent,执行路径在运行时才确定,灵活性更高但也更难掌控。实践中,「多智能体翻车」往往因为任务边界不清、Agent之间传递的信息失真累积,导致最终结果偏离预期。因此选型时,能用工作流解决的,通常不必引入多智能体的复杂度。
给普通学习者的启发
对大多数非工程师来说,学 Agent 的第一步不是急着上手写代码或搭系统,而是先建立这张认知地图。理由很实际:
- 避免被术语淹没:知道每个词解决什么问题,就不会为了追新名词而焦虑。
- 能参与决策:即便不亲自动手,也能判断一个 Agent 需求是否合理、如何验收、成本和数据风险在哪。
- 学习路径更清晰:先框架后细节,比零散地看教程效率高得多。
需要提醒的是,这份原始素材更偏「认知框架」而非具体操作教程,它擅长回答「学什么、怎么想」,但要真正落地,仍需要在每一层深入实践。把地图当成起点,而不是终点。
对于任何想进入 AI Agent 领域的人来说,先想清楚「这一层在解决什么问题」,往往比记住「这个工具叫什么名字」更重要。
相关推荐

通用AI模型直接操控机械臂,成功率远超专用策略
研究者提出智能体操作策略AMPs,让通用AI模型直接控制机械臂。AMP1框架在RoboLab-120零样本成功率达85.6%,远超VLA的49.2%和WAM的42.9%,真实世界108次试验成功104次,失败率降低20倍和15倍。

MLSys 2027审稿人尚未收到论文分配?社区讨论引关注
Reddit社区讨论MLSys 2027审稿人是否已收到论文分配。互惠审稿人反映尚未被分配论文,社区关注分配时间线及对评审工作的影响。

RTX 5060 Ti 16GB被抢购:AI热潮下的显卡新宠
Reddit社区热议RTX 5060 Ti 16GB显卡遭AI用户抢购,分析其显存优势、性价比及对市场的影响,探讨AI硬件需求新趋势。