持续学习新事实不遗忘:LoRA与自定义方法的四夜对决

四天持续学习实验显示LoRA严重遗忘,自定义方法保持稳定但细节未公开。
一项由Reddit用户发起的四天实验对比了LoRA与一种未公开方法在持续学习中的表现。LoRA在第一天新闻问答准确率达96%,但四天后暴跌至26.7%,数学能力GSM8K从69.6%降至4.4%;自定义方法则保持第一天知识90.7%的准确率,数学和通用能力与基线持平,但第二、三天新闻准确率降至约70%。实验采用预定义通过标准和严格评分器,问答数据已在Hugging Face公开,但自定义方法细节缺失。结果凸显了持续学习中可塑性与稳定性的矛盾,LoRA等简单微调难以避免灾难性遗忘。
大模型能否像人一样,每天吸收新知识而不忘记旧技能?一项持续四天的实验给出了残酷的对比:用LoRA微调学习当日新闻,模型在第二天还能答对96%的新问题,但四天后性能暴跌至26.7%,数学能力几乎归零;而另一种未公开的方法则让第一天的知识稳定在90%以上,数学和通用能力几乎无损。这项由Reddit用户fintanlabs发起的测试,数据集已公开在Hugging Face上,引发了关于持续学习与灾难性遗忘的讨论。
实验设计:四天新闻,每晚更新,反复拷问
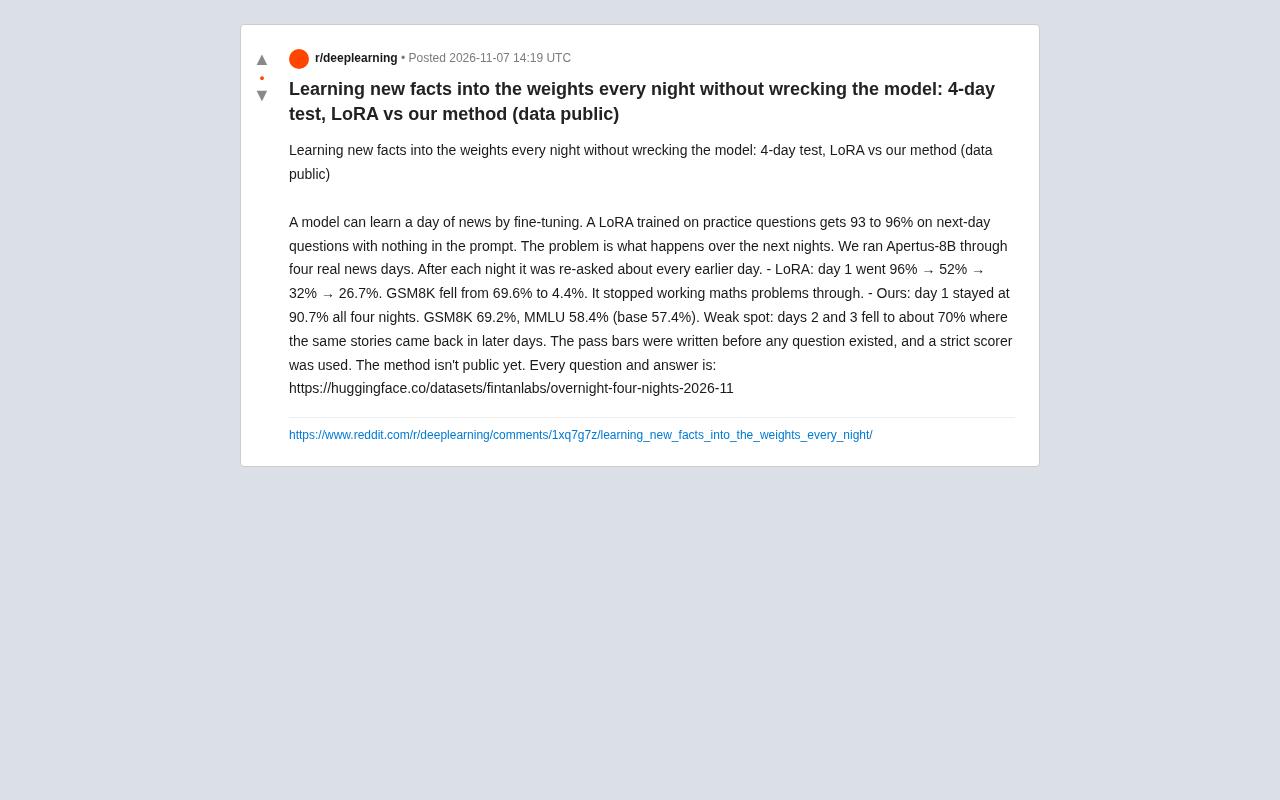
实验的核心是模拟“每晚将当天新闻事实写入模型权重”的场景。研究者选用Apertus-8B模型,连续四天用真实新闻数据微调。每天训练后,模型会被重新问及之前所有天数的新闻问题,以检验遗忘程度。通过标准(pass bar)在问题生成前就已确定,并采用严格的评分器,避免事后调整标准。所有问题和答案均已公开,保证了可复现性。
据Reddit原帖,测试聚焦于“次日问题”——即训练后第二天回答关于前一天新闻的提问。LoRA在第一天达到93%至96%的准确率,提示词中无需任何上下文。然而,随着夜晚更替,旧知识迅速瓦解。
Apertus-8B 是瑞士人工智能 Initiative 于2025年发布的开源大语言模型,参数规模80亿,支持多语言和长上下文。该模型基于完全透明的数据治理框架训练,权重和训练细节均公开,因此常被选为学术研究中的基线模型。在本实验中,选用Apertus-8B而非商业闭源模型,有利于复现和归因,但8B规模也意味着其知识容量和抗遗忘能力可能弱于更大模型,解读结果时需考虑这一因素。
LoRA的崩溃:新知识学会,旧能力丧失
LoRA(低秩适配)作为一种轻量微调方法,常被用于注入新知识。但实验数据显示,它在持续学习场景下存在严重缺陷。
第一天的新闻问答准确率从96%开始,经过第二、三、四晚的训练后,分别降至52%、32%和26.7%。更令人担忧的是,模型的数学推理能力(GSM8K)从69.6%暴跌至4.4%。这意味着模型在吸收新事实的同时,几乎完全丧失了解决数学问题的能力。原帖直言:“它不再会做数学题了。”
这种灾难性遗忘并非LoRA独有,但在此实验的设定下尤为突出。每次微调都覆盖了之前的权重调整,导致旧知识被快速冲刷。
LoRA(低秩适配) 是一种参数高效微调技术。其核心思想是冻结预训练模型的大部分权重,仅在每层注入两个低秩矩阵(A和B),通过训练这些小型矩阵来调整模型行为。由于秩(rank)远小于原始权重维度,LoRA可训练参数通常仅占全模型的0.1%-1%,大幅降低计算和存储开销。然而,这种低秩约束也意味着模型更新被限制在一个低维子空间中。在持续学习场景下,每次新任务训练都会覆盖之前的低秩矩阵,导致旧知识被快速冲刷——这正是实验中LoRA灾难性遗忘的结构性原因。
自定义方法:知识保持稳定,通用能力无损
与LoRA对比,研究者还测试了一种未公开的方法。该方法在四晚训练后,第一天的新闻问答准确率始终保持在90.7%。数学能力GSM8K为69.2%,与基线69.6%几乎持平;MMLU(大规模多任务语言理解)得分为58.4%,略高于基线的57.4%。这表明该方法在注入新知识的同时,有效避免了灾难性遗忘。
不过,该方法并非完美。原帖指出,在第二天和第三天的新闻上,准确率降至约70%,尤其是当相同故事在后续天数再次出现时。这可能是因为模型在处理重复信息时出现了干扰。研究者也强调,该方法尚未公开,因此无法独立验证。
GSM8K(Grade School Math 8K)是评估大模型数学推理能力的基准数据集,包含约8500道小学数学应用题,需要多步算术推理。MMLU(Massive Multitask Language Understanding)则涵盖57个学科的多选题,用于衡量模型的通用知识和推理能力。两者常被联合使用:GSM8K反映模型的链式推理能力,MMLU反映知识广度。实验中GSM8K从69.6%暴跌至4.4%,意味着模型几乎丧失了多步计算能力,而MMLU相对稳定则说明事实性知识受损较轻。
多源视角:社区热议与争议点
该实验在Reddit的MachineLearning板块发布后,引发了关于持续学习方法论的讨论。部分评论者认为,LoRA的崩溃并不意外,因为全参数微调本身就会导致灾难性遗忘,而LoRA的低秩约束可能加剧了这一问题。另一些人则质疑自定义方法的可复现性,毕竟代码未公开。
据Hugging Face数据集页面显示,所有问答对已公开,但方法细节缺失。有研究者指出,实验中的通过标准严格且预先定义,增加了结果的可信度。然而,由于缺乏同行评审,结论仍需谨慎看待。
启示:持续学习仍需突破
这项四天实验直观展示了当前大模型在持续学习中的两难:要么快速遗忘旧知识,要么新知识吸收不牢。LoRA的失败提醒我们,简单的微调策略难以应对动态知识更新。自定义方法虽表现更好,但其未公开的细节和第二天、第三天性能下降的问题,说明该领域仍有长路要走。
对于从业者而言,实验数据公开是积极信号。未来,如何平衡 plasticity(可塑性)与 stability(稳定性),将是模型持续学习的关键。或许,结合记忆回放、正则化或架构改进的方法,才能让模型真正“每晚学习而不崩溃”。
相关推荐
 科技前沿
Memorias:用AI传记作家把你的故事变成书
Memorias 是一款 AI 传记作家工具,通过对话式访谈将你的口述故事整理成回忆录,自动映射人物、地点与年份,支持照片与 EPUB/PDF/DOCX 导出,按次付费。
 科技前沿
mamitsu:让社交视频自动转成JSON的API与MCP
mamitsu是一款在Product Hunt上发布的API和MCP服务器,能将社交视频中的画面、音频和配文解析为JSON结构化数据,适用于食谱提取、产品信息抓取等开发者场景。
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today