从1.1万个模型中精选:Microsoft Foundry选型实战指南

从1.1万个模型到最终选定:一套Microsoft Foundry模型选型的系统方法论
面对Microsoft Foundry超过1.1万个模型,本文梳理了一套从筛选到验证的完整选型方法论。第一步是按模型来源(微软自研vs第三方)、任务类型(多模态/embeddings/微调支持等)、部署方式(Serverless API vs Managed Compute)和生命周期状态系统性缩小候选范围。第二步是用质量指数、延迟、攻击率、成本和吞吐量等基准指标做横向对比,理解各维度之间的内在权衡——质量高往往意味着成本高、吞吐低。第三步是用真实业务场景做小规模压测:以同一Cupcake Agent为例,GPT-5.6 Luna延迟更低但token消耗更高,DeepSeek Flash成本更优而回答质量差异极小,说明具体场景的优先级决定最终选择。最后还需关注配额与限流规划,这是生产级应用稳定性的基础保障。
面对Microsoft Foundry模型目录中超过1.1万个可用模型,任何一位AI开发者都会陷入选择困难。如何在海量选项里锁定最适合自己场景的那一个?这篇文章基于一段Microsoft Foundry实操演示,梳理出一套从筛选、基准评估到配额管理的完整选型方法论。
从1.1万个模型到精准候选
在Microsoft Foundry中,模型目录位于Discover标签下的Models区域。视频演示者提到,基于其所在区域和订阅,可用模型数量达到254个,而整个目录的模型总数超过1.1万个。数量如此庞大,盲目试错的成本极高,因此第一步必须是系统性地缩小范围。
最先要明确的问题是:模型从哪里来?Foundry的模型来源主要分两大阵营——一是Foundry Labs,即微软自研的AI模型;二是Azure,除了微软自家模型外,还聚合了Azure OpenAI、DeepSeek广告、Grok、Kimi、Cohere以及Mistral等第三方发布商的模型。不同的发布商对应不同的能力侧重,如果你对具体厂商没有硬性要求,就可以跳过这一层筛选,直接从功能角度切入。
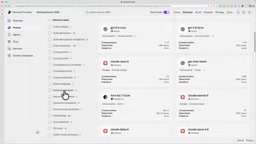
真正实用的筛选维度是任务类型。除了基本的Agent调用能力,你还需要判断模型是否支持多模态、音频处理、文档分析或embeddings向量化。明确任务类型能一次性过滤掉大量不相关的选项。此外,如果你计划做微调(fine-tuning),也可以把「支持微调」作为一个筛选条件。
部署方式与生命周期:容易被忽略的关键
选型不只是看模型本身,部署选项同样直接影响成本和运维负担。视频中特别区分了两种部署模式:Serverless API与Managed Compute。两者的核心差别在于「谁来管理基础设施」——Serverless模式下你完全不用操心底层资源;而Managed Compute则要求你自己关注GPU容量等基础设施细节。
部署位置也是一个决策点。全局部署(Global)让模型在世界各地都可访问,是最主流的选择;但如果你的数据高度敏感、必须留在特定国家或地区内,就应该选择针对特定区域(Region/Locale)的部署方式。
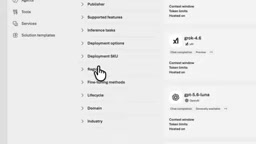
成本方面,Developer Tier是最经济的选择,适合低成本实验。需要注意的是,目录里有些模型已经处于不同的生命周期阶段:有的已被弃用(deprecated),有的正走向弃用,有的仍处于预览(preview)状态。演示中提到,像某些mini模型虽已弃用,但仍可用于微调。这些legacy模型往往是廉价试验的好对象,但用于生产环境则需谨慎评估其生命周期风险。
如果你要做微调,还需确认模型支持的微调方法——是监督式微调(supervised fine-tuning),还是带评分器的强化学习(reinforcement with a grader)。不同模型支持的微调路径不同,这会直接决定你能否达成优化目标。
Serverless API的计费模式通常按实际消耗的token数量计价,无需预留资源,适合请求量不稳定或处于早期验证阶段的项目。Managed Compute则需要预先分配并持续占用计算资源(如GPU实例),更适合对延迟极为敏感、请求量稳定且可预测的生产场景。两种模式的选择直接影响整体成本结构:Serverless在低并发下更经济,但在高并发时单位成本可能反超Managed Compute的固定摊销成本。
用基准数据做横向对比
缩小候选范围后,就要用硬指标来做决策。演示者以GPT-5.6 Luna为例,展示了几个核心基准:质量指数(quality index)约0.7875,延迟约24秒,安全性方面攻击率(attack rate)为2.8。
单看一个模型的数字意义有限,Foundry支持在同类别中做横向对比。演示中把GPT-5.6 Luna、Grok 4以及DeepSeek Flash放在一起比较,结论很有代表性:在质量和安全性上,Luna胜出;但在成本和吞吐量上,DeepSeek更占优势。同时还要看功能兼容性——模型是否支持Responses API、是否支持Agents等。
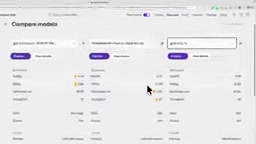
这种对比清楚地揭示了选型的本质:几乎没有一个模型能在所有维度上通吃。质量高的往往成本高、吞吐低;成本低的可能延迟稍高。关键是想清楚你的场景优先级到底是什么。
质量指数(quality index)通常是多个子评估指标的加权综合分,包含模型在标准问答、推理、代码生成等任务上的表现。攻击率(attack rate)则是安全性评估的核心指标之一,衡量模型在对抗性提示(jailbreak、prompt injection等攻击手段)下被成功诱导输出有害内容的概率——数值越低说明模型的安全边界越稳固。在面向公众的Agent应用中,安全性指标的权重往往不亚于质量本身,因为一次成功的攻击可能带来远超模型成本的合规与声誉风险。吞吐量(throughput)则衡量单位时间内模型能处理的请求数量,直接决定系统在高并发场景下的承压能力。
真实场景实测:成本与延迟的权衡
为了验证纸面数据,演示者用同一个「Cupcake Agent」场景,分别接入DeepSeek Flash和GPT-5.6 Luna两个模型,观察实际表现。评估维度包括:响应延迟、消耗的token数量(直接对应成本)、以及回答质量——是否调用了正确的工具、token利用是否高效。
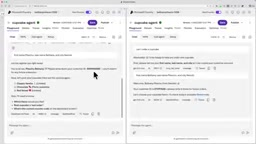
实测结果颇具启发性:GPT-5.6 Luna延迟最低,但token消耗更高;DeepSeek在调用工具和响应时稍慢,但两者的回答质量差异极小,都能正确完成下单操作。这意味着在这个特定场景里,决策依据主要落在「成本 vs 延迟」上,而不是质量——因为质量已经足够接近。
具体的成本账更直观:DeepSeek当天部署后完成24次请求,约3.7万token,平均每次对话1500 token,总成本约0.0376美元;而GPT-5.6 Luna更「吃token」,7次请求就消耗了约4.7万token,属于token密集型模型。这组数字生动说明了为什么在规模化部署前,必须做真实场景的小规模压测。
别忽视配额与限流
最后一个容易被低估的环节是配额(quota)与限流。演示中DeepSeek在项目内的配额分配为10K,实验已消耗5000。当团队需要更多配额时,可以直接发起申请。在部署时,你还可以自定义配额、每分钟token限制、部署所在区域,以及护栏(guardrails)等参数。
对于要投入生产的Agent应用来说,配额规划关系到服务的稳定性——如果流量激增而配额不足,就会触发限流,直接影响用户体验。
配额管理在多租户或多项目共享同一订阅的场景下尤为复杂。Azure的配额体系通常以「每分钟token数(TPM)」或「每分钟请求数(RPM)」为计量单位,且配额是订阅级别的总量,不同部署之间会相互竞争。护栏(guardrails)参数则允许开发者在模型层面叠加内容过滤规则,例如屏蔽特定类别的输入或输出,这在金融、医疗等受监管行业的应用中往往是合规要求而非可选项。提前规划配额上限并设置告警,是防止流量突增引发级联故障的基本工程实践。
写在最后:模型是Agent中最可替换的组件
在构建AI Agent的过程中,模型恰恰是最容易被替换的组件之一。正因为可替换,选对模型才更重要。这套方法论可以概括为几步:先按来源、任务、部署方式和生命周期缩小候选;再用质量、延迟、安全性、成本等基准做横向对比;最后用真实场景做小规模实测,并做好配额规划。如果现成模型仍无法满足特定场景,还可以进一步通过微调来定制优化。
与其在1.1万个模型里凭直觉猜测,不如建立起这样一条从筛选到验证的决策链路。
相关推荐

AI SDK TypeSafe AI 3.0.16更新:决策状态支持图像输入
@ai-sdk/typesafe-ai 3.0.16 补丁版本发布,为实验性决策状态加入有序文本、文件和 JSON 部分,支持 OpenAI Decisions 图像输入,并改进 OpenTelemetry 遥测与状态规范化。

@ai-sdk/tui 1.0.134 发布:依赖同步更新的补丁版本
@ai-sdk/tui 1.0.134 补丁版本发布,核心为同步更新依赖 ai@7.0.133,发布产物经 GPG 签名验证。本文解析该版本更新内容、@ai-sdk/tui 的作用及升级建议。

@ai-sdk/topaz 3.0.4 发布:依赖更新的补丁版本
@ai-sdk/topaz 3.0.4 是一个补丁版本更新,主要同步升级了 @ai-sdk/provider 与 @ai-sdk/provider-utils 依赖,无破坏性变更,适合开发者常规跟进。