从零构建 GraphRAG AI Agent:完整实战指南

本文介绍如何用知识图谱+向量双索引构建能跨文档多跳推理的本地GraphRAG Agent。
传统RAG在需要跨文档、多步推理的复杂问题上能力有限,GraphRAG通过在向量检索之外额外构建实体关系知识图谱来弥补这一短板。本教程展示了一套完整的本地化实现方案:用Gemma模型从文档中抽取三元组构建NetworkX有向图,同时用NOMIC embed text生成向量嵌入存入ChromaDB,形成"向量+图谱"双轨索引;通过FastMCP将向量混合检索、实体邻域查询、图上最短路径综合三种能力封装为可调用工具;编排器用小模型(Gemma 2B)做意图路由、大模型(Gemma 4)做推理合成;最终通过FastAPI暴露OpenAI兼容接口,接入OpenWebUI前端。实测表明,该架构能对"船舶交通如何破坏海洋生物外壳"等多跳推理问题给出有完整逻辑链的答案,是普通向量RAG难以实现的。
为什么需要 GraphRAG
传统 RAG(检索增强生成)在处理简单问答时表现不错,但面对需要跨文档、跨段落推理的复杂问题时往往力不从心。原视频用了一个形象的比喻:普通 RAG 就像一个“关键词高亮器”,它扫描文档匹配词汇,截取几个段落交给你。如果答案需要把第 2 页和第 20 页的线索组合起来,它常常会混淆甚至遗漏这种关联。
GraphRAG 则像一张“思维导图”。在回答之前,它会先读完文档,构建出由真实世界实体(人物、地点、化学物质、动物等)及其关系(导致、吃掉、流入等)组成的连接网络。当遇到复杂问题时,GraphRAG 顺着图谱上的连线,就能瞬间把分散在不同文档中的远距离事实串联起来。
这正是本教程要解决的核心场景——例如“船舶交通和繁忙的海洋航道如何最终破坏海洋生物的外壳?”这类需要多跳推理的问题,普通向量检索很难给出有逻辑链条的答案。
系统架构:从文档到答案的数据流
整套系统采用了双重索引(Dual Indexing)的设计思路,数据从 Python 脚本和 MCP 工具一路流向最终的前端界面。核心组件包括:
- 向量存储:文档被切分为带重叠的文本块(600 字符、100 字符重叠),用 NOMIC embed text 生成向量嵌入,存入 ChromaDB。
- 知识图谱:使用 Gemma 模型抽取「实体-关系-实体」三元组,构建成 NetworkX 的有向图(DiGraph),持久化为
graphstore.json。 - 服务层:OpenWebUI 向运行在 8000 端口的 FastAPI 服务发送请求负载。
这种“向量 + 图谱”的双轨制是 GraphRAG 区别于传统方案的关键。向量索引负责语义相似度匹配,图谱索引负责结构化的关系推理,两者互补。
MCP(Model Context Protocol) 是 Anthropic 于 2024 年推出的开放协议,旨在标准化 AI 模型与外部工具、数据源之间的交互方式。可以把它理解为 AI 世界的"USB 接口"——工具开发者只需按协议暴露接口,任何兼容 MCP 的 Agent 框架都能即插即用地调用这些工具,无需为每个平台单独适配。FastMCP 是其 Python 实现库,大幅简化了将普通 Python 函数注册为 MCP 工具的流程。在本系统中,三种检索能力(向量搜索、实体查询、路径综合)正是通过 FastMCP 封装后,才能被编排器作为结构化工具统一调度。
NetworkX 是 Python 生态中最主流的图分析库,支持有向图(DiGraph)、无向图、多重图等多种图结构,并内置了最短路径、连通性分析、中心性计算等大量图算法。本系统选用有向图存储「实体→关系→实体」三元组,有向性确保了"A 导致 B"与"B 导致 A"被视为不同的边;而在路径综合场景中,系统临时将其视为无向图,以便发现双向的隐含联系。
文档摄取与索引脚本
第一个核心脚本负责把本地文档加工成双重索引系统。它的工作流程清晰:
- 定义目录位置和模型名称(Gemma 负责 LLM 任务,NOMIC embed text 负责嵌入),初始化位于
/chroma_db的持久化 ChromaDB 向量集合。 - 遍历
/documents目录,读取所有.txt和.md文件为文档对象。 - 将文本片段以 零温度(temperature=0) 发送给 Gemma,通过 Ollama 抽取结构化的 JSON 三元组列表(source、target、relation)。
这里的温度参数值得一提:温度控制 LLM 生成文本的随机性与创造性。低温度产出更可预测、精确、符合事实的答案——对于实体抽取这类需要准确性的任务,零温度是合理选择。
对每个文本块,脚本会同时做三件事:生成并 upsert 向量嵌入到 ChromaDB、抽取三元组并把节点和边加入 NetworkX 有向图、最终把完整图结构导出到 graphstore.json。
三大检索工具:MCP 的角色
第二个脚本基于 FastMCP,把三种检索能力封装成可供下游 AI Agent 调用的工具:
向量混合检索(Vector Search)
使用预计算的查询嵌入向量在 ChromaDB 中做相似度搜索,返回 top-K 匹配的文档段落及文件元数据。适合处理非结构化的语义查询。
实体查询(Entity Lookup)
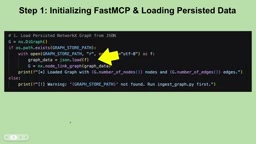
在 NetworkX 图中用大小写不敏感的子串匹配定位目标节点,收集该节点所有直接的入向和出向关系,总结其在知识图谱中的邻域。
路径综合(Path Synthesis)
这是最能体现 GraphRAG 威力的功能。它把图视为无向图,计算实体 A 与实体 B 之间的最短路径,找出直接或多跳的连接关系,再生成对二者关联的解释。
多跳推理(Multi-hop Reasoning) 指回答一个问题需要经过两个或更多中间推理步骤,每一步的结论成为下一步的输入。例如,要回答"船舶交通如何破坏海洋生物外壳",系统需要先知道"船舶交通产生噪音和污染物",再知道"污染物导致海水酸化",最后才能推出"酸化海水溶解生物外壳中的碳酸钙"。这条推理链跨越了多个文档片段,单次向量相似度检索只能找到与问题措辞最接近的段落,无法自动串联中间节点。知识图谱的最短路径算法天然适合这类任务:它能在图中遍历中间节点,将分散的事实连接成完整的因果链。
智能路由:意图分类与多模型协作
第三个脚本是 Agent 的大脑——GraphRAG 帮助台编排器(Orchestrator)。它导入前面创建的 MCP 工具,并实现了一套双模型协作机制:
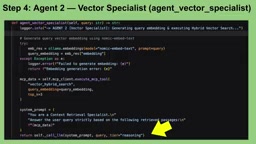
- 快速模型(Gemma 2B):负责意图路由。意图路由器分析用户请求,将其归类到四条执行路径之一——
vector_search、entity_lookup、path_synthesis或general。 - 推理模型(Gemma 4):负责复杂任务和最终答案合成,并带有自动降级的错误处理。
不同意图走不同处理分支:语义查询走向量混合检索,实体类问题解析出目标实体名调用图谱邻域查询,关系类问题则抽取出实体对调用路径综合。这种“先分类、再专项处理”的设计,让每种问题都能被最合适的工具处理。
使用两个不同规模模型分工协作(2B 参数做路由、4B/更大模型做推理)是一种经典的**级联推理(Cascading Inference)**策略,核心逻辑是"用最小的计算成本完成分类,再将资源集中于真正需要推理的步骤"。意图分类任务本质上是一个四分类问题,语义模式固定,小模型完全能胜任,且延迟更低;而综合多路检索结果、生成有逻辑链条的答案则需要更强的上下文理解与文本生成能力。这种设计在工程实践中也带来了可观测性的好处:意图分类结果可以被记录和监控,当系统误判查询类型时,开发者能快速定位是路由层还是执行层出了问题。
FastAPI 封装与 OpenWebUI 集成
最后一个脚本把 GraphRAG Agent 包装成一个兼容 OpenAI 接口的 FastAPI 服务。它的职责包括:
- 配置 Pydantic 请求模型,实例化编排器(Gemma 4 处理复杂任务,Gemma 2B 处理快速路由)。
- 解析 OpenAI 兼容的消息数组,提取用户文本提示,并把 base64 编码的图片 URL 解码为临时本地文件以支持视觉处理。
- 暴露 OpenAI 风格的端点,列出
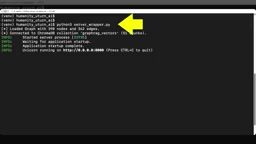
graphrag_router_agent模型,让 OpenWebUI 等前端能发现并选择这个 Agent。 - 用 Uvicorn 在
0.0.0.0:8000运行应用,处理来自本地或 Docker 客户端的 HTTP 请求。
前端方面,OpenWebUI 运行在 3000 端口的 Docker 容器中,只需配置使用 GraphRAG Agent 即可开始对话。
实战效果:多跳推理的力量
教程用几个有趣的问题验证了系统能力。面对“船舶交通和繁忙航道如何破坏海洋生物外壳?”这类问题,快速模型先抽取出关键实体(船舶交通、海洋航道、海洋生物外壳),路径专家查询图谱遍历中间节点,推理模型最终把检索到的图谱连接综合成一条逻辑因果链——归纳为急性创伤、慢性退化和系统性削弱三类。
另一个问题“太平洋的乌贼与大西洋的墨西哥湾暖流之间是否存在隐藏联系?”同样展示了跨文档分析的能力。这些答案是普通 RAG 难以给出的,因为它们需要连接分散在不同文档中的事实。
技术栈总结
这套方案的技术选型颇具代表性,适合本地化部署的 AI Agent 实践:
- 嵌入模型:NOMIC embed text
- LLM:Gemma(快速路由用 2B,推理合成用 4)
- 向量库:ChromaDB
- 图谱:NetworkX DiGraph
- 工具协议:FastMCP
- 服务框架:FastAPI + Uvicorn
- 前端:OpenWebUI
整体架构清晰地展示了如何把向量检索与知识图谱结合,构建一个具备真正推理能力的 AI Agent。对于想在私有文档上实现复杂问答的开发者,这是一条值得参考的完整路径。
相关推荐

UnleashX:像雇人一样雇佣AI员工,对话直接交付成果
UnleashX在Product Hunt上线,主打像雇人一样雇佣AI员工:选角色、连CRM和工具、设规则,端到端执行工作流,人类仅在必要时介入。本文分析其产品定位、配置逻辑与人机协作边界。

Cedric AI:替你开会讲PPT的AI代理
Cedric AI 是 Product Hunt 上发布的会议 AI 代理,能替你进入 Zoom、Meet、Teams 会议演示幻灯片、用实时数据回答问题,并在会后生成待审批的笔记与跟进事项。本文解析其三层能力、差异化设计与适用场景。

Display 1.0:任何Agent都能建文档和应用
Display 1.0 在 Product Hunt 上线,主打用任何 Agent 在同一个工作空间创建文档、原型和应用,通过 Spaces 与 Folders 组织内容并沉淀为团队知识库,采用统一价格模式。