DRET:蒸馏式嵌入迁移让轻量模型逼近生物医学专家级性能

大模型的性能与部署困境
在生物医学自然语言处理(NLP)领域,BioBERT、ClinicalBERT 等领域专用大模型早已展现出强劲的任务表现。BioBERT 是在 Google 的 BERT 基础架构上,使用 PubMed 摘要和 PMC 全文文章进行继续预训练的模型,其训练语料超过数十亿词元,使其能够捕捉"心肌梗死""单克隆抗体"等专业术语的深层语义关系。BERT(Bidirectional Encoder Representations from Transformers)由 Google 于 2018 年发布,是基于 Transformer 编码器的预训练语言模型,其核心创新在于采用双向注意力机制,通过遮蔽语言模型(MLM)和下一句预测(NSP)两个预训练目标在大规模无标注文本上学习通用语言表示。BERT-base 包含 1.1 亿参数(12 层、768 维隐藏层、12 个注意力头),这一预训练-微调范式彻底改变了 NLP 的研究格局,使得在特定任务上只需少量标注数据微调即可获得优异性能。
BERT 的底层架构——Transformer——由 Vaswani 等人在 2017 年的论文《Attention Is All You Need》中提出,彻底取代了此前主导序列建模的循环神经网络(RNN)和长短期记忆网络(LSTM)。其核心创新是自注意力机制(self-attention),允许模型在处理每个词元时同时关注输入序列中的所有其他位置,从而高效捕获长距离依赖关系。自注意力的计算复杂度为 O(n²·d),其中 n 为序列长度,d 为隐藏维度。多头注意力(multi-head attention)则将注意力计算拆分为多个并行的子空间,让模型能同时关注不同类型的语义关系——例如,一个注意力头可能捕获语法依存关系,另一个可能捕获共指关系。正是 Transformer 强大的表示能力为 BERT 及其后续变体奠定了架构基础。
ClinicalBERT 则进一步在 MIMIC-III 等电子病历数据上训练,掌握了临床缩写(如"prn"代表按需给药)和非标准书写模式。MIMIC-III(Medical Information Mart for Intensive Care III)是由 MIT 计算生理学实验室维护的大型去标识化电子健康记录数据库,包含 2001-2012 年间 Beth Israel Deaconess Medical Center 重症监护病房约 4 万名患者的临床数据,涵盖人口统计信息、生命体征、实验室检查、临床笔记、影像报告和出院摘要等。由于临床笔记充斥大量缩写、拼写错误、非标准语法和特定领域的叙述模式,MIMIC-III 成为训练临床 NLP 模型最重要的开放数据资源之一。这些模型通过在海量生物医学语料上的预训练,掌握了专业术语、临床语义乃至复杂的医学推理线索,能够胜任诸如 PICO(Population 人群、Intervention 干预、Comparison 对照、Outcome 结局)分类这样的高难度任务。
PICO 是循证医学(Evidence-Based Medicine)的基石框架,由 David Sackett 等人在 1990 年代系统化提出。循证医学将临床证据按可靠性分为多个层级,形成所谓的"证据金字塔"——从底部到顶部依次为:专家意见、病例报告、病例对照研究、队列研究、随机对照试验(RCT),以及位于金字塔顶端的系统综述和 Meta 分析。RCT 通过随机分组消除选择偏倚,是评估干预措施有效性的金标准研究设计;Meta 分析则通过统计方法合并多个独立研究的结果,提供更高统计效力的综合估计。PICO 框架贯穿了从提出临床问题到检索和评价证据的整个过程。研究人员在进行系统性文献综述时,需要从数千篇临床试验论文中准确识别出每篇文章描述的受试人群特征(P)、实验干预措施(I)、对照组设置(C)以及临床结局指标(O)。传统上这一工作完全依赖人工标注,一篇 Cochrane 系统综述的文献筛查往往需要数月时间。Cochrane 协作网是全球最权威的循证医学组织之一,其系统综述被视为医学证据金字塔的顶层。一篇标准的 Cochrane 系统综述需要制定检索策略、在多个数据库(PubMed、Embase、CENTRAL 等)中检索文献、由至少两名独立审阅者筛查标题/摘要及全文、提取数据、评估偏倚风险并进行 Meta 分析,整个过程通常涉及筛查数千至数万篇文献,仅文献筛查阶段就可能耗费数百人时。将 PICO 分类自动化,尤其是在词级(token-level)精度上实现,意味着可以精确定位文本中哪些词语描述的是人群信息、哪些是干预信息,这对加速系统综述流程具有变革性意义。
然而,强性能的背后是高昂的计算成本。这些动辄上亿甚至数亿参数的模型(参数量通常在 1.1 亿至 3.5 亿之间,推理时单条文本的 GPU 显存占用可达数 GB 级别),在真实医疗场景(如医院信息系统、边缘设备、批量文献筛查流水线)中往往难以落地——推理延迟、显存占用与部署费用都是实实在在的障碍。
与之相对,DistilBERT 这类通用轻量模型体积小、速度快,却缺乏专业领域知识,在 PICO 分类等特化任务上表现平平。DistilBERT 由 Hugging Face 的 Sanh 等人于 2019 年提出,是通过知识蒸馏将 BERT-base 压缩至 6 层、6600 万参数的轻量模型。其蒸馏过程使用了三重损失函数:蒸馏损失(模仿教师模型的软标签分布)、遮蔽语言模型损失、以及余弦嵌入损失(对齐师生模型的隐藏状态方向)。最终 DistilBERT 在保留 BERT 97% 语言理解能力的同时,将推理速度提升 60%,模型体积缩减 40%,使其成为资源受限场景下的首选基线模型。如何在不牺牲效率的前提下,把大模型的领域知识"搬进"小模型? 这正是 DRET(Distilled Rapid Embedding Transfer,蒸馏式快速嵌入迁移)想要解决的核心问题。
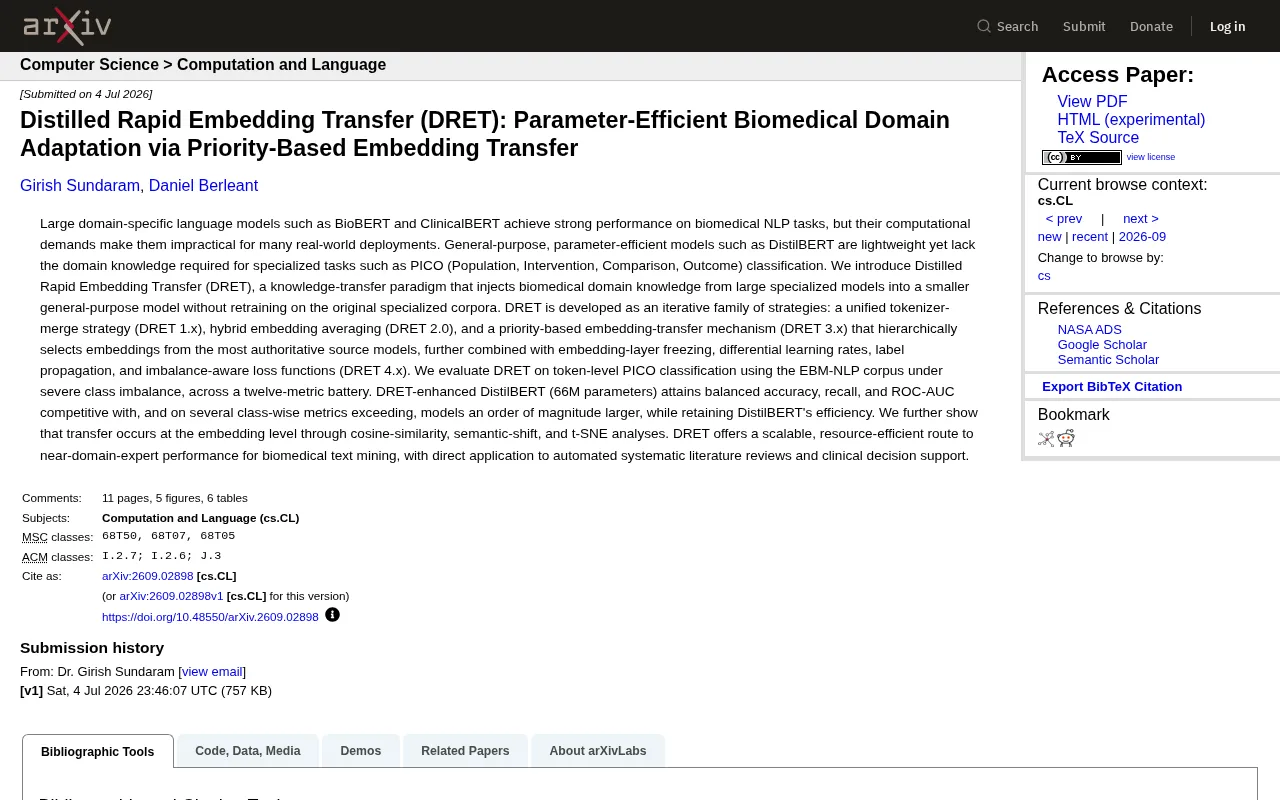
DRET 的核心思路:绕过重训练的嵌入级知识迁移
DRET 是一种知识迁移范式,其最大亮点在于:它能够将大型专用模型中的生物医学领域知识,注入到更小的通用模型中,而无需在原始专业语料上重新训练。
这一点意义重大。传统的领域适配通常需要在专业语料上做继续预训练或全量微调,成本高、周期长,还依赖原始数据的可得性。而 DRET 把知识迁移的焦点放在了嵌入层(embedding level)——它直接在词向量空间做"移植手术",让轻量模型获得接近领域专家的语义理解能力。词嵌入矩阵(embedding matrix)是 Transformer 模型的第一层参数矩阵,维度为 V×d,其中 V 为词表大小,d 为隐藏维度(如 BERT 中为 768)。该矩阵将离散的词元 ID 映射为稠密的实值向量,经过预训练后,语义相近的词元在向量空间中距离较近(如"心脏"与"心肌"),语义无关的词元距离较远。嵌入矩阵本质上编码了模型对整个词汇表的"第一印象"——所有下游 Transformer 层的计算都建立在这一初始表示之上,因此嵌入层的质量对模型最终性能具有基础性影响。
值得进一步理解的是,高维嵌入空间具有一些反直觉的几何特性。所谓"维度诅咒"现象意味着:在高维空间中,随机选取的两个点之间的距离趋向于集中在某个均值附近,距离度量的区分度会降低。这意味着在 768 维的 BERT 嵌入空间中,有意义的语义聚类和分离实际上是模型通过训练"雕刻"出来的结构,而非自然涌现的。DRET 的嵌入迁移本质上是在这个高维空间中进行精准的几何重构——将词元向量从通用语义位置"搬运"到领域特定的语义区域,同时保持整体空间的拓扑一致性,这一过程的精妙之处在于它既要改变局部结构又要维护全局几何关系。
值得注意的是,DRET 的方法与传统知识蒸馏(Knowledge Distillation)存在本质区别。传统知识蒸馏由 Hinton 等人在 2015 年提出,其核心思想是让学生模型模仿教师模型的软标签输出(soft logits),即学习教师模型对每个类别赋予的概率分布,而非仅学习硬标签。具体而言,蒸馏时引入温度参数 T 对 softmax 进行缩放,较高的温度使概率分布更平滑,暴露出教师模型对各类别之间相对关系的判断——这种隐含在概率分布中的类间关系信息被 Hinton 称为"暗知识"(dark knowledge)。后续研究将蒸馏扩展到中间层特征匹配(如 PKD、TinyBERT)、注意力矩阵匹配等多种形式,形成了丰富的模型压缩技术生态。然而,这些方法都需要教师模型在线推理或预先生成全部训练样本的输出,计算开销仍然可观。DRET 所采用的嵌入级迁移则完全不同:它直接操作词嵌入矩阵(embedding matrix),将教师模型训练好的词向量"移植"到学生模型中,无需教师模型参与推理过程。这种操作本质上是一次性的矩阵替换与对齐,计算成本极低。
换言之,DRET 不是把整个大模型压缩下来,而是精准地把最有价值的"语义资产"——嵌入表示——转移过去。这种做法在资源受限的生物医学 NLP 场景下极具吸引力。
迭代演进:从分词合并到优先级迁移
DRET 并非单一方法,而是一个迭代式的策略家族,作者按版本号清晰地展示了其演进逻辑:
DRET 1.x:统一分词器合并
第一代策略聚焦于分词器合并(tokenizer-merge)。由于不同模型的词表(vocabulary)存在差异,专业模型往往包含大量生物医学专有词元。不同预训练模型使用不同的子词分词算法(如 WordPiece、BPE、Unigram),导致词表存在显著差异。
这三种主流子词分词算法各有特点:WordPiece 由 Google 开发,从字符级别开始逐步合并高频字符对,最终构建固定大小的词表,BERT 系列模型均采用此方案;BPE(Byte Pair Encoding)最初是一种数据压缩算法,被 Sennrich 等人于 2016 年引入 NLP,通过统计相邻符号对的频率迭代合并,GPT 系列模型采用此方案;Unigram 模型则采用相反的策略,从一个大词表出发逐步剪枝低概率词元,SentencePiece 框架中常用此方法。这三种算法的差异导致同一文本在不同模型中的分词结果可能完全不同——这正是跨模型嵌入迁移必须首先解决的基础性障碍。
例如,DistilBERT 使用的通用 WordPiece 词表可能将"metformin"(二甲双胍)拆分为"met"+"for"+"min"三个子词,而 BioBERT 的词表由于在生物医学语料上构建,可能将其保留为完整词元。这种分词粒度的不一致使得嵌入空间无法直接对齐——同一个医学术语在两个模型中对应完全不同的向量集合。DRET 1.x 通过统一分词器合并词表,解决了这一基础性障碍,确保源模型和目标模型能在统一的词元粒度上进行嵌入映射,为后续的嵌入对齐打下基础。
DRET 2.0:混合嵌入平均
第二代引入混合嵌入平均(hybrid embedding averaging),即将来自不同源模型的嵌入进行加权融合,让轻量模型的词向量兼具通用性与领域性。
DRET 3.x:基于优先级的嵌入迁移
这是方法论上的关键跃迁。DRET 3.x 提出优先级迁移机制(priority-based embedding-transfer),以层级化的方式,从最权威的源模型中挑选嵌入。对于每一个词元,系统会判断哪个源模型对它的表示最"可信",从而做出最优选择,而非简单平均。这种策略背后的直觉是:对于"randomized controlled trial"这样的通用学术词汇,通用模型的嵌入可能已经足够好;而对于"bevacizumab"(贝伐珠单抗)这样的专业药物名称,生物医学模型的嵌入则更具权威性。优先级机制使得每个词元都能获得最合适的嵌入来源。
DRET 4.x:工程化组合拳
最新一代在优先级迁移的基础上,叠加了一整套训练技巧:
- 嵌入层冻结(embedding-layer freezing):保护迁移来的高质量嵌入不被后续训练破坏。其核心逻辑是:迁移而来的嵌入已经编码了高质量的领域语义信息,如果在下游微调时允许梯度回传到嵌入层,这些精心迁移的知识可能被任务特定的梯度信号覆盖,产生所谓的"灾难性遗忘"现象。灾难性遗忘是神经网络领域的经典问题,最早由 McCloskey 和 Cohen 在 1989 年提出——当神经网络在新任务上训练时,权重更新可能大幅覆盖先前学到的知识,导致旧任务性能急剧下降。常见的对抗策略包括弹性权重巩固(EWC,通过 Fisher 信息矩阵识别对旧任务重要的参数并限制其更新幅度)、渐进式神经网络(为新任务分配新的网络列同时保留旧列),以及 DRET 所采用的层冻结方案——简单直接且计算零开销。
- 差分学习率(differential learning rates):对不同层采用不同的学习速度。这一技术由 Howard 和 Ruder 在 ULMFiT(Universal Language Model Fine-tuning)中推广,其思想是 Transformer 的不同层捕获不同抽象层次的特征——底层捕获词法和句法信息,顶层捕获任务相关的语义信息——因此底层应使用较小的学习率以保留通用特征,顶层使用较大的学习率以快速适配下游任务。嵌入层冻结与差分学习率结合,形成了对迁移知识"保护性微调"的完整策略。
- 标签传播(label propagation):缓解标注稀缺问题。标签传播是一种半监督学习方法,由 Zhu 和 Ghahramani 于 2002 年提出,其核心思想是利用数据的图结构(通常基于特征相似度构建 k 近邻图),将已标注数据的标签信息沿图的边传播到未标注数据点。在 NLP 场景中,语义相近的词元在嵌入空间中距离较近,标签传播可以利用这种邻近关系将少量人工标注扩展到更大规模的数据上。结合 DRET 迁移后质量更高的嵌入表示,标签传播的效果可以进一步提升。
- 不平衡感知损失函数(imbalance-aware loss):应对严重的类别不平衡。在严重类别不平衡场景下,标准交叉熵损失会导致模型偏向多数类。常见的不平衡感知损失函数包括加权交叉熵(按类别频率的倒数加权)、Focal Loss(Lin 等人 2017 年提出,通过 γ 参数降低易分类样本的损失贡献,使模型聚焦于难分类的少数类样本),以及 Dice Loss(源自医学图像分割领域,直接优化 F1 分数的可微近似)。在 PICO 分类中,背景文本词元可能占总词元的 70-80% 以上,采用不平衡感知损失可以显著提升对 P、I、O 少数类词元的召回率。
这套组合拳共同构成了 DRET 完整的工程解决方案。
实验结果:66M 参数媲美十倍体量的大模型
研究团队在 EBM-NLP 语料上,针对词级(token-level)PICO 分类任务评估了 DRET,并特别关注了该任务下严重的类别不平衡这一现实挑战。EBM-NLP(Evidence-Based Medicine Natural Language Processing)语料库由 Nye 等人构建,包含约 5000 篇随机对照试验(RCT)的摘要,每个词元被标注为 P、I、O 三类之一或标注为非 PICO 类别。该数据集的核心挑战在于严重的类别不平衡:绝大多数词元属于"非 PICO"类别(即背景文本),而真正属于 P、I、O 的词元占比很小,且三者之间也存在显著的数量差异。
类别不平衡不仅影响模型训练,还会深刻扭曲评估指标的信息量。在 PICO 分类中,如果 80% 的词元为非 PICO 类别,一个总是预测"非 PICO"的朴素分类器就能获得 80% 的准确率——这个数字看似不错,但实际的临床价值为零。这就是为什么研究者需要使用更精细的评估指标:平衡准确率(每个类别准确率的算术平均,消除类别数量差异的影响)、宏平均 F1(对每个类别独立计算精确率和召回率的调和均值后取平均)、ROC-AUC(衡量模型在所有分类阈值下的排序能力,对类别分布不敏感)等。此外,Matthews 相关系数(MCC)也是处理不平衡场景的优质指标,它同时考虑了混淆矩阵中的真阳性、真阴性、假阳性和假阴性四个元素,在所有类别分布下都能给出信息量充足的评价。研究团队采用了多达十二项指标的"指标矩阵",力求全面客观地评估模型在不平衡条件下的真实能力。
结果令人瞩目:经过 DRET 增强的 DistilBERT(仅 6600 万参数),在平衡准确率、召回率、ROC-AUC 等核心指标上,达到了与体量大出一个数量级的生物医学专用模型相当的水平,在若干分类别指标上甚至实现了超越——同时完整保留了 DistilBERT 原有的推理速度和部署优势。
这意味着,在实际部署中,用户可以用小模型的成本,换取接近大模型的效果。
知识迁移的可解释性验证
为了验证"知识确实发生在嵌入层"这一核心假设,作者提供了多角度的可解释性证据:
- 余弦相似度(cosine-similarity)分析:量化迁移前后词向量的空间变化,计算同一词元在迁移前后的向量夹角变化,从而精确度量嵌入被"改写"的幅度。余弦相似度衡量的是两个向量方向上的一致性(值域为 -1 到 1),在高维嵌入空间中,即使很小的余弦距离变化也可能对应显著的语义差异。
- 语义漂移(semantic-shift)分析:观察词元语义如何向专业方向偏移,追踪特定医学术语在嵌入空间中向专业语义方向的位移量。例如,观察"trial"一词在迁移后是否从通用语义(审判、尝试)向临床试验语义方向偏移,以及偏移的幅度是否与该词在生物医学语料中的特异性成正比。
- t-SNE 可视化:直观展示嵌入空间中类别的可分性提升。t-SNE(t-distributed Stochastic Neighbor Embedding)是 Laurens van der Maaten 于 2008 年提出的非线性降维技术,特别擅长将高维数据(如 768 维的 BERT 嵌入向量)映射到二维平面上进行可视化,同时尽可能保留数据点之间的局部邻域结构。其核心原理是:在高维空间中用高斯分布建模点对之间的相似度,在低维空间中用更重尾的 t 分布建模对应关系,然后通过最小化两个分布之间的 KL 散度来求解低维映射。选择 t 分布而非高斯分布来建模低维空间的关键优势在于:t 分布的重尾特性能够缓解"拥挤问题"——即在低维空间中为中等距离的点对提供更大的表示空间,使得不同簇之间的分离更加清晰。在 DRET 的验证中,t-SNE 可视化能够直观展示:迁移前,不同 PICO 类别的词元嵌入在二维空间中高度混叠、难以区分;迁移后,同类词元聚集成更紧密的簇,不同类别之间出现更清晰的决策边界。
三者共同构建了嵌入级知识迁移的完整可解释性证据链,表明 DRET 的知识迁移不是黑箱式的"碰运气",而是在嵌入空间中发生了可观测、可解释的语义重构。
应用前景:从生物医学到更多垂直领域
DRET 为生物医学文本挖掘提供了一条可扩展、资源高效的路径,让轻量模型逼近领域专家级性能。其最直接的应用场景包括:
- 自动化系统性文献综述:在海量医学论文中快速识别并结构化 PICO 要素,大幅提升循证医学研究效率。考虑到一篇高质量的 Cochrane 系统综述通常需要团队花费 6-18 个月进行文献筛查和数据提取——整个流程涉及制定检索策略、多数据库检索、双人独立筛查、数据提取、偏倚风险评估和 Meta 分析——PICO 自动分类的准确实现有望将这一周期压缩数倍,从根本上改变循证医学的生产效率。
- 临床决策支持:在算力受限的医疗环境中提供快速、准确的文本分析能力。许多基层医疗机构和发展中国家的医院不具备部署大模型所需的 GPU 基础设施,DRET 增强的轻量模型使这些场景下的智能化文本处理成为可能。
更宏观地看,DRET 所代表的"嵌入级知识迁移"思路,其价值可能不止于生物医学。任何存在"大模型效果好但太重、小模型轻但缺知识"矛盾的垂直领域——如法律 NLP、金融文本分析、材料科学文献挖掘等——都可能从这种参数高效的适配范式中受益。在大模型持续膨胀的当下,如何以更小的代价获取专业能力,正是产业落地最迫切的命题之一。
核心要点
核心要点
核心要点
相关推荐
ComfyUI双语提示词节点实测:不懂英文也能玩转标签
一位B站UP主借助GPT打造的ComfyUI双语标签提示词拓展节点实测:中英标签双向联动、30万词库支持、未知标签一键翻译沉淀,让不懂英文的小白也能玩转提示词,目前适配anima本地部署模型。
16G显存跑Qwen3 27B:192K上下文+视觉实测
在16G显存显卡上部署Qwen3 27B模型,通过llama.cpp Adaptive KV Streaming实现192K超长上下文与视觉能力。本文详解KV缓存瓶颈原理、量化版本选择及RTX 5080实测速度与任务能力。
MiniMax H3本地部署实测:开源视频模型效果与完整教程
MiniMax H3 开源视频模型本地部署实测:涵盖硬件要求、ComfyUI 完整部署教程,以及文生视频、图生视频的真实生成效果与耗时,适合想入门本地 AI 视频生成的用户参考。