FDE岗位深度解析:本体论与场景驱动两大流派

FDE的核心是将AI客户交付产品化,通过本体论或场景驱动两条路径实现可复用的企业AI落地。
FDE(前向部署工程师)是一种深入客户内部构建AI系统的岗位,其与传统外包驻场的本质区别在于"产品化"——每次交付必须沉淀为可迁移、可复用的能力,而非一次性定制。文章将FDE落地路径归纳为两大流派:Palantir式的"本体论驱动"(先建统一数据语义模型,再做上层应用)和"场景驱动的AI Worker模式"(将企业AI改造拆分为多个解决具体痛点的智能体)。作者以自己搭建的教育平台为例,展示了学习助手、简历助手等多个Worker叠加后产生的业务质变效应。文章还着重澄清了一个行业误区:AI落地的本质是解决业务痛点、提升营收,"降本"只是业务竞争乏力时的被动选择,而非AI的主要价值。
什么是FDE:不只是做项目
FDE(Forward Deployed Engineer,前向部署工程师)是近年来随着AI落地需求爆发而兴起的一个岗位。它的核心工作模式是:由一个FDE团队派出一位或多位工程师,深入到客户内部,从零开始帮助客户定制构建一整套AI系统或解决方案。
从表面看,这与传统的"驻场做项目"非常相似。但两者存在一个关键区别——产品化。如果FDE工程师每换一个客户就重新做一遍,前面积累的东西无法复用,那本质上和外包驻场没有区别。真正的FDE,是把一套针对特定行业(如金融)的AI改造方案沉淀为可复用的产品,到客户现场只需调整参数、环境和变量,就能快速落地。
换句话说,FDE的价值不在于"能做出符合客户的方案",而在于"每一次交付都能反哺产品,形成可迁移的能力"。这是判断一个团队是真FDE还是伪FDE的分水岭。
两大流派:本体论驱动 vs 场景驱动
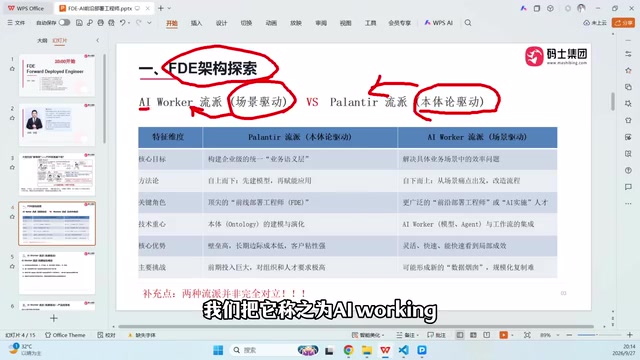
经过接近半年的实践与探索,本文作者将市场上FDE的落地路径梳理为两个方向:
本体论驱动(Palantir流派)
这一流派以Palantir为代表,强调先构建统一的数据本体(Ontology)——把企业内的人、事、物、关系抽象成一套结构化的语义模型,再在此基础上做上层应用。它的优势是数据一致性强、企业级治理能力好,但前期建模成本高、周期长。
Palantir(帕兰提尔)是一家成立于2003年的美国数据分析公司,早期主要服务于美国政府和情报机构,后来扩展至企业客户。其核心产品Foundry围绕"本体"(Ontology)概念设计——Ontology在哲学上指对"存在"的系统性描述,在数据工程语境中则指将企业内部各类实体(员工、订单、设备、流程等)及其相互关系定义为统一的结构化语义图谱。这套建模方式使得不同业务系统的数据可以按照同一套语言互相理解和关联,AI应用得以在一致的语义层上运行,而非各系统"各说各话"。Palantir的FDE团队(他们内部也称为"部署工程师")正是通过这套方法论进驻客户,协助完成企业级数据治理和AI系统构建,单个项目周期往往以季度甚至年为单位。
场景驱动(AI Worker流派)
另一条路径是场景驱动,作者称之为"AI Worker流派"。它的思路是:把一个公司的AI改造拆分成很多个具体的Worker(AI工作机器人或智能体),每个Worker解决一个明确的业务痛点。这种方式落地快、见效直接,更适合中小团队快速验证。
两大流派并非对立,而是对应不同的企业规模与落地节奏。大型企业往往需要本体论打底,而快速迭代的业务场景则更依赖AI Worker模式先跑通。
场景驱动实战:从学习助手到简历助手
作者以自己搭建的教育学习平台为例,展示了AI Worker模式的落地形态。
学习助手是一个典型的Agent:用户可以向它提问,也可以让它"总结最近七天的学习情况"。它会自动汇总课程学习进度、学习记录等数据。背后的实现是把AI Agent与Java学习平台的微服务后端打通,课程视频经由人工上传、抽检确认质量后,接入Milvus向量数据库进行检索。
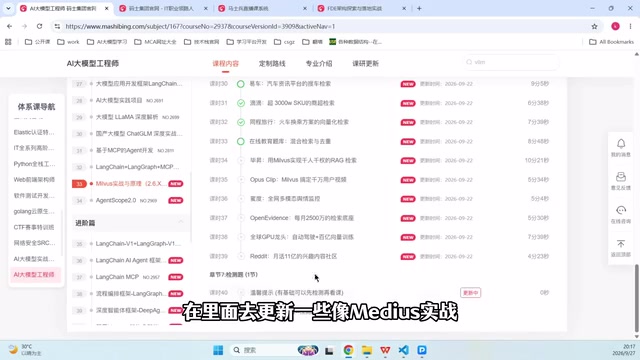
沿着同样的思路,可以不断扩展新的Worker:
- 简历助手:上传优秀标准简历作为参照,AI快速分析学员简历与S级样本的差距,再结合老师的理解给出修改建议;
- 备课助手、监督助手:辅助教学与学员管理;
- 入学检测与服务助手:自动完成入学检测、数据登记、课程回访提醒等一系列服务。
当一家公司的AI Worker从10个做到20个、50个时,会产生质变效应。作者提到,借助AI工具加上学习平台,一个人甚至就能独立开出一门新科目——比如研究巨神机器人这类新方向,只需录制或整理技术分享,配合AI辅助完成备课、讲课、知识点拆解,就能把一个业务场景"跑活"。
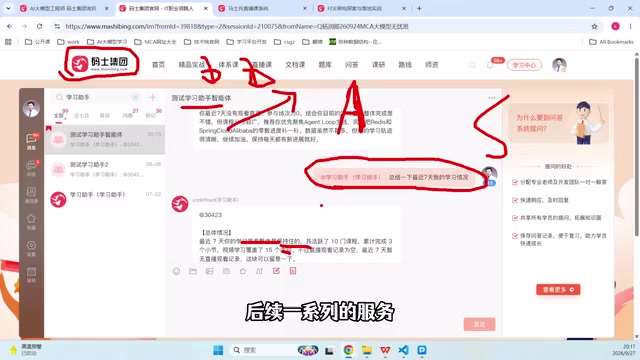
Milvus是一款专为AI场景设计的开源向量数据库,由中国团队Zilliz开发并于2019年开源。与传统关系型数据库按精确字段检索不同,向量数据库存储的是由AI模型(如文本嵌入模型)将非结构化内容(文本、图片、音频等)转换而成的高维数值向量,检索时通过计算向量之间的余弦相似度或欧氏距离,找出语义最接近的内容。这正是RAG(检索增强生成)架构的核心基础设施:将课程讲义、视频字幕等知识文档预先向量化存入Milvus,用户提问时实时检索最相关的知识片段,再交由大语言模型生成回答,从而使AI助手的回答准确贴近具体业务知识,而不是依赖模型训练时的通用知识。
澄清一个误区:AI落地不等于降本
作者特别停下来纠正了一个普遍误区:AI的落地不是降本增效,而是解决痛点问题。
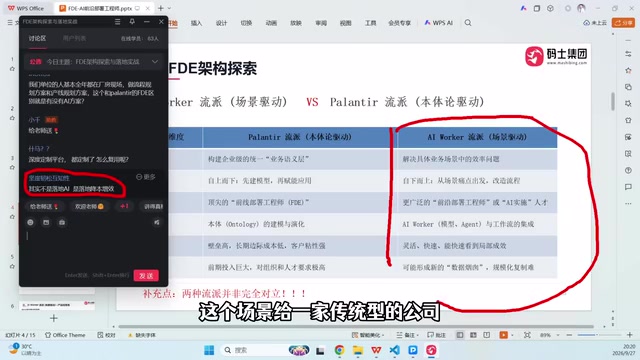
国内之所以总把AI和"降本增效"绑定,很大程度是因为业务没有"卷出去"。作者举例:如果一套AI方案在一家传统家具公司跑通,付出成本不高,却能把它的销售额、营业额和市场影响力提升一个档次——这种情况下,企业为什么要去降本?只有在赚不到钱的时候,才会想着削减人力成本。
他坦言不排除有些资本家会拿AI来做纯粹的降本:会AI的人给五万一个月,如果干的活相当于原来五个人(两万×5=十万)还更好,那自然只留一个人。但这背后其实是一条更底层的规律——优胜劣汰。技术始终在发展,新技术不断取代老技术,这个逻辑从人类历史之初就未曾改变。
给创业者的建议
对于有志于自主创业的开发者,作者认为FDE架构探索是一个可行方向。如果你具备编程能力、沟通能力和协调能力,完全可以专门去探索一套类似教育体系的完整方案——涵盖公开课、VIP课、学习产品及配套服务。
结合AI与少量人力,整体成本可以压得很低,而交付能力却能覆盖过去需要多人团队才能完成的业务。这正是FDE产品化思维的现实意义:用可复用的AI能力,撬动过去难以规模化的服务型业务。
需要提醒的是,本文观点主要来自单一UP主的实践总结,其架构划分(本体论/场景驱动)属于个人探索性框架,读者可作为参考视角,但不应视为行业统一定义。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。