Gemini 4 Neon实测:能否平替Claude Opus 5.5?
三款编码Agent同题实测:Gemini 4 Neon创意交互接近Opus 5.5,细节与稳定性仍存差距。
本文基于B站UP主的三款AI Agent横向实测,比较谷歌反重力(Gemini 4 Neon)、Codex(GPT 6.2)与Claude Code(Opus 5.5)在鹈鹕骑自行车动画、3D赛车游戏和纯代码生成宣传视频三道题上的表现。结果显示没有模型全面胜出:Opus 5.5在动画细节与自动压弯上最佳,Gemini 4 Neon以音效、多镜头和灵敏交互见长但环境粗糙且有闪烁bug,GPT 6.2在赛车环境真实感上更均衡。视频任务三家均不达标。结论是Gemini 4 Neon已可与Opus 5.5同台竞技,“平替”部分成立,但细节打磨、稳定性及工具链适配仍是关键变量。
最近,谷歌发布了新一代大模型 Gemini 4 Neon,社区风评出奇地一致看好,甚至有人认为它已经能够平替 Claude Opus 5.5。为了验证这个说法,B站 UP 主用三款 AI Agent 工具——谷歌反重力(搭载 Gemini 4 Neon)、GPT 的 Codex(搭载 GPT 6.2)、Claude Code(搭载 Opus 5.5)——做了同题横向实测,从三个维度考察模型能力。本文基于该实测视频,整理关键发现并加入分析。
测试设计:三款 Agent、三道题
UP 主搭建了一个测试工作台,实时监控三款工具的运行状态。三道测试题分别是:经典的“鹈鹕骑自行车”动画、3D 赛车小游戏、以及用纯代码生成的模型宣传视频。所有作品都在 Agent 工具中通过代码生成,而非直接使用网页端的视频生成功能。
需要提前说明一个变量:UP 主承认 GPT 6.2 是最后才收到提示词的,因此存在参考前两个作品的可能,打分时会对此扣分。
AI Agent(编码智能体) 是本次测试的核心载体。与直接对话的聊天机器人不同,这类工具能自主规划步骤、读写文件、执行命令并迭代调试,本质上把大模型包装成了一个可独立完成工程任务的“数字员工”。文中提到的“反重力”“Codex”“Claude Code”都属于此类产品:用户给出自然语言需求,Agent 自行编写 HTML/JavaScript/WebGL 代码并反复运行修正,最终产出可交互的网页作品。正因如此,测试考察的不只是模型的语言能力,还包括其长程任务规划、代码正确性和自我纠错能力——这也解释了为什么同一个模型在动画、游戏、视频三类任务上表现差异明显。
鹈鹕骑自行车:细节与互动的较量
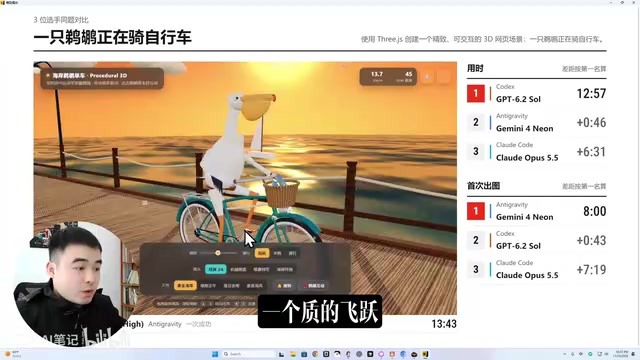
Gemini 4 Neon 的作品一上来就有惊喜——它是三者中唯一带音效的,海风声音相当逼真。动画提供四个镜头:经典 4:3、侧面、正面特写和海岸环绕,还能切换正午、落日、星夜等多种天色。交互方面,按铃铛、与鹈鹕互动、按 A/D 键压弯都可以实现。
但短板也很明显:周围的建筑物和海面帆船粗糙得像“小学生画画”,这直接拉低了整体完成度。UP 主给它的主观评分是 8 分,并直言如果环境细节更逼真,这个作品能上 9 分。
Claude Opus 5.5 的作品虽然没有音效,但动画质量提升了一个档位。它可以自动压弯——UP 主没有触碰键盘鼠标,车辆会自己完成压弯动作。鹈鹕的嘴巴一直在动,车筐里两条小鱼的眼睛还会眨,夜晚模式下有车灯和尾灯。这些细节让 UP 主给出了 9 分。
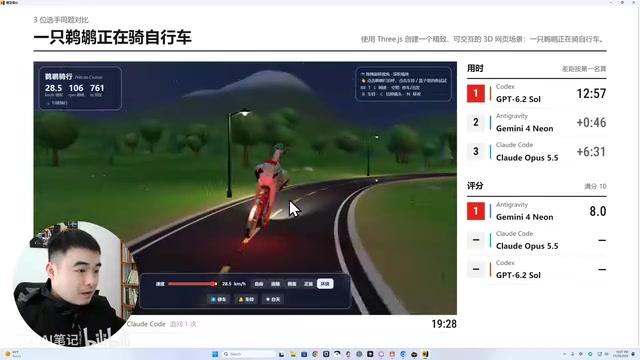
GPT 6.2 的作品在动作和机位上明显更少:只有踩自行车和滑行两个动作,机位只有四分之三、侧面和踏板特写三个,不能打招呼,只能按车铃,也没有昼夜切换。加上“抄袭”嫌疑,UP 主只给了 7 分。
“鹈鹕骑自行车” 是 AI 圈内一个流传已久的基准测试梗,最早源于对图像生成模型构图与物理合理性能力的调侃:鹈鹕的喙、蹼足与自行车踏板之间存在复杂的空间关系,很容易画出结构错误。当它被迁移到编码 Agent 场景后,考察点扩展为模型能否用代码正确建模角色骨骼、车轮旋转、镜头跟随和键鼠交互。因此这个题目并非随意挑选,而是一个能同时暴露几何理解、动画状态机和交互逻辑缺陷的综合压力测试,这也是三个作品在“环境细节”和“动作丰富度”上拉开差距的原因。
3D 赛车:环境真实感差距明显
第二题要求生成 3D 赛车小游戏。Gemini 4 Neon 的版本按键灵敏,支持切换车尾和车内视角,但车内视角的方向盘不够逼真,屏幕上半部分持续闪烁——疑似 bug。
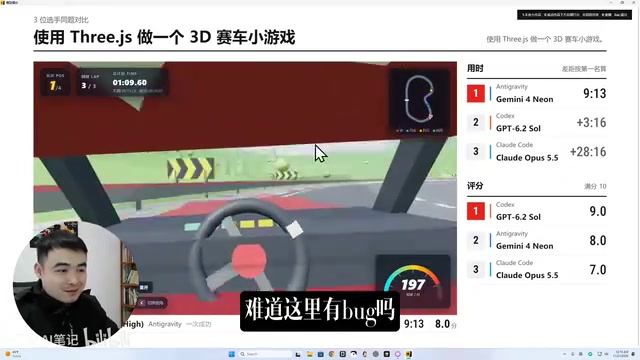
Opus 5.5 的赛车从车尾视角看不如 Gemini 版本好看,植被和蓝天白云同样显得粗糙;切到车内视角后,UP 主直言“感觉不是在比赛,是在开三蹦子”。
GPT 6.2 的版本反而在这题里表现更均衡:没有声音,但周围环境、看台人群、建筑物和蓝天白云的逼真度高于前两者,更接近真实 3D 场景。车内视角虽然也粗糙,但至少让人有“在开赛车”的感觉。UP 主认为,如果继续优化提示词,Gemini 4 Neon 在这类任务上可能还有更大潜力。
代码生成视频:三家都不及格
第三题要求用纯代码生成各自模型的宣传片。UP 主的判断很直接:三家的效果都达不到甲方标准。Gemini 4 Neon 的效果“很一般”,直接 pass;GPT 6.2 的 logo 用错了,同样 pass;Opus 5.5 的效果相对最强,但最后 logo 也用错了。
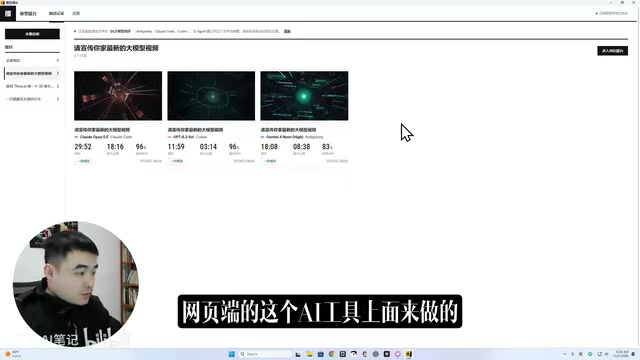
这里暴露的是工具层面的局限:用写代码的 Agent 生成视频本身就是短板,无论模型多强,都很难产出精美视频。UP 主建议,如果需要生成视频,应该优先使用 Gemini 或 Claude 的网页端,而不是在编码 Agent 里硬做。
用纯代码生成视频 通常指借助 WebGL、Canvas 或 Three.js 等图形库,由模型编写渲染与动画代码来逐帧合成画面,而非调用扩散模型生成像素。前者本质是“程序化动画”,画面精度受限于手写几何体和着色器的复杂度,很难达到实拍或 AI 视频模型的质感;后者依赖视频生成大模型,擅长光影与纹理,但在编码 Agent 中通常不可调用。这就解释了为什么三家在第三题集体翻车:任务要求与工具能力存在结构性错配,logo 用错则进一步反映模型在长代码中对关键视觉元素的把控不稳定。
综合表现与选型建议
三道题下来,没有哪个模型全面胜出。鹈鹕动画上 Opus 5.5 细节更丰富、交互更自然;赛车游戏上 GPT 6.2 的环境真实感更好;视频生成三家都不可用。Gemini 4 Neon 的优势在于音效、多镜头和灵敏交互,短板是环境细节粗糙和疑似渲染 bug。
对于开发者选型,实测给出的信号是:Gemini 4 Neon 在创意交互类任务上已经具备与 Opus 5.5 同台竞技的能力,但在细节打磨和稳定性上仍有差距。“平替”之说有一定依据,但还谈不上全面超越。模型能力之外,工具链和任务类型对最终产出的影响同样不可忽视。
相关推荐
Jingle Jam 2026 报名开启:Lewis 用旧素材喊你组队募捐
Jingle Jam 2026 募捐报名已开放。Lewis 用旧素材剪辑成新视频,号召观众在 jingle jam.tiltify.com 建立募捐页面,支持八家慈善机构,活动于 12 月前两周举行。
FBI警告的Artex:无自研模型的AI攻击框架如何撬开企业大门
FBI警告的开源AI攻击框架Artex没有自研模型,靠接入Claude、GPT等外部大模型驱动代理循环,把Nmap等普通工具变成自动化攻击流水线。本文梳理韩国金融业、ConnectWise、Barracuda三起真实案例,解析速度、成本与噪音三重原因,并给出暴露面清点、短时效凭据等防御要点。
ARTEX AI如何用智能体自动化黑客攻击?
ARTEX AI 是一套基于智能体的自动化黑客攻击框架。本文解析其规划者与执行者双层结构、共享黑板驱动的自适应攻击循环,以及这种智能体黑客模式对防御方意味着什么。