交互式笔记:RLHF、注意力、LoRA与LLM评估
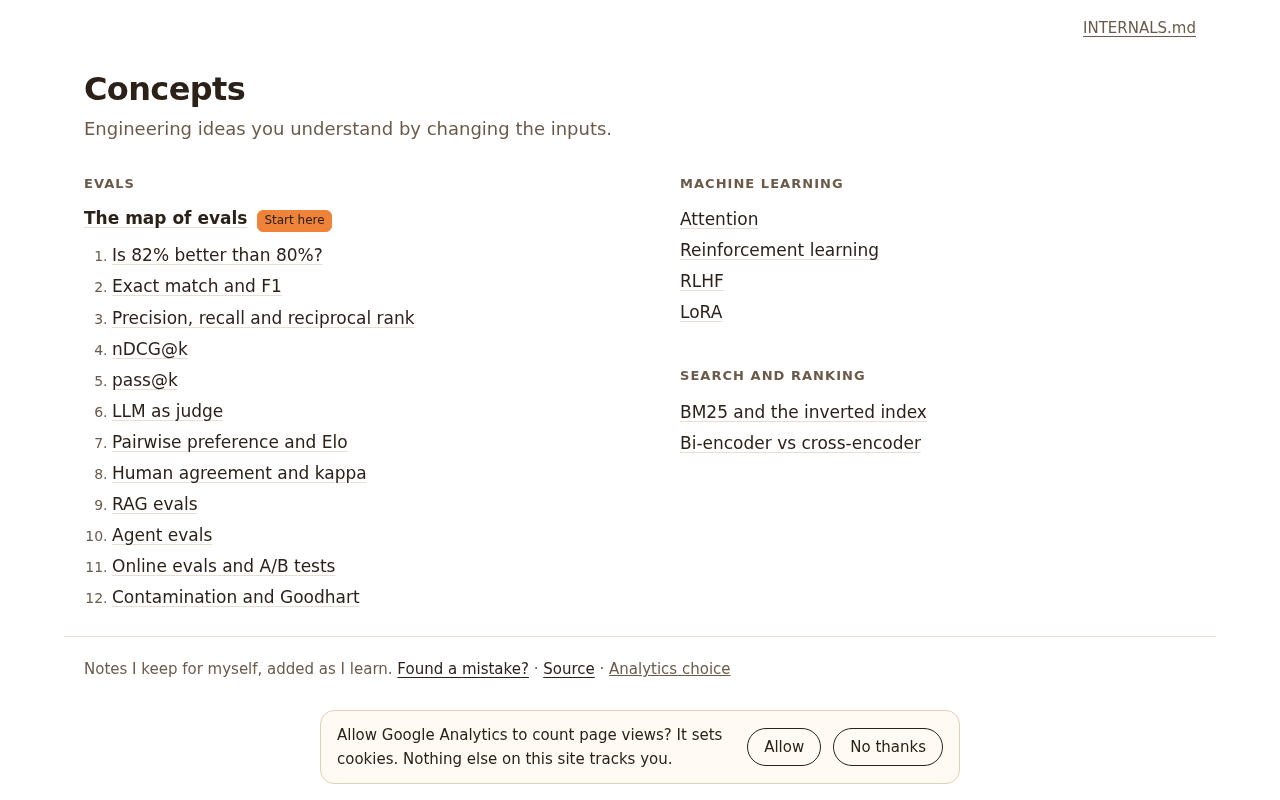
交互式笔记用动手操作帮助读者建立RLHF、注意力、LoRA和LLM评估的直觉。
该项目以交互式笔记形式覆盖RLHF、注意力机制、LoRA和LLM评估四个大模型核心主题,旨在弥补静态教材与视频课程之间的空白。传统材料依赖文字和公式,读者需自行完成从公式到直觉的转换;交互式界面让学习者通过调整参数、观察变化来建立空间感和操作感。文章逐一分析了四个主题的交互价值:RLHF的三阶段流程可被拆解为可观察步骤,注意力机制让查询、键、值的交互变得可感知,LoRA使低秩分解和微调成本降低的原理可视化,LLM评估则帮助对比不同方法的适用边界。文章也指出单一Show HN来源信息有限,交互深度尚待体验验证,并建议读者带着具体问题探索而非线性浏览。
一个让大模型概念“动起来”的学习工具
在Hacker News的Show HN板块,一个名为“Interactive notes on RLHF, attention, LoRA and LLM evals”的项目引起了关注。它用交互式笔记的形式,把大语言模型(LLM)中几个最常被提及、也最容易让人一头雾水的概念——RLHF、注意力机制、LoRA和LLM评估——变成了可以亲手操作的内容。
传统教材和博客往往用大段文字和静态公式解释这些概念,读者需要自己在脑中完成“从公式到直觉”的转换。这个项目反其道而行:通过可交互的界面,让学习者在调整参数、观察变化的过程中建立直觉。根据该Show HN帖子的描述,笔记覆盖了强化学习人类反馈(RLHF)、Transformer的注意力机制、低秩适配(LoRA)以及LLM评估这几个主题。
四个主题,四种交互视角
RLHF:把“人类偏好”变成可操作的流程
RLHF是让ChatGPT这类模型对齐人类意图的关键技术,但它的三阶段流程(监督微调、奖励建模、强化学习优化)常常停留在流程图的层面。交互式笔记的价值在于,学习者可以逐步跟踪偏好数据如何影响奖励模型,进而影响最终策略。帖子没有透露具体的交互形式,但从主题设计来看,它试图把抽象的对齐过程拆解为可观察的步骤,降低理解门槛。
奖励模型与策略优化中的常见算法
RLHF 的第三阶段通常使用近端策略优化(PPO)来更新语言模型策略。PPO 是一种信赖域方法,通过裁剪重要性采样比率,限制每次策略更新的幅度,避免强化学习训练中常见的崩溃问题。在 RLHF 场景中,奖励模型为每个生成结果打分,PPO 则利用该分数计算优势函数,并配合 KL 散度惩罚项,防止策略偏离初始监督微调模型太远。理解 PPO 的裁剪机制和 KL 惩罚的作用,有助于把握 RLHF 为何能在提升有用性的同时保持输出稳定性。
偏好数据与 Bradley-Terry 模型
奖励建模阶段通常基于成对比较数据,采用 Bradley-Terry 模型将人类偏好转化为概率形式:对于同一提示下的两个回答,奖励模型学习预测哪一个更受偏好。该模型假设每个回答有一个潜在的奖励分数,偏好概率由两个分数的差值经 sigmoid 函数得到。这种建模方式使奖励模型能够泛化到未见过的回答对,但也存在奖励黑客(reward hacking)风险——策略可能找到高分但并非真正符合人类意图的输出。交互式笔记若能让读者调整偏好数据分布或奖励模型容量,将更直观地展示这些权衡。
注意力机制:看见token之间的“关注”
注意力机制是Transformer的核心,也是最常被静态图示简化掉的部分。交互式笔记让读者能够直观感受查询、键、值之间的交互关系。对于初学者而言,这种“动手调一调”的方式比阅读矩阵乘法公式更容易建立空间感。据该Show HN帖子的主题组织,注意力部分被设计为可交互的探索模块,这与常见的纯文本教程形成明显差异。
缩放点积注意力与多头机制
Transformer 中的注意力通常采用缩放点积形式:查询与键的点积除以维度的平方根,再经 softmax 归一化后对值加权求和。缩放因子用于防止高维点积过大导致 softmax 梯度消失。多头注意力则并行运行多组独立的查询、键、值投影,让模型在不同子空间中捕捉不同类型的依赖关系,最后拼接各头输出并线性变换。交互式可视化若能展示不同注意力头对同一句子的关注模式差异,将帮助读者理解多头机制为何能提升表达能力。
因果掩码与位置编码
在自回归语言模型中,注意力需要配合因果掩码,确保每个位置只能关注自身及之前的 token,防止信息泄露。此外,由于注意力本身对序列顺序不敏感,模型依赖位置编码(如正弦编码或旋转位置编码 RoPE)注入顺序信息。理解掩码和位置编码的作用,是看懂注意力热力图的前提——否则读者可能误以为模型能“看到未来”或忽略词序。
LoRA:低秩适配的直观呈现
LoRA通过低秩分解大幅降低微调成本,但“低秩”究竟意味着什么、为什么能奏效,对许多开发者来说仍是黑箱。交互式笔记将这一概念可视化,帮助读者理解适配矩阵的秩如何影响模型行为。根据该Show HN帖子的描述,LoRA部分同样以交互形式呈现,旨在让参数高效微调的原理变得可感知。
低秩分解的数学直觉
LoRA 的核心假设是微调时的权重更新具有低内在秩。具体而言,对于预训练权重矩阵 W,LoRA 不直接更新 W,而是学习一个低秩分解 ΔW = BA,其中 B 和 A 分别是 d×r 和 r×k 的矩阵,秩 r 远小于原始维度。前向传播变为 h = Wx + BAx,训练时只更新 A 和 B。这种设计将可训练参数量从 d×k 降至 r(d+k),大幅降低显存和计算开销。交互式笔记若允许调整秩 r 并观察适配效果变化,能帮助读者建立“低秩约束如何影响模型容量”的直觉。
与全量微调的权衡
LoRA 的秩 r 是一个关键超参数:秩越高,适配能力越强,但参数量和过拟合风险也增加;秩过低则可能欠拟合。实践中常选择 4 到 64 之间的秩,并配合缩放因子 alpha 控制更新幅度。LoRA 的另一优势是推理时可将 BA 合并回 W,不引入额外延迟。理解这些权衡,有助于读者判断何时用 LoRA、何时需要全量微调。
LLM评估:从主观印象到可操作框架
LLM评估是当前业界争论最激烈的领域之一——基准测试、人类评估、自动化指标各有局限。该笔记将评估作为一个独立主题,说明作者意识到“模型好不好”不能只靠感觉判断。交互式形式可能让读者对比不同评估方法的输出差异,从而理解每种方法的适用边界。据该Show HN帖子的主题设置,评估部分被纳入交互笔记体系,体现了对模型质量衡量的重视。
常见评估范式及其局限
LLM 评估大致分为三类:基准测试(如 MMLU、GSM8K)、人类偏好评估(如 Chatbot Arena 的成对比较)和自动化指标(如 BLEU、ROUGE、BERTScore)。基准测试便于复现和横向对比,但存在数据污染和饱和问题;人类评估更贴近真实使用体验,但成本高、主观性强;自动化指标速度快,却常与人类判断脱节。此外,LLM-as-a-judge 用强模型给弱模型打分,已成为流行折中方案,但本身存在位置偏差、冗长偏好等已知问题。交互式笔记若能让读者对比同一输出在不同评估方法下的得分差异,将直观揭示“评估即建模”的本质。
为什么交互式学习值得关注
大模型领域的知识传播长期存在一个矛盾:概念更新极快,但学习材料大多仍是静态的。交互式笔记提供了一条中间路径——比视频更可控,比论文更友好,比博客更有参与感。
从该Show HN帖子的定位来看,它并非要替代系统课程,而是作为一种补充材料,帮助学习者在碎片时间里建立核心概念的直觉。对于正在进入大模型领域的工程师、产品经理和研究者来说,这类工具的价值在于缩短“知道名词”到“理解原理”之间的距离。
说一下,单一来源的Show HN帖子所能提供的信息有限,该项目的具体交互深度、覆盖范围和更新维护情况尚需实际体验验证。但仅从主题选择来看,它瞄准的正是LLM学习路径上最需要直观解释的几个节点,这一方向本身值得肯定。
适用人群与使用建议
这类交互式笔记最适合两类读者:一是刚接触大模型、被术语密度劝退的入门者;二是已经会用API调模型、但想补上原理课的中级开发者。建议的使用方式是带着具体问题去操作——比如“调整LoRA的秩会怎样影响输出”“注意力权重变化如何改变生成结果”——而不是从头到尾线性浏览。交互式材料的价值在于探索,而非阅读。
对于关注AI应用和AI编程的从业者,这类工具也可以作为团队内部技术分享的素材。把交互界面投屏出来,边操作边讨论,比对着幻灯片讲概念更有效。
相关推荐

Qwen 3.8编程击败Opus,你的Mac能跑吗?
Qwen 3.8开源模型在编程测试中击败Opus 4.6,仅18GB大小,但你的Mac需要多少内存?实测显示24GB会崩溃,32GB才是甜点区,本文详解各档Mac配置的实际表现与上手方法。

Claude Code + Agent:打造AI全自动测试闭环
B站课程解读:测试开发如何用 Claude Code 终端型 Agent 打造 AI 全自动测试闭环。对比终端型与设备型 Agent 的权限边界,讲清企业级项目为何选 Claude Code 而非 Open Claude 类工具,并梳理 Node.js 环境准备与 DeepSeek 模型搭配的落地路径。

与AI智能体共事,你需要钢铁般的神经
AI智能体越自主,使用者的心理负担反而越重。本文从Hacker News讨论出发,分析智能体协作中的黑箱焦虑、行为漂移与监控疲劳,并给出沙箱隔离、权限控制、任务粒度管理等降低认知负荷的实用思路。