Kev:基于Qwen3.5打造的轻量级决策模型家族

Kev是基于Qwen3.5的开源轻量决策模型,专为Agent调度等结构化判断场景设计。
Kev是近期在Hacker News引发关注的小型开源项目,定位为构建于Qwen3.5之上的"决策模型家族"。与追求通用能力的大语言模型不同,Kev专注于路由判断、意图识别、内容过滤等结构化决策任务,通过参数蒸馏或专项微调将大模型能力压缩至轻量规模。这一思路契合当前AI工程实践中的真实需求:大量Agent工作流和多模型编排场景需要低延迟、低成本的"前置调度器",而非动用旗舰大模型。该项目目前处于早期阶段,在Hacker News获得29赞13评,其实际性能与相对于基座模型的增量价值,仍有待基准测试和实际部署案例来验证。
什么是Kev决策模型
Kev是一个近期在Hacker News上引发讨论的小型模型项目,其定位是构建于Qwen3.5之上的"Jev-like"决策模型家族。从项目命名和描述来看,它试图在保持模型体积小巧的前提下,专注于决策类任务,而非通用对话或内容生成。
所谓"决策模型",指的是那些针对特定判断、分类或选择场景优化的模型。相比动辄数百亿参数的大语言模型,这类模型的价值在于以更低的推理成本、更快的响应速度完成明确定义的任务。这与当前业界追求"更小、更专"的模型演进方向相吻合。
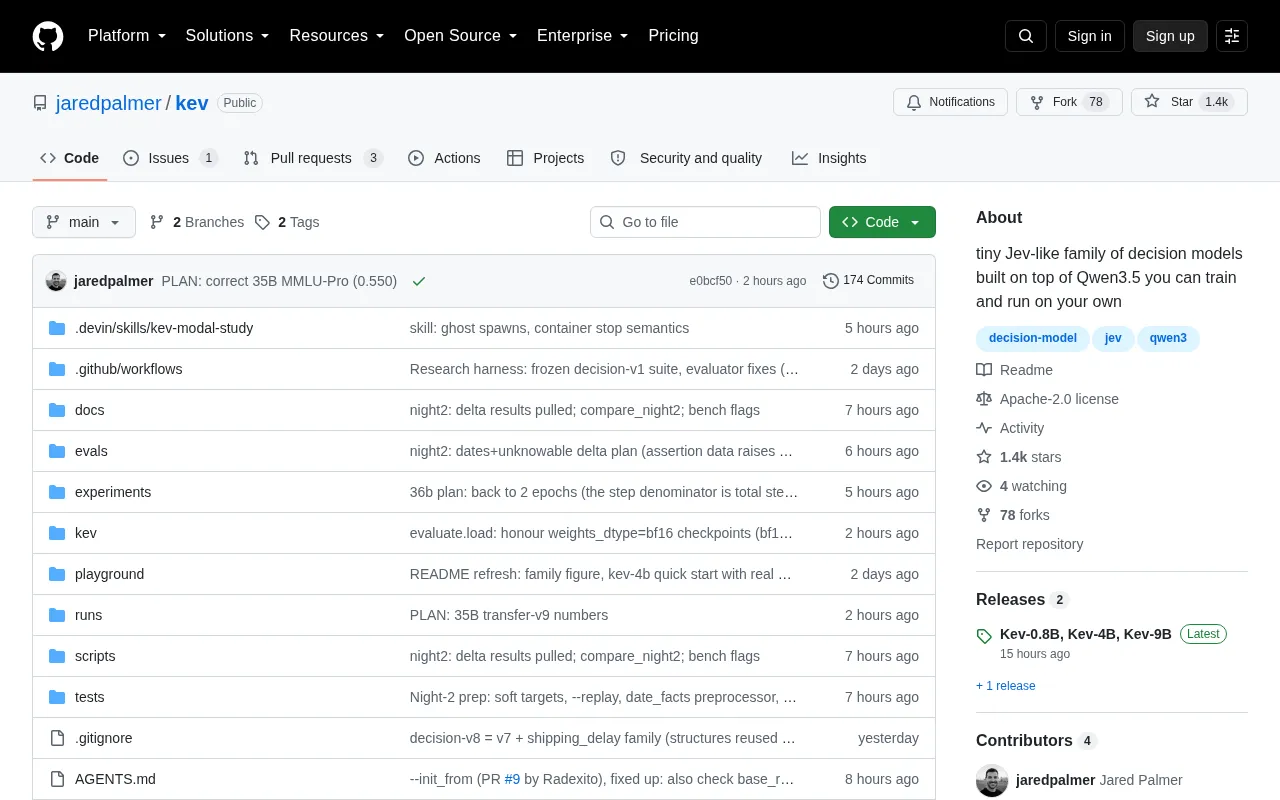
建立在Qwen3.5基础之上
Kev选择将Qwen系列作为基座模型,这一技术路线值得关注。Qwen(通义千问广告)作为开源模型生态中的重要一员,凭借其在多语言、代码和推理任务上的表现,已成为众多下游微调项目的首选底座。
基于成熟开源基座进行专项微调,是当下构建垂直模型的主流做法。这种方式让开发者无需从零训练,能够快速将通用能力"蒸馏"或"裁剪"为面向决策场景的轻量版本。Kev的"tiny"定位,意味着它可能通过参数削减、蒸馏或专项微调等手段,将大模型的部分能力压缩到更适合边缘部署或高频调用的规模。
值得注意的是,Qwen3.5与Qwen3是两个不同的版本系列,目前公开资料中"Qwen3.5"的具体参数规格尚不完全明朗,部分社区讨论认为这可能是项目描述中的笔误或非官方叫法,实际基座或许是Qwen2.5系列中的某个规模变体。Qwen2.5系列由阿里巴巴通义实验室发布,覆盖0.5B至72B的参数范围,其中较小规格(如0.5B、1.5B、3B)因推理速度快、可在消费级硬件甚至边缘设备上运行,成为构建轻量级专用模型的热门选择。模型蒸馏(Knowledge Distillation)是指用大模型的输出来训练小模型,使其在特定任务上逼近大模型的表现,而不需要继承全部参数;专项微调(Task-specific Fine-tuning)则是在预训练基座上用特定领域数据继续训练,使模型输出更贴合目标场景。Kev的"tiny"定位很可能结合了这两种技术路径。
为什么小型决策模型值得关注
在实际的AI应用工程中,并非所有任务都需要旗舰级大模型。大量的路由决策、意图判断、内容过滤、优先级排序等场景,本质上是相对结构化的判断问题。用超大模型处理这些任务,往往是"杀鸡用牛刀",既浪费算力又增加延迟。
小型决策模型的思路正是针对这一痛点。它们可以作为大模型系统中的"前置调度器"或"决策节点",在Agent工作流、多模型编排等架构中扮演关键角色。Kev这类项目如果能在保持小体积的同时提供可靠的决策能力,将有助于降低整体系统的运行成本。
在多模型编排(Multi-Agent Orchestration)架构中,"前置调度器"承担的典型职责包括:判断用户请求应路由至哪个子模型或工具、评估当前上下文是否满足执行条件、对输出结果做合规或安全过滤等。这类任务的共同特点是输入输出格式相对固定、判断标准明确,对创造性要求低但对延迟和吞吐量要求高。LLM-as-a-router(用语言模型做路由)的概念近年来在Agent框架(如LangGraph、AutoGen、CrewAI)中得到广泛实践,其中专用小模型相比通用大模型在成本和速度上的优势可达一个数量级以上。以GPT-4o与GPT-4o-mini的价格差距为例,对于每天需要进行百万次路由决策的生产系统而言,使用专用小模型的经济账非常显著。
社区反响与讨论
该项目在Hacker News上获得了29个点赞和13条评论,属于有一定关注度但尚未形成大规模讨论的早期项目。这种热度水平通常出现在技术社区对某个新颖但仍需验证的想法保持谨慎兴趣的阶段。
对于此类开源小模型项目,社区讨论的焦点往往集中在几个方面:模型的实际性能是否匹配宣传、与直接使用基座模型相比的增量价值、以及具体的应用场景和落地案例。由于原始信息有限,Kev在这些维度上的表现仍有待进一步的公开数据和实测来验证。
总结与展望
Kev代表了当前AI模型发展的一个典型趋势——从追求参数规模转向追求任务适配性。基于Qwen3.5这样的开源基座,构建专注决策任务的轻量模型家族,在成本控制和部署灵活性上具备潜在优势。
不过,作为一个早期项目,Kev的真正价值还需要更多的技术细节、基准测试和实际应用来支撑。对于关注模型轻量化和Agent工程的开发者而言,这类项目值得持续跟踪,以观察小型专用模型能否在通用大模型主导的格局中找到自己的位置。
相关推荐
用Claude Code写代码,先考了个网管:AI编程的配置之痛
Claude Code被吐槽配置门槛高:看八个教程一行代码没写,先被账号、网络、地区限制绕晕。本文分析AI编程工具的配置之痛、远程Mac mini方案的思路与边界,以及开发者该如何务实选择。
27款模型代码写视频实测:Claude Opus 5.5登顶,性价比之王竟是它
Artificial Analysis 的 Code2Video Benchmark 让27款模型用纯代码写HTML视频,Claude Opus 5.5 以1536分登顶,GPT 6.1 用约十分之一成本排名第四,揭示AI视频生成的审美与性价比之争。
Jev实战:用单次Prefill替代逐token解码的决策模型
拆解Jev推理范式:跳过逐token解码,仅用一次prefill前向传播输出选择、序数评分与布尔判断。对比编码器与解码器两条实现路线,解析多问题掩码设计、重复token陷阱,以及RLCD结合GRPO的概率校准训练方法。