Kimi K3.1 Pro发布:开源权重即将放出
Kimi K3.1 Pro承诺开放权重,社区聚焦能力过滤、交付与部署门槛展开交锋。
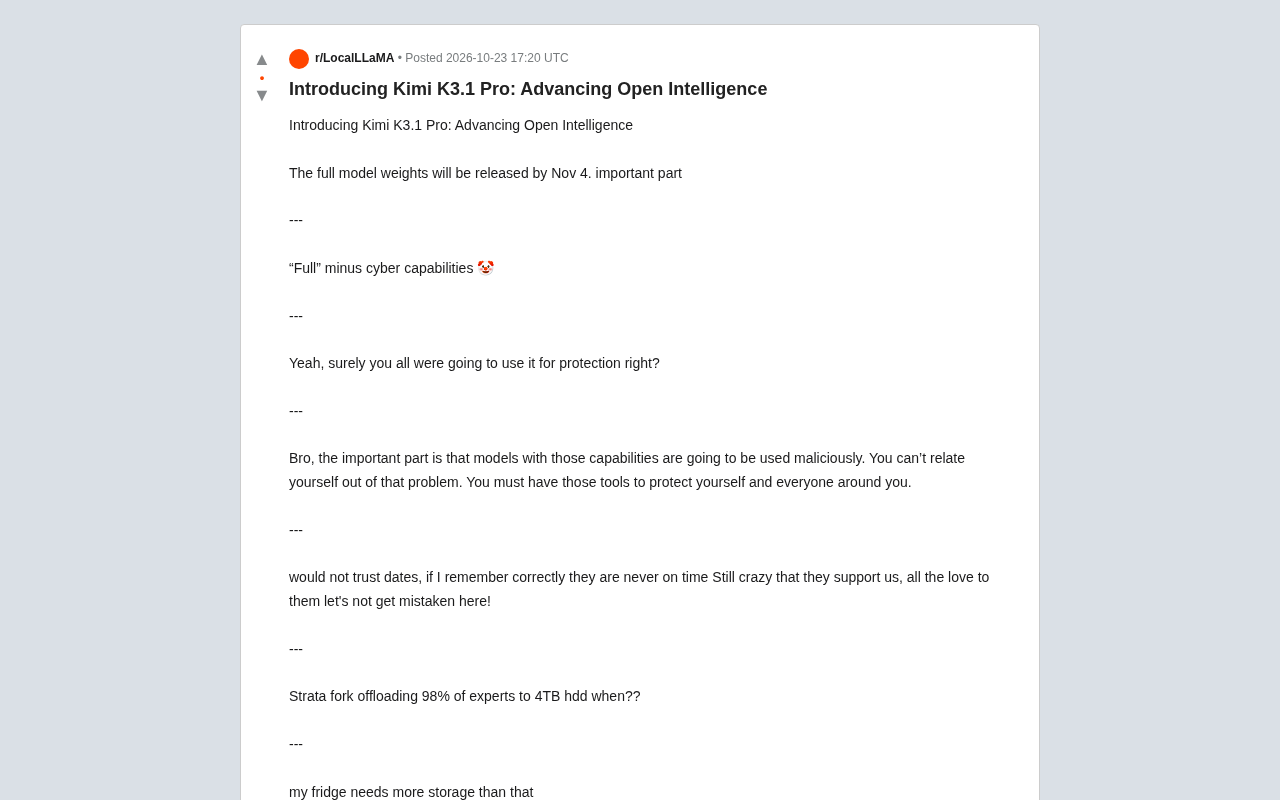
月之暗面在 Reddit 发布 Kimi K3.1 Pro,打出“Advancing Open Intelligence”并承诺 11 月 4 日前放出完整模型权重,但社区讨论迅速从性能转向对“完整”二字的质疑。高赞评论指出网络安全能力可能被刻意削弱,由此引发两派交锋:一方认为能力过滤只是合规姿态,另一方主张防御方必须拥有同等攻击工具才能自保。发布日期也遭遇信任赤字,用户吐槽其历史拖延却又表达对开源方向的支持。硬件梗则折射 MoE 架构下显存与存储的真实门槛。文章认为,能力过滤范围、交付一致性与本地部署难度,才是决定这次发布口碑的关键变量。
月之暗面(Moonshot AI)在Reddit上发布了Kimi K3.1 Pro,标题打出"Advancing Open Intelligence",并承诺在11月4日前放出完整模型权重。这条消息在开源社区迅速引发了讨论——但评论区并未停留在常规的性能吹捧上,而是围绕"完整"二字展开了相当尖锐的交锋。
"Full"到底完整在哪
官方措辞是"full model weights",但评论区第一条高赞回复就加了个注脚:"Full minus cyber capabilities 🤡"。这指向一个开源模型发布中越来越常见的做法:权重虽然开放,但某些能力维度(尤其是网络安全相关的攻防能力)会被刻意削弱或过滤。
这种"选择性开源"并非Kimi独有。过去一段时间里,多家实验室在发布开放权重模型时都会对高风险能力做对齐处理,理由是防止恶意使用。但从社区反应看,用户对这一套说辞的信任度并不高。
“开放权重”(open weights)与“开源”(open source)并非同一概念。开放权重通常只意味着模型的参数文件可被下载和使用,但训练数据、训练代码、数据配方往往并不公开;而 OSI 在 2024 年提出的开放源代码 AI 定义则要求公开数据信息、完整代码与参数。这种区分是理解评论区质疑的前提:当实验室宣称“完整权重”时,它承诺的只是参数层面的可得性,并不涉及能力层面的无保留。
“网络安全能力过滤” 属于更广义的“高风险能力对齐”范畴。常见做法包括在训练后阶段针对漏洞挖掘、恶意代码生成、渗透测试等任务进行拒绝性微调,或通过系统提示与分类器进行拦截。问题在于,这类过滤往往只能降低模型在特定提示下的表现,难以彻底抹除预训练阶段已习得的知识,因此社区才会怀疑其“合规姿态”多于“实质防护”。
社区的核心分歧:防御需要攻击能力吗
评论区很快分裂成两种声音。一方认为所谓"cyber capabilities"被移除只是表面功夫:"你们反正都是拿它来防护的对吧?"——这句带刺的反问代表了一种普遍怀疑,即能力过滤更多是合规姿态而非实质防护。
另一方的逻辑更直接:"重要的是,具备这些能力的模型本来就会被恶意使用。你没法把自己从这个问题里摘出去。你必须拥有这些工具来保护自己和周围的人。"这是一种典型的能力对等论——防御方若没有同等工具,安全就无从谈起。
两方各有道理,但这场争论暴露的深层问题在于:开放权重模型的安全边界,至今没有形成社区共识。
发布日期:信任赤字
aa社区对11月4日这个时间点的反应也很有意思。有用户直言"别太信这个日期,如果我没记错的话他们从来没准时过",紧接着又补了一句"但他们愿意支持我们这一点还是很疯狂的,给他们全部的爱,这点别搞混了"。
这种"吐槽拖延但感谢开源"的混合态度,其实很准确地描绘了当前开源模型发布方与社区之间的关系:用户对交付时间有预期落差,但对开源方向本身抱有强烈认同。对于一家中国实验室在西方社区主导的平台上发布开放权重,这种支持态度本身就值得注意。
硬件梗背后的真实焦虑
评论区另一条被反复接龙的话题是硬件。有人问"Strata fork什么时候把98%的专家卸载到4TB HDD上?",下面有人接"我的冰箱都需要比这更大的存储"。
这些玩笑指向MoE架构的现实:K3.1 Pro的专家数量意味着本地部署对显存和存储的要求相当高。"98%专家放HDD"是一种极端化的调侃,但背后是真实的落地焦虑——权重放出来了,普通人跑得动吗?这几乎是每个开放权重大模型发布后都会出现的讨论,也是"开源"与"可用"之间的永恒落差。
MoE(Mixture of Experts,混合专家)架构是当前大模型扩展参数规模的主流方案:模型内部包含大量并行的“专家”子网络,每次前向推理时通过一个路由门控网络只激活其中少数几个专家,从而在总参数量极大的情况下把单次计算量控制在较低水平。但这种“稀疏激活”只降低了算力开销,并不降低存储开销——所有专家权重都必须完整加载在显存或内存中备用。这正是评论区硬件梗的由来:专家数量越多,权重文件越大,消费级显卡的显存就越难容纳,即便采用 CPU 卸载(把部分专家放到内存甚至硬盘上)也只能以牺牲推理速度为代价。
权重卸载(offloading) 指把模型的部分层或专家从显存转移到内存、NVMe 硬盘等更慢的存储层级,运行时按需换入。评论中“把 98% 的专家卸载到 4TB HDD”正是对这一技术的夸张化调侃:机械硬盘的随机读取延迟是显存的数万倍,若真把绝大多数专家放到 HDD 上,推理速度将慢到不具备实用价值。这一梗的内核是,开放权重不等于开箱即用,硬件门槛仍是本地部署的实际壁垒。
开放智能的下一步
从目前信息看,Kimi K3.1 Pro的发布重点在"开放"而非单纯的性能参数。但社区的反应说明,仅靠宣布开放权重已经不足以赢得无条件信任:能力过滤的范围、交付时间的一致性、以及本地部署的门槛,才是决定这次发布实际口碑的关键变量。
11月4日能否如期兑现,权重放出后社区能否顺利跑通,将比发布帖本身更能说明问题。
相关推荐

Meta用小模型实测:绕过分词直接读字节,后劲更足
Meta新论文用蒸馏实验对比token模型与字节模型:字节模型起步落后但训练曲线后劲更足,数据效率高约6倍,代价是推理速度慢约5倍。本文梳理实验设计、外推预测的边界与对小模型部署的意义。

Anthropic安全主管言论引热议:AI是安全危机还是替罪羊?
Anthropic安全主管言论引发Reddit热议:AI是加剧了互联网安全危机,还是只是暴露了长期存在的漏洞?社区激辩18个月时间线、监管困境与F1核引擎类比。

苹果触屏MacBook传闻再起,联想Yoga 9n给了一个好范本
苹果触屏MacBook传闻再起,外媒以联想Yoga 9n为参照,指出触屏笔记本需要在形态、性能与生态三方面系统设计。本文分析苹果可能面临的挑战与行业信号。