LangChain+Playwright 打造智能测试Agent:自然语言驱动UI自动化
用本地大模型+Playwright构建AI测试Agent,以自然语言驱动替代硬编码脚本,解决UI自动化维护成本高的顽疾。
文章介绍了一种用AI Agent替代传统UI自动化脚本的思路。传统方案(Selenium/Playwright脚本)的核心问题是把每一步操作硬编码进代码,页面稍有变动就导致脚本大规模失效,维护成本极高。新方案将架构拆分为两层:本地部署的大模型(通过Ollama运行)充当决策大脑,负责理解自然语言测试目标并规划操作步骤;Playwright工具包充当执行手脚,将浏览器操作封装为AI可调用的工具。工程师只需用一句话描述测试目标,Agent便自主完成页面识别、元素定位和操作执行,且思考过程全程可见。实战中需注意asyncio事件循环冲突修复、有头/无头模式切换以及系统提示词的精心设计。作者认为该方案尤其适合回归测试和页面巡检,代表了测试工作从"编写操作步骤"到"描述测试目标"的范式转变,但现阶段更适合作为传统脚本的补充。
传统UI自动化的两大顽疾
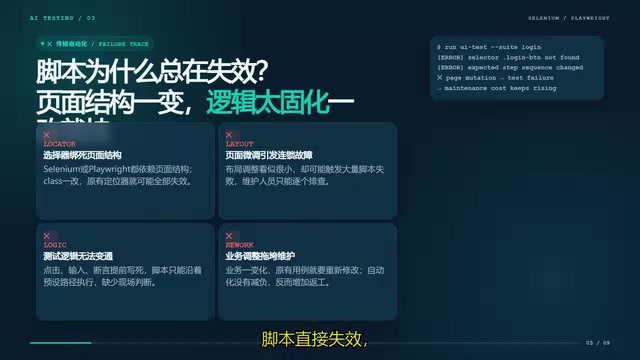
凡是做过UI自动化测试的工程师,大概都经历过这样的崩溃时刻:页面稍微改动一个 class、调整一下布局,脚本就大面积失效,接下来就是没完没了地改代码。
B站这位从业者总结了传统自动化的两大痛点,相当有代表性。第一是维护成本太高。无论用 Selenium 还是 Playwright,元素定位一旦失效,后续维护极其耗费时间,改脚本改到崩溃是常态。第二是逻辑过于固化。所有的点击、输入、断言都是提前写死的,业务流程稍作调整,整套脚本就得推倒重来。
这两个问题的根源在于:传统脚本把"怎么做"(每一步的具体操作)硬编码进了代码,而页面本身是持续变化的。当变化速度超过维护速度时,自动化测试反而成了负担。
换个思路:让AI理解测试目标
智能测试Agent的核心思路,是把关注点从"怎么做"转移到"做什么"。
具体来说,我们不再逐行写死每一步操作,而是告诉AI一个高层级的测试目标,比如"访问某测试网站,检查登录页面元素,使用演示账号完成登录测试"。AI会自主规划操作路径、识别页面元素、完成验证。这就是所谓的自然语言驱动UI测试。
这种模式的价值在于对页面变化的适应能力。当页面元素位置或结构发生微调时,AI基于对页面的实时理解重新定位元素,而不是依赖写死的选择器,从而大幅降低维护成本。
架构拆解:大脑加手脚
整套架构其实只有两块,理解起来并不复杂。
本地大模型充当"大脑"
第一块是本地部署的大模型,相当于Agent的决策中枢。作者推荐使用 Ollama 部署开源模型,在本地运行。这样做的最大好处是数据隐私——测试数据无需上传云端,对企业内部使用的敏感系统尤为友好。
Ollama 是一个开源的本地大模型运行框架,支持 Llama、Mistral、Qwen 等主流开源模型一键部署,无需 GPU 云服务即可在普通开发机上运行推理。与调用 GPT-4 或 Claude API 相比,本地部署的延迟更可控,且没有按 Token 计费的成本压力,适合需要频繁调用的自动化测试场景。LangChain 则是连接大模型与外部工具的编排框架,它提供了 Agent 运行时、工具调用协议和对话记忆等基础能力,使得大模型可以在"思考→调用工具→观察结果→继续思考"的循环中完成复杂任务,而不仅仅是生成一段文字回复。
Playwright工具包充当"手脚"
第二块是 Playwright 工具包,是Agent执行操作的"手脚"。它把浏览器跳转、点击、提取文本等能力封装成AI能够理解和调用的工具,让大模型可以直接操控浏览器、与网页交互。
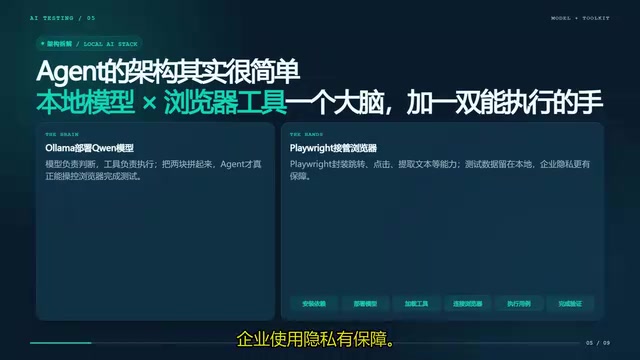
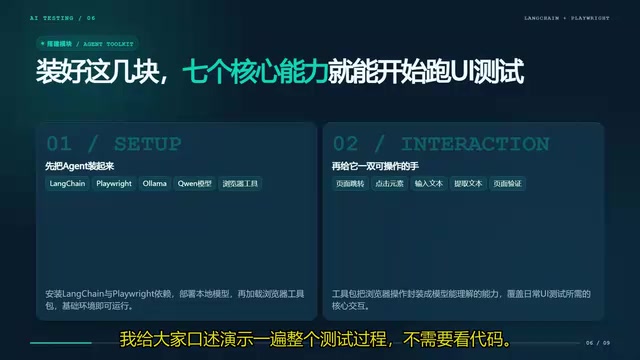
搭建流程也不复杂:安装好 LangChain 与 Playwright 依赖,部署本地模型,加载浏览器工具包,就能获得页面跳转、点击、元素提取、文本获取等约七个核心能力,日常UI测试基本够用。
Playwright 是微软开源的跨浏览器自动化框架,支持 Chromium、Firefox 和 WebKit,提供异步 API(async/await)和强大的等待机制,相比 Selenium 在处理动态页面时更稳定。在 AI Agent 场景中,Playwright 的每一种操作能力(导航、点击、截图、提取文本等)被包装成符合 LangChain 工具调用规范的函数,大模型根据当前页面状态和测试目标自主决定调用哪个工具、传入哪些参数。这种"工具调用"(Tool Calling / Function Calling)机制是现代 AI Agent 的核心交互模式——模型不直接执行代码,而是输出结构化的调用意图,由框架负责实际执行并将结果回传给模型。
实际运行是什么样的
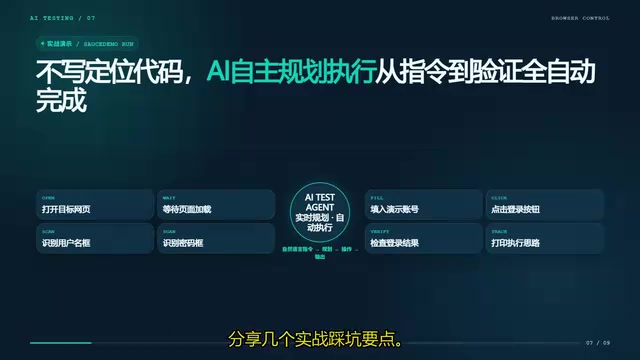
作者演示了完整的执行过程。给AI下达一句自然语言指令后——"访问测试网站,检查登录页面元素,使用演示账号完成登录测试"——AI会自行拆解并规划步骤。
它先控制浏览器打开目标网页,等待页面加载完成;接着识别页面上的用户名输入框、密码框和登录按钮;随后自动填入对应账号密码并点击登录。整个过程中,AI会实时输出它的思考逻辑,每一步要做什么都会打印出来,全程自动执行,不需要人工编写任何元素定位代码。
这种"思考过程可见"的特性,对调试和信任建立都很重要——你能清楚看到AI为什么这么点、这么填,而不是面对一个黑盒。
落地踩坑要点
作者分享了几个实战经验,对想动手的人很有参考价值。
处理事件循环冲突:代码里记得加上一步补丁,解决 asyncio 事件循环冲突导致的报错,这是本地跑异步浏览器操作时常见的坑。
分场景选择浏览器模式:调试阶段用有头(headed)浏览器,方便观察AI的执行流程;上线跑自动化时切换到无头(headless)模式,提升执行速度。
写好系统提示词:把AI明确设定为"测试工程师"角色,引导它分步思考,能显著减少乱点的情况,提升稳定性。提示词质量直接影响Agent的可靠性。
asyncio 事件循环冲突是 Python 异步编程中的经典问题。Playwright 的异步 API 需要运行在一个活跃的事件循环中,但在 Jupyter Notebook 或某些框架环境下,事件循环已经在运行,直接调用 asyncio.run() 会引发 "This event loop is already running" 错误。常见的修复方式是使用 nest_asyncio 库打补丁(nest_asyncio.apply()),允许事件循环嵌套运行,这在快速原型和脚本场景下是最省力的解决方案。系统提示词(System Prompt)的重要性同样不可忽视:明确的角色定义和分步推理指令(如 Chain-of-Thought 提示)能引导模型在操作前先输出推理步骤,而非直接输出行动,有效减少因模型"跳步"导致的误操作。
测试思维的转变
这套方案真正传递的,是一种测试思维的转变:从手动编写每一步操作代码,变成只需描述测试目标,页面微调时由AI自主适配。
对于回归测试、页面巡检这类重复性高、又常受页面变动影响的场景,这种模式尤其"香"。作者认为,这也代表了自动化测试的未来方向。
当然,需要理性看待:AI Agent目前仍存在稳定性波动、执行成本和响应速度的问题,短期内更适合作为传统脚本的补充而非完全替代。但它把测试从"维护脚本"中解放出来的方向,值得每个测试工程师关注和尝试。
相关推荐

写代码就能出片:Code-to-Video开源项目全解析
web-video-produce 是一个 Code-to-Video 开源项目,用 React 和 Remotion 把做视频变成写代码:分段脚本自动生成配音、字幕、时间轴,支持 Canvas 图表、Three.js 三维、14种中文音色及自动音频验收。

LightOn OCR-3 上线 OpenDocRouter:开源 OCR 的性价比新标杆
LightOn OCR-3 现已上线 OpenDocRouter,定价每百万输入 token $0.28、输出 $1.40,约 $3.19/千页。ParseBench 测试显示其位于开源 OCR 帕累托前沿,性能接近 Gemini 3.8 flash low 且价格低约 45%。

LegalOn 如何将 Codex 成本砍半:模型分级与预算管控实战
法律科技公司 LegalOn 通过按任务匹配 Astra、Sol、Luna 等不同模型并战略性管理预算,在保持开发速度的同时将 Codex 每日成本削减约 65%。本文解析其模型分级与预算管控的实战经验。