六周吃透大模型:从AI概念到企业级应用的零基础学习路线
六周三阶段路线,从AI发展脉络到企业级大模型应用开发的系统入门框架
本文梳理了B站UP主金泽的大模型入门课程框架:以三阶段六周路线替代从机器学习讲起的传统教法,依次覆盖原理与提示词工程、RAG与Agent应用开发、微调与私有化部署实战。课程第一节重点厘清了AI、机器学习、深度学习、生成式AI的递进关系——从深蓝的搜索算法,到监督/非监督/强化学习,再到Transformer注意力机制引发的大模型爆发,勾勒出技术从"规则判断"演进到"内容创造"的完整脉络。课程的核心立场是:普通学习者不必从头训练模型,应站在现有大模型能力上,结合具体业务场景搭建知识库和自动化Agent,将技术真正落地。
很多人想学大模型却总是卡在起点:网上课程从机器学习讲起,动辄铺陈几十年前的老理论,学到一半就放弃了。B站UP主金泽在他的大模型入门系列课程中提出了一个更务实的思路——抛开陈旧的教学顺序,用三阶段、六周时间从零构建对大模型的完整认知,最终落地到企业级实战项目。
本文梳理这套学习框架,并重点还原课程第一节对AI核心概念脉络的讲解,帮助初学者建立正确的知识地图。
三阶段学习路线:从原理到实战
课程给出的路线并不复杂,关键在于顺序和取舍。
第一阶段聚焦大模型原理与提示词工程,目的是让学习者对大模型建立最基础的概念——它是什么、能干什么。这一步不需要深挖数学和算法,而是先搞清楚模型的能力边界。
第二阶段进入 RAG、Agent 等核心方向,把整条应用技术链玩熟。这是从「会用」到「会开发」的关键跨越。
第三阶段将前两个阶段的知识结合起来,再补上微调和私有化部署两项技能,直接做项目实战。课程推荐的实战场景包括医疗智能客服、股票分析、数字人等企业级方向。
这套路线的价值在于它明确了普通学习者与AI基础研究者的分野:你不需要从头训练一个模型,而是站在现有大模型的基础上开发实际应用。
理清概念:AI、机器学习、深度学习到底什么关系
初学者最大的困惑,是把人工智能、大模型、机器学习、深度学习、生成式AI这些词混为一谈。有人以为AI就是ChatGPT,有人觉得它们是几个互不相关的技术。实际上它们之间存在清晰的发展关系。
**人工智能(AI)**是最大的范畴,研究的是让计算机、软件系统或机器人具备类似人类的学习、理解、推理和行动能力。它不是某个具体产品,而是横跨计算机科学、数学、统计学、语言学甚至神经科学的整个技术领域。
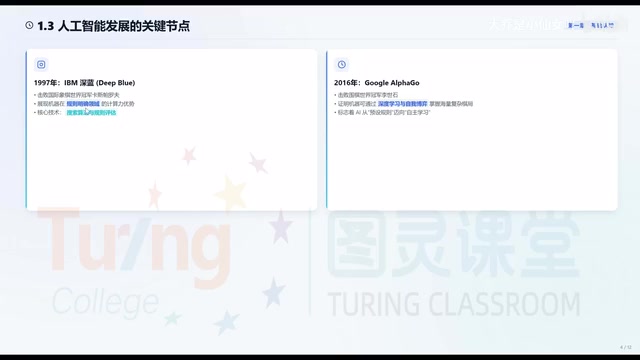
课程用两个历史节点勾勒了早期AI的路径:1997年IBM深蓝击败国际象棋冠军卡斯帕罗夫,2016年AlphaGo击败围棋冠军李世石。深蓝的实现方式和今天的大模型完全不同,它依靠的是搜索算法——提前分析大量可能的走法,按预设的评估规则选出胜率更高的一步。
这种方式之所以能解决国际象棋,是因为棋类规则明确、可被程序提前定义。但现实世界中大量任务没有明确规则——判断一张图片是不是猫、分析一篇文章的情绪,都无法靠提前写好的规则解决。这正是AI进入下一阶段的原因。
机器学习:让机器从数据中自己找规律
当规则无法穷举时,思路就变了:不再告诉机器所有答案,而是给它大量数据,让它自己找到隐藏的规律。这就是机器学习。
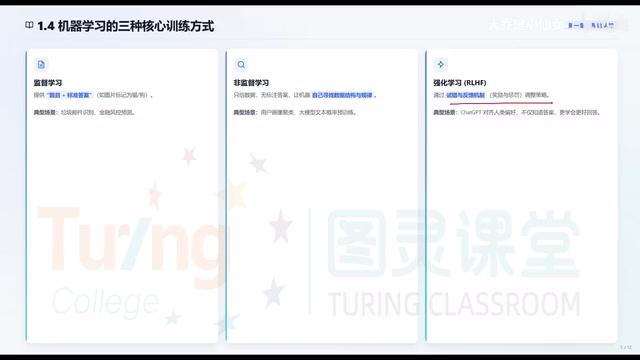
课程把机器学习的经典方式分为三类:
监督学习是给机器题目也给答案。就像学生做数学题,先看大量带解法的例题。识别猫狗时,每张图片都打上标签,模型不断学习图片与标签的关系,最终能对新图片做出预测。垃圾邮件识别、金融风控都在用这种方式。
非监督学习则不提供答案,让机器自己在数据中寻找结构。比如给出大量用户的年龄、浏览习惯、购买记录,模型自行发现哪些用户行为接近、可能属于同一类。大模型训练中也大量借用了这种思想——给模型海量文本,让它预测缺失的内容,从而学习语言规律。
强化学习通过试错和反馈调整行为,类似小朋友学走路:摔倒就调整,成功走一步就获得正向反馈。ChatGPT基础训练后,正是通过人类反馈的强化学习(RLHF)进一步优化回答质量,让模型不仅知道答案,更知道如何更好地回答。
深度学习与Transformer:现代大模型的技术基石
随着图像识别、语音理解、自然语言处理等任务复杂度上升,传统机器学习遇到瓶颈,深度学习应运而生。它的核心是神经网络——受人脑神经连接方式启发的计算模型,把大量计算节点连接起来,信息经过多层处理:第一层学习边缘和颜色,第二层学习形状结构,第三层学习物体组成,层数越多能学到的信息层次越丰富。
深度学习早期也曾遇到问题:网络越深,信息在多层传递中越容易损失。其中一项重要优化是残差连接,让信息可以跨越部分网络层直接传递,这成为现代深度学习模型的重要基础。
真正的转折点来自谷歌的论文《Attention is All You Need》。人类语言的难点在于同一个词在不同上下文含义不同,还包含大量隐藏信息。比如「这个项目太难了」,可能指技术复杂,也可能指推进困难,甚至只是情绪表达。
Transformer提出的注意力机制,让模型在处理一个词时同时关注上下文中相关的信息。以「苹果发布了一款新手机,它受到很多用户欢迎」为例,模型能建立「它」与「苹果手机」的语义关联,而降低对无关词的关注。
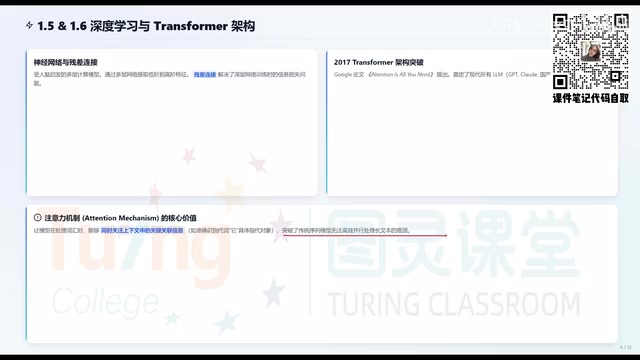
Transformer更大的价值在于处理海量文本。传统循环神经网络在文本过长时前面的内容会被遗忘,而Transformer通过注意力机制同时分析文本的多个部分,让处理更长更复杂的信息成为可能。研究人员由此发现:不断扩大规模、增加数据、提升算力,模型能力会持续增强——这正是大模型爆发的底层逻辑。
残差连接(Residual Connection)由微软研究院在2015年的ResNet论文中提出,核心思想是在网络层之间增加一条"捷径",让输入信号可以绕过若干层直接与该层的输出相加。这解决了深层网络训练中的梯度消失问题——在反向传播时,梯度信号沿捷径通道得以完整传回,使得网络可以堆叠到数百层而不退化。《Attention is All You Need》中的Transformer架构同样采用了残差连接,这是它能够扩展到极大规模(数千亿参数)的重要工程基础之一。
生成式AI与大模型:从判断到创造
回顾整条发展路线(规则→机器学习→深度学习→Transformer),有一个明显变化:过去的AI更多在做分类与判断,而近几年的生成式AI具备了从无到有创造内容的能力。
以前让计算机写作文非常困难,因为它需要理解主题、组织结构、选择表达。现在的大模型(LLM)可以根据简单需求生成完整文章、代码、图片。ChatGPT 3.5的爆发,背后是数据积累、算力跃升和架构突破三重因素叠加,让模型能力从量变走向质变。
课程在实际测试各种大模型应用后得出一个务实判断:大模型目前最适合承担的不是完全替代岗位,而是作为高效助手,帮人完成大量重复性工作,把时间释放到目标设计、决策判断和创造性工作上。就像汽车发明后大多数人不需要研究发动机,而是学会驾驶来提升出行效率。
RLHF(Reinforcement Learning from Human Feedback,基于人类反馈的强化学习)是ChatGPT能够输出符合人类期望答案的关键训练步骤。具体流程是:首先让人类标注者对模型的多个回答进行排序,训练出一个"奖励模型"来打分;再用强化学习算法(如PPO)让语言模型不断优化,争取获得更高奖励分。这一步使模型从"能预测下一个词"跃升到"会按人类偏好组织回答",直接决定了对话体验的友好程度。没有RLHF,大模型可能生成语法正确却答非所问甚至有害的内容。
如何选择大模型与未来方向
课程对主流大模型做了简要梳理:OpenAI的GPT系列影响力最大,覆盖文本生成、代码辅助、数据分析等场景;Claude更注重长文本分析与逻辑推理,写代码的开发者尤其青睐;谷歌Gemini是多模态模型,能处理文字、图片、声音、视频。国内则有阿里开源的通义千问广告、百度文心系列以及DeepSeek广告。
选择大模型没有绝对标准,取决于任务、使用环境和目标:学习整理资料用通用模型即可,程序开发可选Claude或Gemini,企业场景则要额外考虑数据安全、私有部署、成本可控和系统接入。
对未来方向,课程判断有三条主线:模型能力持续增强(推理、代码、多模态);越来越贴近行业细分(金融、法律、医疗领域专用大模型);以及Agent将成为重要应用形式——它不仅能回答问题,还能理解目标、制定计划、调用工具执行任务,形成智能化闭环。比如让它分析公司销售情况,它可以自动读取数据、分析趋势、生成报告并提出建议。
对普通学习者来说,与其纠结底层原理,不如立足现有大模型的通用能力,结合具体业务场景搭建知识库、开发自动化Agent,把这套三阶段路线真正落地。
RAG(Retrieval-Augmented Generation,检索增强生成)是企业落地大模型最常用的技术方案之一,也是课程第二阶段的核心内容。其基本原理是:在模型生成回答之前,先从外部知识库中检索出与问题最相关的文档片段,再将这些片段作为上下文一起送入模型,让模型基于真实、最新的企业数据进行回答,而不只依赖训练时固化的知识。这解决了大模型两个典型缺陷:知识截止日期导致的信息过时,以及对企业私有数据一无所知。医疗智能客服、股票分析等课程推荐的实战场景,几乎都以RAG作为底层架构。
相关推荐
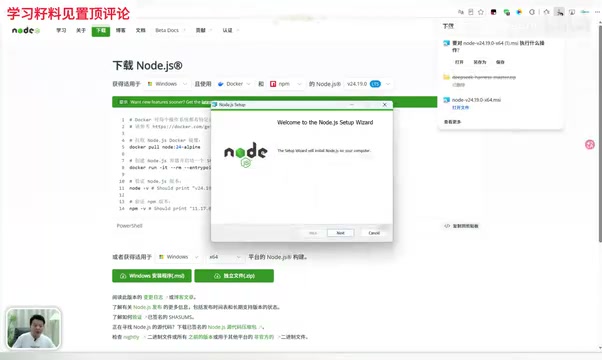
DeepSeek Harness入门:Node.js环境配置与环境变量设置详解
DeepSeek Harness零基础安装教程:详解Node.js环境安装、npm验证、环境变量配置全过程,教你把插件包挡在C盘之外,为大模型办公自动化打好基础。
AI驱动Playwright:智能Agent实现Web与接口自动化测试实战
本文梳理一套 AI + 自动化测试实战路径,涵盖 Playwright Web 自动化、AI 智能体驱动接口测试、Claude Code 驱动 Agent 控制浏览器,以及 Skills 设计与 LLM 评测体系,帮助零基础与进阶学习者构建完整智能测试工具链。
WorkBuddy 实战:用 Skill 技能玩转 AI Agent 办公自动化
WorkBuddy 实战教程:详解 Skill 技能的安装调用,通过 HTML 游戏转 PPT 案例演示 AI Agent 办公自动化,并厘清技能、专家、专家团的区别,适合零基础落地 Excel、Word、PPT 自动化。