免费Cline API测试全过,浏览器打开却是白屏

Cline免费模型后端API全过但前端白屏,暴露AI Agent验证闭环盲区。
本文记录Cline(免费模型)在统一笔记应用评测中的表现:70分钟内产出完整后端,22项API检查与重启持久化全部通过,安全实现优于同系列工具;但浏览器JavaScript因分块写入顺序错乱出现语法错误,界面0/5,用户无法注册登录,README缺失,compose保留弱默认密钥。最终12/20。案例揭示AI Agent的自测闭环仅覆盖自己生成的测试层,无法验证前端渲染,建议人工检查分块文件并让Agent在浏览器中验收UI。
一个尴尬的结局:API完美,界面白屏
在免费的AI编程工具横评中,Cline(注:原文称Klein,应为同一开源VSCode智能体)跑出了系列里最戏剧性的成绩:后端代码质量堪称标杆,22项API检查全部通过,但用户打开浏览器只看到一片空白。
这个案例揭示了一个关键问题:AI Agent能写出通过测试的代码,却可能交付不了一个用户真正能用的产品。测试绿灯不等于产品可用。
测试规则:统一标准下的真实表现
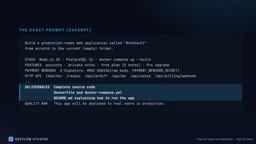
这轮评测使用完全相同的生产级规格:一个笔记应用,包含注册、私有笔记、免费5条笔记额度、付费升级、签名支付Webhook,技术栈为Node 20、Postgres 16,一条命令启动全部服务。
所有工具在同一台笔记本、同一套Docker环境下运行,给相同的提示词,要求交付源码、Dockerfile、compose文件和说明运行方式的README。Cline使用默认免费模型,拥有100万token上下文,全程在项目文件夹内自动编辑文件,命令需人工批准,最多5条追问消息。
此前成绩:GitHub Copilot和Cursor各20/20,Gemini CLI因免费额度在写第一个文件前耗尽而拿到0分。
AI Agent 的“上下文窗口”与“分块写入”机制
上下文窗口指模型单次能处理的最大 token 数(Cline 此处为 100 万),但模型输出长度另有硬上限,通常远小于上下文窗口。当 Agent 需要生成超过输出上限的文件时,会采用“分块写入”:把一个大文件拆成多段依次调用写入工具。问题在于,各段之间没有共享的完整草稿,模型只能依赖前文摘要或重新读取文件来保持连贯。免费模型的输出上限更低、指令遵循更不稳定,因此更容易在分块边界处截断或错序。Cline 在冒烟测试中观察到每块约 6000 字符被截断,改为 3000 字符后缓解,但浏览器代码仍因片段顺序错乱而出现语法错误。这并非 Cline 独有,而是所有依赖多轮写入生成长文件的 Agent 都需面对的工程约束。
70分钟的高光:从零到完整后端
Cline开局先查Express和Postgres驱动的最新版本,约5分钟后开始连续产出文件:package.json、gitignore、dockerignore、配置校验模块、结构化JSON日志、带迁移锁的数据库层、用户/笔记/计费模型,再到HTTP中间件、认证、限流、安全头、CORS、JSON错误处理,最后是路由、服务端和容器编排文件。全部写入磁盘只用了约22分钟。
更难得的是它主动写单元测试,用Node内置测试运行器覆盖配置、校验和核心逻辑,一开始有17个失败,逐条收敛到2个,还处理了Windows下测试输出为UTF-16的怪癖。
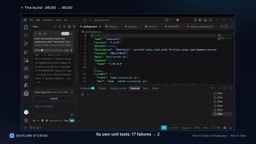
约50分钟后,docker-compose整栈启动,Postgres健康检查通过,应用跑起来。
裂缝出现:分块写入的隐患
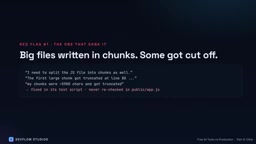
当Cline需要写样式表和浏览器端JavaScript时,它表示文件太大,要拆成小块分段写入。这个细节成为整场问题的伏笔。
在端到端冒烟测试阶段,免费模型开始吃力:请求出现连接重置、首个大块在第80行被截断导致Webhook辅助代码损坏。它最终定位到原因——每块约6000字符会被截断,于是改为每3000字符分段写入,并在每段后校验行数。
约75分钟时,冒烟测试全部通过,包括签名支付Webhook在内的所有端点都能在真实栈上正常工作。
冒烟测试与端到端测试的区别
冒烟测试是一种浅层验证:只确认关键路径“能跑通”,不深入检查分支逻辑或界面渲染。文中 Cline 的冒烟测试覆盖了注册、登录、笔记 CRUD 和签名 Webhook,全部在真实 Docker 栈上通过,说明后端端点可访问且返回预期状态码。但冒烟测试通常不执行浏览器 JavaScript,也不校验 DOM 是否渲染。因此,当浏览器端脚本存在语法错误时,HTTP 层仍返回 200,冒烟测试依然绿灯。这正是“22/22 API 通过、界面 0/5”并存的直接原因:测试层级覆盖了网络与数据层,却遗漏了渲染层。要抓住白屏,需要浏览器自动化或人工打开页面验收。
完美API与零分界面
90分钟时限到达时Cline仍在工作,没有总结,也没有README。作者停止它后自行验证:22项API规范检查22/22通过,重启后登录和笔记数据3/3保留。后端安全性甚至优于前几款工具:密码用脚本级内存硬哈希,会话令牌只存哈希、登出真正删除,注册登录限流,配置缺失或密钥过弱时拒绝启动,Webhook签名常量时间比对并校验金额与币种。
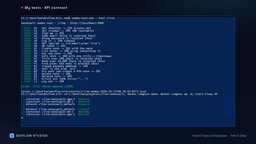
但打开localhost:3000只得到深色空白页。HTML和样式表加载正常,绘制界面的JavaScript却没有执行——文件第200行有语法错误,一个函数嵌套在另一个函数中间。这正是分块写入时片段顺序错乱、Cline又没有回头检查同一文件造成的。要求的README也不存在。
界面检查清单简单直接:应用不加载,无法注册、登录、写笔记或从浏览器升级,0/5。
常量时间比对与 Webhook 签名验证
常量时间比对是一种密码学编程实践:比较两个字节串时,无论在第几位发现不同,都固定耗时遍历全部字节,避免攻击者通过响应时间差逐字节猜测密钥。支付 Webhook 的签名验证尤其需要此特性,因为签名密钥一旦泄露,攻击者可伪造“支付成功”事件。文中 Cline 不仅用常量时间比对验证签名,还额外校验金额与币种,防止重放或篡改。这一细节说明免费模型在后端安全代码生成上已能达到较高水准,与前端渲染失败形成鲜明反差,也提示评测应把安全实现与交付完整性分开计分。
评分与启示
最终得分:API契约10/10,用户界面0/5,重启2/2,无人值守0分(未在时限内完成且应用不可用),合计12/20。
三个红旗值得记录:大文件分块写入被免费模型截断,Cline在测试脚本里发现了却没有发现浏览器代码的问题;README缺交付;compose文件保留了可用于生产的默认Webhook密钥和数据库密码,恰好长到能通过它自己的16字符生产检查。
如果使用Cline搭配免费模型,有三条实用建议:留意“分块写入”提示并亲自检查这些文件;运行检查或直接打开应用再相信结果;在它收尾前要求它在浏览器里打开UI,因为它的API测试抓不到白屏。
这也是AI编程当前的核心矛盾:Agent的自测意识在提升,但验证闭环仍局限于自己写的那一层。后端逻辑它验证得头头是道,前端渲染却无人验收。下一个登场的是浏览器端的Bolt,它能否避开这个陷阱,值得继续观察。
相关推荐
 科技前沿
GitHub日报·11月08日:Agent 基础设施全面开花
Deep dive into 7 new GitHub trending projects today
 科技前沿
Claude新模型Silicon曝光,Opus 5.5被超越?
Anthropic神秘模型Silicon与Obsidian 3在Cognition Devon CLI中曝光,据称超越Opus 5.5;OpenAI的Cactus和Kraken同现构建,Coder平台Koduck疑为Qwen家族。本文梳理周末AI圈关键动向,并解读一项关于视觉输入欺骗机器人的安全研究。
 科技前沿
Claude模型与Effort终极指南:如何省Token
基于8种Claude模型与Effort组合、4个真实编码任务的实测,拆解Haiku、Sonnet、Opus、Fable的定位与价格,解析Effort档位对Token消耗的影响,并给出省Token的实战配置建议。